Megatrend · Climate Adaptation & Water
ก่อนพายุจะมาจริง มันถูกจำลองวิ่งทับบ้านคุณมาแล้วเป็นหมื่นลูก
ทุกครั้งที่บริษัทประกันคิดเบี้ยบ้านริมทะเล หรือรีอินชัวเรอร์ตัดสินใจรับความเสี่ยงพายุทั้งรัฐฟลอริดา เบื้องหลังคือ “สมอง” ที่มองไม่เห็น — โมเดลภัยพิบัติ (catastrophe model) ที่จำลองเฮอริเคน น้ำท่วม และไฟป่านับหมื่นลูกวิ่งทับแผนที่จริง แล้วตอบออกมาเป็นตัวเลขว่า “ความเสียหายต่อปีน่าจะเท่าไหร่” บทเรียนนี้พาไปดูว่า cat model ทำงานยังไง ทำไมตลาดนี้ถูกคุมโดยบริษัทแค่สองราย และทำไม “สมอง” ที่ขายแค่ข้อมูลถึงเป็นธุรกิจที่มีคูเมืองลึกที่สุดจุดหนึ่งของโลกประกัน
01มันคืออะไร
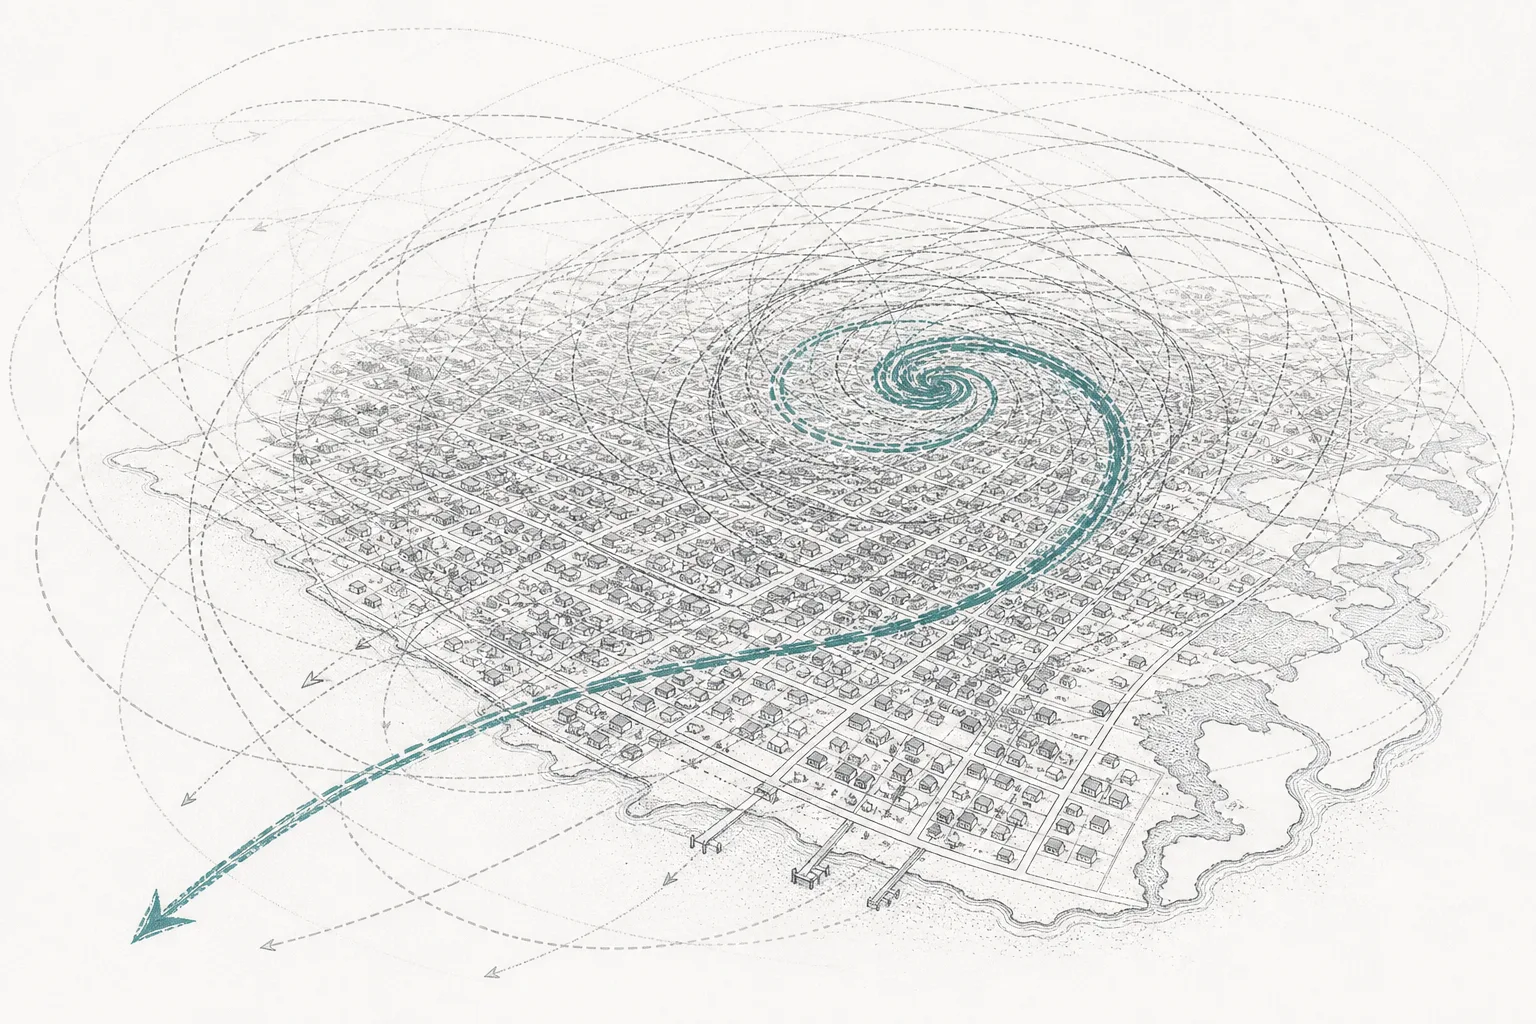
ลองนึกถึงคำถามที่ดูเรียบง่ายแต่ตอบยากมาก: บ้านริมชายฝั่งฟลอริดาหลังหนึ่ง ควรจ่ายเบี้ยประกันปีละเท่าไหร่? คุณจะดูจากอดีตอย่างเดียวไม่ได้ เพราะเฮอริเคนลูกใหญ่ที่สุดอาจยังไม่เคยเกิดในรอบ 100 ปีของข้อมูลที่มี และคุณก็รอให้มันเกิดจริงก่อนค่อยตั้งราคาไม่ได้ด้วย คำตอบของอุตสาหกรรมประกันคือสร้าง “โลกจำลอง” ขึ้นมา — ปล่อยพายุ น้ำท่วม และไฟป่าสมมติวิ่งทับแผนที่จริงนับหมื่นลูก แล้วนับว่าบ้านหลังนั้นเสียหายเฉลี่ยปีละเท่าไหร่ นี่คือหัวใจของ node นี้
node นี้คือธุรกิจของ “สมอง” ที่ประเมินและตั้งราคาความเสี่ยงภัยพิบัติ — บริษัทที่สร้าง catastrophe model (โมเดลภัยพิบัติ หรือเรียกสั้นๆ ว่า cat model) และข้อมูลความเสี่ยงสภาพอากาศ พวกเขาไม่ได้แบกความเสียหายเองเลยสักบาท แต่ขาย “คำตอบ” ให้บริษัทประกัน รีอินชัวเรอร์ และรัฐบาลทั่วโลกเอาไปใช้ตัดสินใจว่าจะ คิดเบี้ยเท่าไหร่ รับความเสี่ยงแค่ไหน และควรสร้าง-ไม่ควรสร้างตรงไหน มันคือชั้น “ข้อมูลและแบบจำลอง” ที่อยู่ใต้ทั้งวงการประกันภัยพิบัติ
ในแผนผังเมกะเทรนด์ node นี้เป็นใบไม้ปลายกิ่ง (leaf) ภายใต้ Climate Risk Analytics & Insurance ในเทรนด์ใหญ่ Climate Adaptation & Water มันคือ “สมอง” ของคู่หู ส่วนพี่น้องข้างกันคือ Property/Casualty & Reinsurance Underwriting — “กระเป๋า” ที่เอาเงินจริงไปแบกความเสี่ยงนั้น สองอย่างนี้ขาดกันไม่ได้ เพราะคนแบกความเสี่ยงต้องพึ่งคนคำนวณความเสี่ยงเสมอ บทเรียนนี้โฟกัสที่ฝั่งสมอง — ถ้าอยากรู้ว่าใครเอาเงินไปแบกและกำไรเป็นวัฏจักรยังไง ให้ตามไปอ่านฝั่งกระเป๋า
Catastrophe model (cat model) = ซอฟต์แวร์จำลองภัยพิบัติที่รันเหตุการณ์สมมตินับหมื่นเพื่อประเมินความเสียหาย · AAL (Average Annual Loss) = ความเสียหายเฉลี่ยที่คาดว่าจะเกิด ต่อปี ในระยะยาว — ตัวเลขนี้คือฐานของการตั้งเบี้ย · PML (Probable Maximum Loss) = ความเสียหายในกรณีเลวร้ายที่ระดับความน่าจะเป็นหนึ่งๆ (เช่น เหตุการณ์ที่เกิดทุก 250 ปี) — ใช้บอกว่าต้องกันทุนสำรองไว้เท่าไหร่ถึงจะไม่ล้ม
02ทำไมถึงสำคัญ — ความเสียหายแสนล้านต่อปี
เหตุผลที่ “สมอง” กลุ่มนี้สำคัญต่อเศรษฐกิจโลก มาจากความจริงข้อเดียวที่ปฏิเสธไม่ได้: ภัยพิบัติกำลังแพงขึ้นเรื่อยๆ และเดิมพันก็ใหญ่ขึ้นทุกปี ปี 2025 ความเสียหายที่ ประกันต้องจ่าย ทั่วโลกอยู่ที่ราว $107,000 ล้าน — เป็นปีที่ หกติดต่อกัน ที่ตัวเลขนี้ทะลุ $100,000 ล้าน กลายเป็น “เพดานปกติใหม่” ของอุตสาหกรรม และเมื่อรวมความเสียหายทางเศรษฐกิจทั้งหมด (ทั้งส่วนที่มีและไม่มีประกัน) ตัวเลขขึ้นไปถึงระดับ $300,000 ล้านต่อปี
เมื่อเดิมพันใหญ่ขนาดนี้ การตั้งราคาความเสี่ยงผิดแม้แต่นิดเดียวก็แปลว่าเงินหายเป็นพันล้าน นี่คือเหตุผลที่ ทุกคนต้องเช่า “สมอง” — บริษัทประกันใช้ cat model ตั้งเบี้ย, รีอินชัวเรอร์ใช้มันตัดสินใจรับความเสี่ยงก้อนใหญ่, หน่วยงานกำกับใช้มันตรวจว่าบริษัทประกันมีทุนพอไหม, และรัฐบาลใช้มันวางแผนรับมือภัยพิบัติ ทั้งหมดพึ่งตัวเลขชุดเดียวกันที่ออกมาจากโมเดลของบริษัทแค่ไม่กี่ราย
จุดที่ทำให้ธุรกิจ “สมอง” น่าสนใจกว่าขนาดตลาด คือมันเป็น คูเมือง (moat) ที่ลึกมาก เพราะโมเดลเหล่านี้ฝังลึกอยู่ในวิธีทำงานของทั้งอุตสาหกรรม — บริษัทประกันสร้างระบบตั้งราคา รายงานต่อหน่วยงานกำกับ และโครงสร้างซื้อรีอินชัวรันส์ทั้งหมดบนผลลัพธ์ของโมเดลตัวใดตัวหนึ่ง การเปลี่ยนโมเดลทีหมายถึงรื้อระบบราคาใหม่ทั้งบริษัท ผลคือเป็นรายได้แบบ สมัครสมาชิก (subscription) ที่นิ่งและคาดเดาได้ — ต่างจากฝั่งกระเป๋าที่กำไรขึ้นลงตามวัฏจักรภัยพิบัติ
03มันทำงานยังไง (เครื่องจำลองภัยพิบัติ)
cat model ไม่ใช่กล่องวิเศษ แต่เป็น สายพาน 4 โมดูล ที่ป้อนต่อกัน เปลี่ยน “ความโกลาหลของธรรมชาติ” ให้เป็นตัวเลขที่ตั้งราคาได้ เข้าใจสี่ขั้นนี้แล้ว เข้าใจทั้งธุรกิจ
ไล่ทีละขั้น (1) Hazard โมเดลสร้าง “ชุดเหตุการณ์สมมติ” (stochastic event set) — เฮอริเคน แผ่นดินไหว ไฟป่า นับหมื่นลูก แต่ละลูกมีเส้นทาง ความแรง และความถี่ของมันเอง อิงฟิสิกส์และสถิติในอดีต (2) Exposure ป้อนข้อมูลว่า “มีอะไรอยู่ตรงไหน” — บ้านแต่ละหลังตั้งอยู่พิกัดไหน มูลค่าเท่าไหร่ สร้างด้วยอิฐหรือไม้ สูงกี่ชั้น เพราะภัยลูกเดียวกันสร้างความเสียหายต่างกันมหาศาลตามสิ่งที่มันไปเจอ
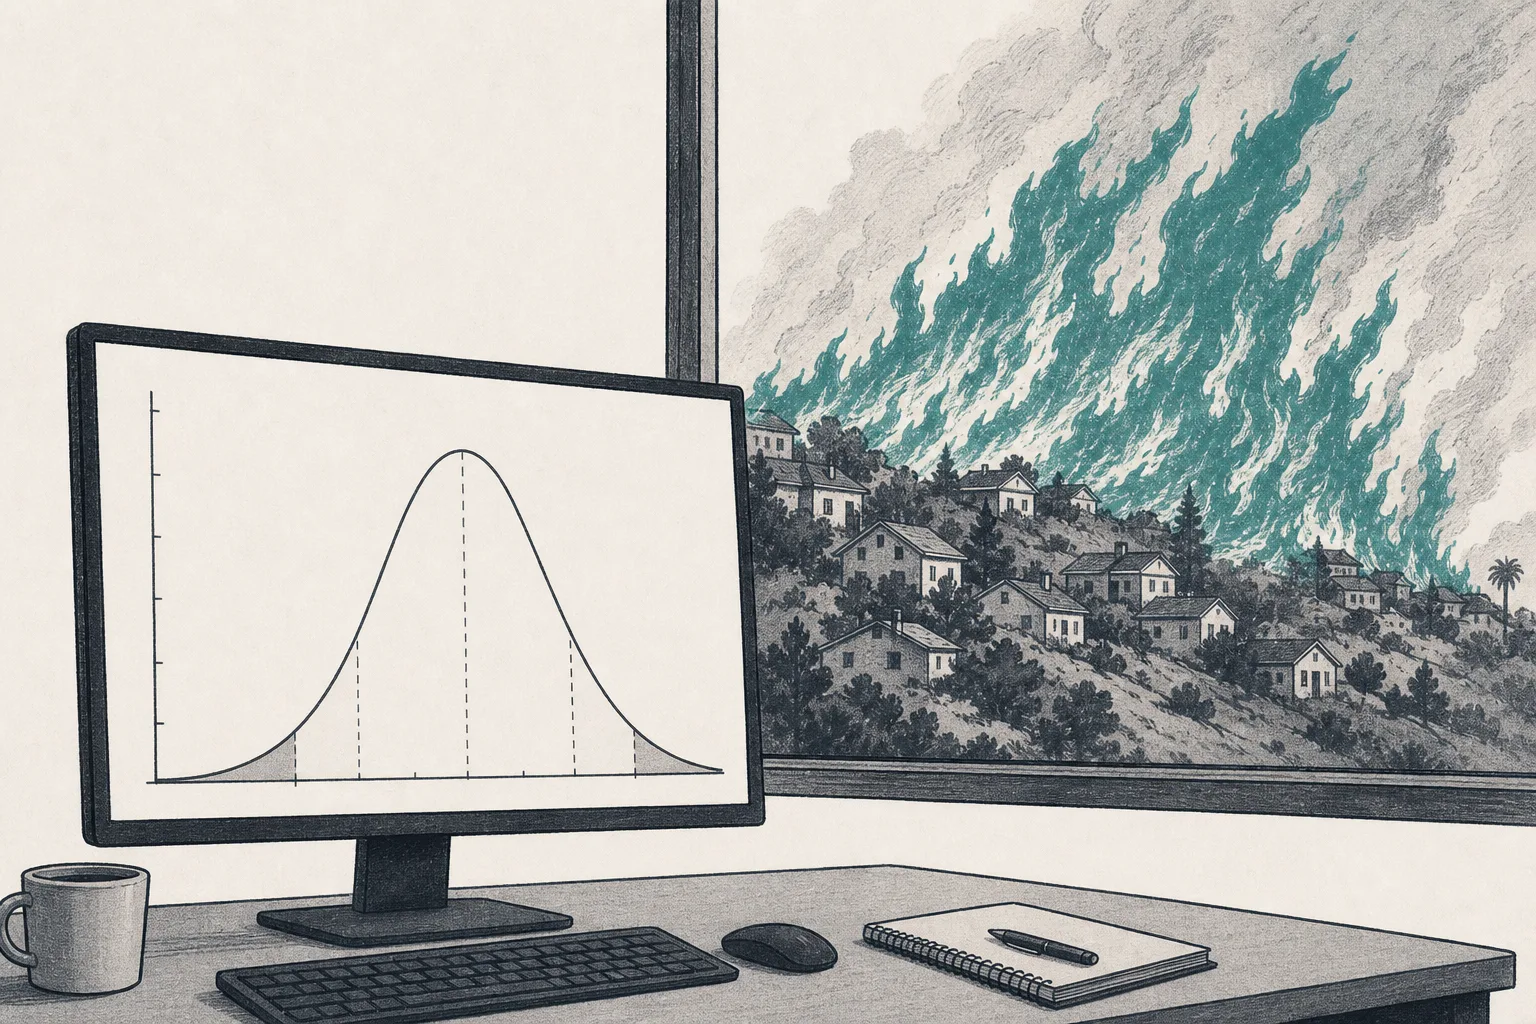
(3) Vulnerability คือหัวใจที่ลอกเลียนยากที่สุด — “damage function” ที่บอกว่าลมความเร็วเท่านี้ทำให้บ้านแบบนี้เสียหายกี่เปอร์เซ็นต์ ความรู้นี้สร้างจากข้อมูลเคลมจริงหลายสิบปี (4) Financial เอาความเสียหายทางกายภาพมาแปลงเป็นเงิน แล้วใส่เงื่อนไขกรมธรรม์ (ค่าเสียหายส่วนแรก เพดานจ่าย สัญญารีอินชัวรันส์) เพื่อบอกว่า “ใครต้องจ่ายเท่าไหร่” สุดท้ายได้ กราฟการกระจายความเสียหาย ที่ค่าเฉลี่ยคือ AAL (เอาไปตั้งเบี้ย) และหางขวาคือ PML (เอาไปกำหนดทุนสำรอง) — สองตัวเลขที่หมุนทั้งวงการประกันภัยพิบัติ
04มันเชื่อมกับอะไรในระบบนิเวศ
node นี้เป็น “ชั้นข้อมูล” ที่นั่งอยู่ใต้ธุรกิจหลายเส้น — มันป้อนตัวเลขให้คนอื่นตัดสินใจ ความสัมพันธ์ที่สำคัญมีดังนี้
- ป้อน “สมอง” ให้ฝั่งรับประกัน P&C & Reinsurance Underwriting โดยตรง: นี่คือความสัมพันธ์ที่แน่นที่สุด — สมองคำนวณความเสี่ยง กระเป๋าเอาตัวเลขนั้นไปตั้งเบี้ยและตัดสินใจรับ ถ้าไม่มีโมเดล รีอินชัวเรอร์ก็ตั้งราคาความเสี่ยงพายุทั้งรัฐไม่ได้เลย
- ใช้ AI Tooling, Data & MLOps และข้อมูลดาวเทียมเป็นวัตถุดิบ: โมเดลรุ่นใหม่ใช้ machine learning จับ “ภัยรอง” ที่ฟิสิกส์ล้วนๆ จับยาก และดูดข้อมูลภาพถ่ายดาวเทียม-เซ็นเซอร์มหาศาลมาทำให้ exposure แม่นขึ้น — ยิ่งข้อมูลดี โมเดลยิ่งมีค่า
- เป็นเครื่องมือวัดผลให้ Climate Adaptation & Water ทั้งเทรนด์: ทุกการลงทุนปรับตัว (สร้างเขื่อนกันน้ำท่วม วางระบบกันไฟป่า) ต้องการตัวเลขว่า “ความเสี่ยงลดลงแค่ไหน” — cat model คือคนตอบ มันจึงเป็นมาตรวัดของทั้งเทรนด์
- ขับเคลื่อนการเงินยุคใหม่: เมื่อความเสี่ยงถูกวัดเป็นตัวเลขแม่นๆ มันก็ถูกแปลงเป็นสินทรัพย์ทางการเงินที่ซื้อขายได้ เช่น cat bond (พันธบัตรภัยพิบัติ) และประกันแบบ parametric ที่จ่ายอัตโนมัติเมื่อข้อมูลภัยถึงเกณฑ์ — เชื่อมไปถึง Digital Finance & Tokenization
05ตอนนี้ไปถึงไหนแล้ว (2025–2026)
เรื่องที่น่าทึ่งที่สุดของวงการนี้คือ การกระจุกตัว — โมเดลภัยพิบัติที่ทั้งโลกใช้ตั้งราคาความเสี่ยง มาจากบริษัทแค่สองรายเป็นหลัก กลายเป็นแทบ “ดูโอโพลี” (ตลาดเจ้าใหญ่สองราย): ฝั่งหนึ่งคือ Verisk ผ่านหน่วย Extreme Event Solutions ซึ่งกลืน AIR Worldwide ผู้บุกเบิกที่สร้างโมเดลภัยพิบัติตัวแรกตั้งแต่ปี 1987 อีกฝั่งคือ Moody’s RMS — Moody’s ทุ่มเงิน $2,000 ล้าน ซื้อ RMS มาในปี 2021 บริษัทประกันแทบทุกเจ้าใช้โมเดลของหนึ่งในสองนี้เป็นมาตรฐาน โดยมี CoreLogic เป็นรายที่สามที่เล็กกว่า
แรงหนุนตอนนี้มาจาก ภัยพิบัติที่จำลองยากขึ้น เมื่อความเสียหายปี 2025 ถึง 92% มาจาก “ภัยรอง” อย่างไฟป่าและน้ำท่วม ซึ่งโมเดลแบบเก่าจับได้ไม่แม่นเท่าเฮอริเคน — บริษัทที่ทำโมเดลภัยรองได้แม่นกว่าจึงได้เปรียบมหาศาล Verisk ทำรายได้รวมทั้งบริษัทราว $3,050–3,080 ล้านในปี 2025 โดยหน่วยโมเดลภัยพิบัติเป็นหนึ่งในเครื่องยนต์การเติบโตหลัก ขณะที่ Moody’s กำลังเร่งฝัง AI เข้าไปในแพลตฟอร์ม RMS เพื่อรับมือภัยรองโดยเฉพาะ
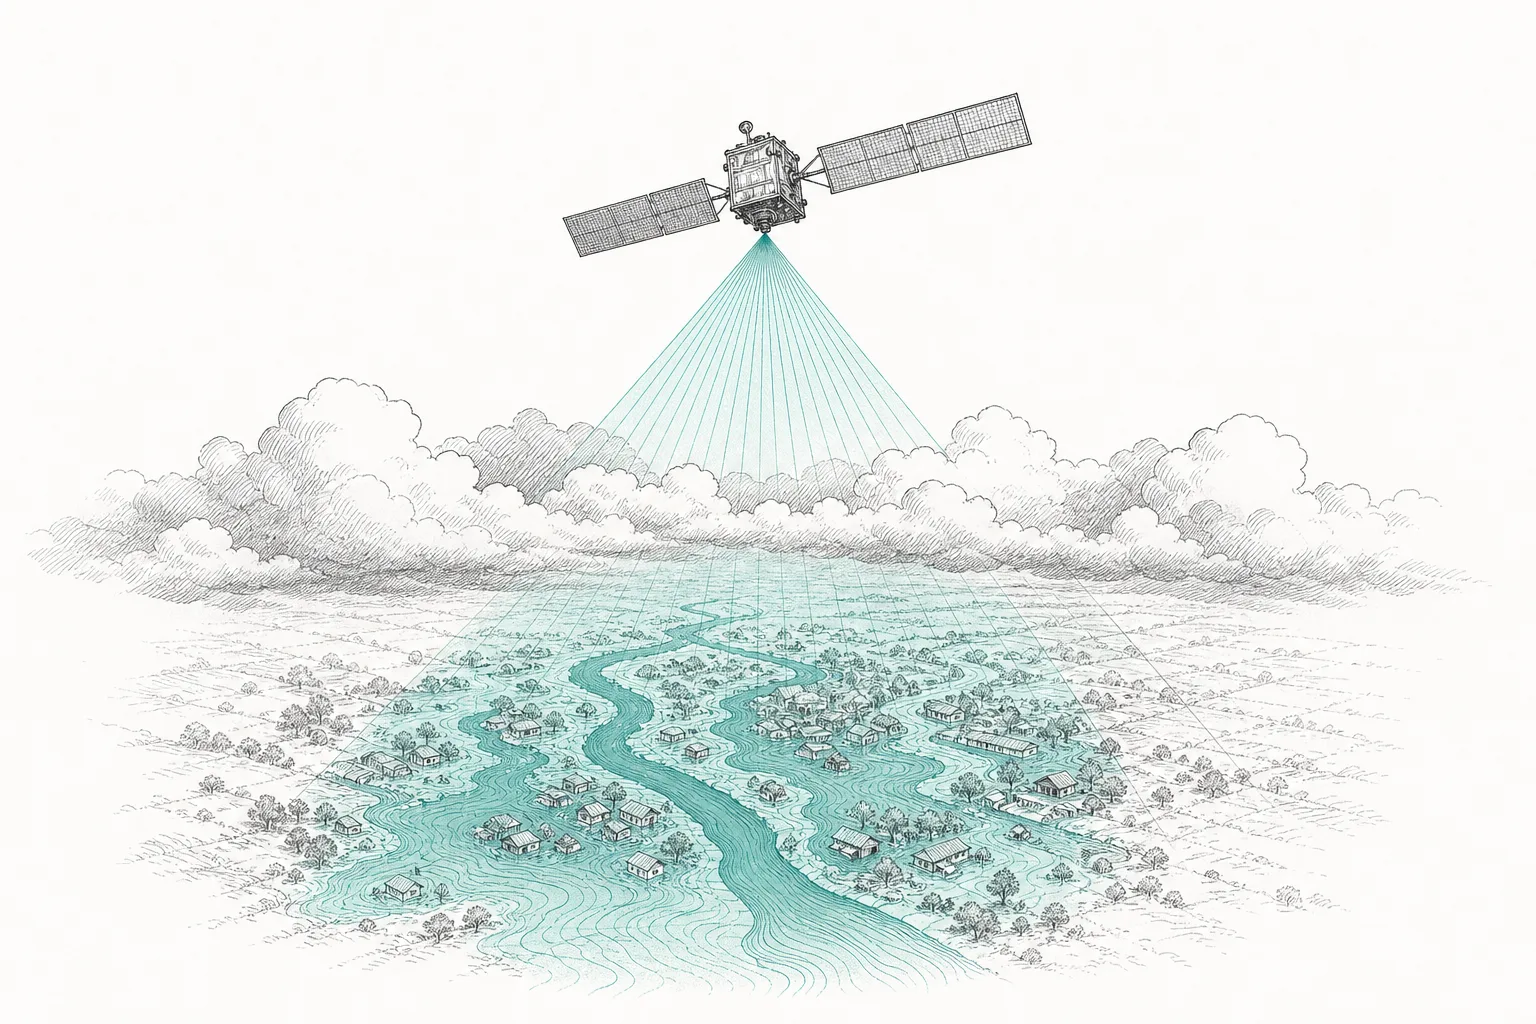
อีกด้านที่กำลังเขย่ากระดานคือ คลื่นผู้เล่นเฉพาะทางหน้าใหม่ ที่ส่วนใหญ่ยังเป็นบริษัทเอกชนไม่อยู่ในตลาดหุ้น — Jupiter Intelligence (ก่อตั้งปี 2016) เน้นวิเคราะห์ความเสี่ยงสภาพอากาศแบบมองอนาคต, ICEYE ใช้ดาวเทียมเรดาร์ (SAR) วัดน้ำท่วมแบบเรียลไทม์ทะลุเมฆ ป้อนข้อมูลให้ประกัน parametric (ปลายปี 2025 จับมือกับหน่วยหนึ่งของ Munich Re), และ CoreLogic ที่แข็งด้านข้อมูลทรัพย์สิน — พวกนี้ไม่ได้แข่งตรงกับสองยักษ์ แต่ไปเติมจุดที่โมเดลแบบเดิมอ่อน
06อนาคตข้างหน้า
ทิศทางแรกคือ โมเดลที่ “มองอนาคต” ไม่ใช่แค่ย้อนอดีต (climate-conditioned) เดิม cat model สร้างจากสถิติเหตุการณ์ในอดีตเป็นหลัก แต่เมื่อสภาพอากาศเปลี่ยนเร็ว อดีตเริ่มไม่ใช่ตัวแทนที่ดีของอนาคต ทั้ง Verisk และ Moody’s RMS จึงเร่งทำโมเดลที่ปรับตามฉากทัศน์โลกร้อนในอนาคต — ใครจำลอง “โลกที่ร้อนกว่าเดิม” ได้แม่นกว่า จะได้เปรียบยาว เพราะลูกค้ายอมจ่ายแพงเพื่อตัวเลขที่เชื่อถือได้
ทิศทางที่สองคือ การพิชิต “ภัยรอง” ด้วย AI และข้อมูลความละเอียดสูง ไฟป่า น้ำท่วมฉับพลัน และพายุฝนฟ้าคะนองคือภัยที่จำลองยากที่สุด เพราะขึ้นกับปัจจัยยุ่งเหยิงระดับท้องถิ่น (เชื้อเพลิง ลม ภูมิประเทศ) นี่คือสมรภูมิที่ machine learning และข้อมูลดาวเทียมความละเอียดสูงกำลังเปลี่ยนเกม — และเป็นช่องที่เปิดให้ผู้เล่นเฉพาะทางอย่าง Jupiter และ ICEYE เติบโตได้แม้ไม่ได้แข่งตรงกับสองยักษ์
ทิศทางที่สามคือ ตลาดใหม่นอกวงการประกัน เมื่อความเสี่ยงสภาพอากาศกระทบทุกคน ลูกค้าของ “สมอง” ก็ขยายออกไปไกลกว่าบริษัทประกัน — ธนาคารต้องประเมินความเสี่ยงสภาพอากาศในพอร์ตสินเชื่อ, กองทุนอสังหาฯ ต้องรู้ว่าตึกไหนเสี่ยงน้ำท่วม, บริษัทใหญ่ต้องเปิดเผยความเสี่ยงต่อนักลงทุนตามกฎใหม่ ทั้งหมดนี้คือดีมานด์ก้อนใหม่ที่ทำให้ตลาดข้อมูลความเสี่ยงสภาพอากาศโตเร็วกว่าตลาดประกันแบบดั้งเดิม
07ความท้าทายและความเสี่ยง
ธุรกิจที่ฟังดูเข้าทาง “ยิ่งโลกร้อนยิ่งได้” กลับมีความเสี่ยงฝังลึกหลายชั้น
ความเสี่ยงข้อแรกและใหญ่ที่สุดคือ “โมเดลผิด” (model risk) โมเดลเก่งกับภัยที่จำลองได้ชัด (เฮอริเคน แผ่นดินไหว) แต่กับภัยรองอย่างไฟป่า ความแม่นยำต่ำกว่ามาก ไฟป่า LA ต้นปี 2025 ที่สร้างความเสียหายประกันถึง ~$40,000 ล้าน — กลายเป็นไฟป่าที่แพงที่สุดในประวัติศาสตร์ — เป็นบทเรียนสะเทือนวงการว่าหลายโมเดลประเมิน “ความเสี่ยงในเขตป่ารอยต่อเมือง” ต่ำเกินไป เมื่อโมเดลพลาด คนแบก (รีอินชัวเรอร์) ขาดทุนหนัก ส่วนคนทำโมเดลก็เสียความน่าเชื่อถือ ซึ่งคือทรัพย์สินเดียวที่พวกเขามี
ความเสี่ยงข้อสองคือ การแข่งขันและ “กล่องดำ” เมื่อตลาดถูกคุมโดยสองยักษ์ ลูกค้าบางส่วนเริ่มอยากได้ทางเลือกและความโปร่งใส — เกิดคลื่นโมเดลแบบเปิด (open model) และผู้เล่นเฉพาะทางที่ท้าทายว่าทำไมต้องเชื่อ “กล่องดำ” ที่ตรวจสอบไม่ได้ ขณะเดียวกัน AI ก็ลดต้นทุนการสร้างโมเดลลง เปิดประตูให้ผู้เล่นหน้าใหม่เข้ามามากขึ้น คูเมืองที่เคยลึกอาจไม่ลึกเท่าเดิม
ความเสี่ยงข้อสามคือ คุณภาพและช่องโหว่ของข้อมูล โมเดลแม่นได้แค่เท่าข้อมูลที่ป้อนเข้าไป — ในตลาดเกิดใหม่ที่ข้อมูลทรัพย์สินและประวัติภัยมีน้อย โมเดลก็อ่อนตาม และเมื่อสภาพอากาศเปลี่ยนเร็วกว่าที่ข้อมูลในอดีตจะตามทัน ความไม่แน่นอนก็สูงขึ้น “ความเชื่อมั่นเกินจริงในตัวเลขทศนิยม” อาจอันตรายกว่าการยอมรับว่าไม่รู้
สรุปสั้นๆ: node นี้คือชั้นที่เงียบที่สุดแต่ทรงอิทธิพลที่สุดของโลกประกันภัยพิบัติ — มันเปลี่ยน “ความโกลาหลของธรรมชาติ” ให้เป็นตัวเลขที่ทั้งโลกใช้ตัดสินใจว่าจะคิดเบี้ยเท่าไหร่และสร้างตรงไหน ยิ่งภัยพิบัติแพงและจำลองยากขึ้นเท่าไหร่ “สมอง” ที่คำนวณมันได้แม่นที่สุดก็ยิ่งมีค่ามากขึ้นเท่านั้น