Megatrend · Artificial Intelligence
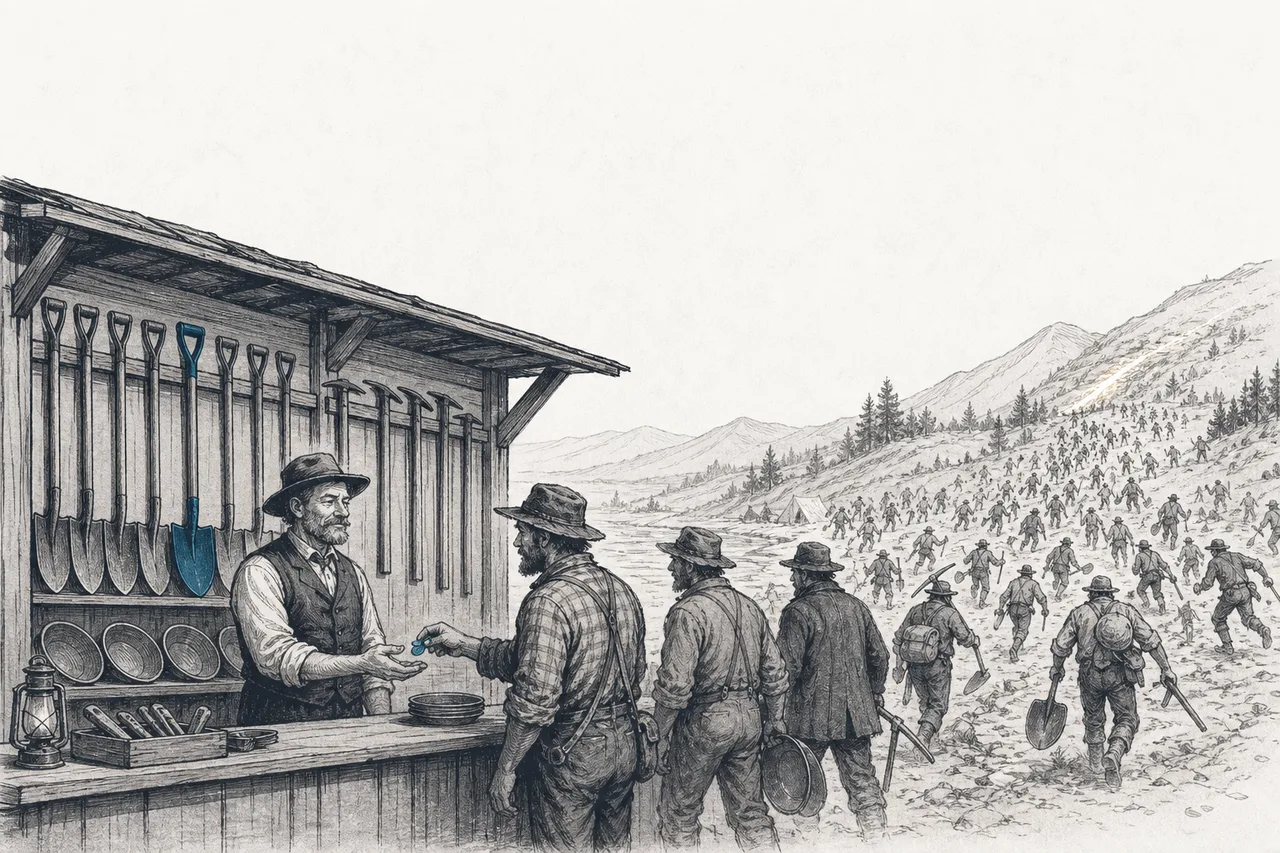
ในยุคตื่นทอง คนที่รวยจริงคือคนขายพลั่ว
ทุกคนจ้องดูว่าโมเดล AI ตัวไหนจะชนะ — GPT, Gemini, Claude, หรือ Llama แต่ใต้โมเดลพวกนั้นมี “ชั้นซอฟต์แวร์” ที่เงียบกว่ามาก ทำหน้าที่เตรียมข้อมูล ฝึกโมเดล เอาไปรันจริง และคอยเฝ้าดูว่ามันเพี้ยนไหม นี่คือ “พลั่วและจอบ” ของยุคตื่นทอง AI — ธุรกิจที่เก็บเงินได้ไม่ว่าโมเดลตัวไหนจะชนะ และเป็นที่ที่บริษัทอย่าง Databricks กับ Scale AI กลายเป็นยักษ์มูลค่าหลายหมื่นล้านดอลลาร์โดยที่คนทั่วไปแทบไม่รู้จักชื่อ
01มันคืออะไร (ชั้น “พลั่ว” ของ AI)
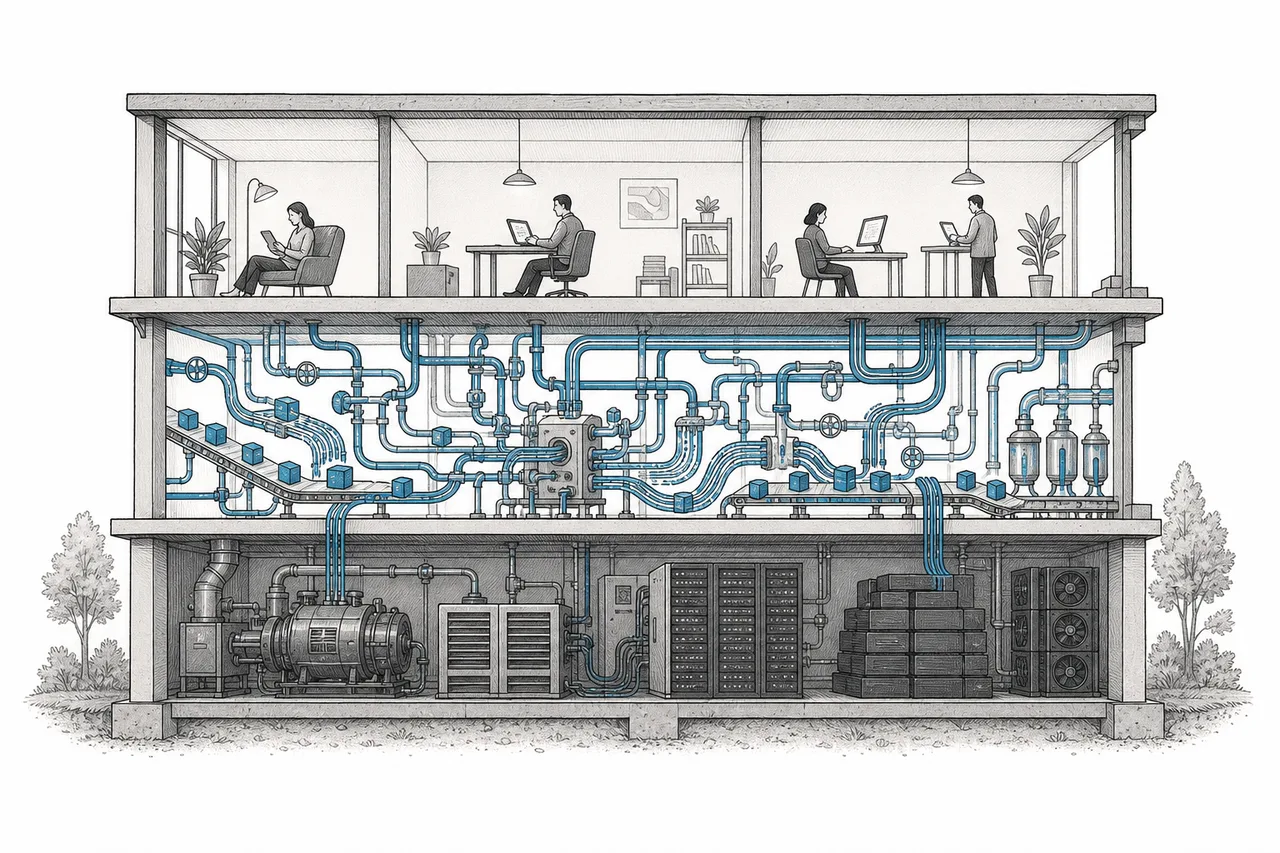
เวลาเราพูดถึง AI เรามักนึกถึง “โมเดล” — ก้อนสมองอย่าง GPT หรือ Gemini แต่โมเดลตัวเปล่าๆ ก็เหมือนเครื่องยนต์ที่วางอยู่บนพื้นโรงงาน มันยังขับรถไม่ได้ ต้องมีระบบรอบๆ อีกมหาศาลกว่าจะทำให้มันทำงานจริงในธุรกิจ — และ “ระบบรอบๆ” นั่นแหละคือ node นี้
node นี้เป็นสาขาย่อยภายใต้เมกะเทรนด์ Artificial Intelligence นิยามของมันสั้นแต่ตรง: “ชั้นข้อมูลและการปฏิบัติการที่ใช้ฝึก รัน ควบคุม และเฝ้าดู AI — ซอฟต์แวร์ประเภทพลั่วและจอบ” พูดอีกแบบคือ มันคือทุกอย่างที่อยู่ ใต้ โมเดล ไม่ใช่ตัวโมเดลเอง แบ่งได้เป็นสี่ก้อนใหญ่:
- ข้อมูล (Data): เตรียม ทำความสะอาด และ “ติดป้าย” ข้อมูลให้โมเดลเรียนรู้ได้ — บริษัทอย่าง Scale AI ทำเรื่องนี้ บวกกับแพลตฟอร์มข้อมูลขนาดใหญ่อย่าง Databricks และ Snowflake
- การจัดเก็บเพื่อค้นคืน (Retrieval): ฐานข้อมูลแบบใหม่ที่เรียกว่า vector database (เช่น Pinecone) ที่ช่วยให้ AI “ค้นความจำ” เจอข้อมูลที่ตรงประเด็น — หัวใจของเทคนิคยอดฮิตชื่อ RAG
- การนำไปใช้ (Deploy & Serve): เอาโมเดลที่ฝึกเสร็จไป “รันจริง” ให้ผู้ใช้นับล้านเรียกได้พร้อมกัน เร็วและถูก
- การเฝ้าดู (Observability & Eval): คอยจับตาว่าโมเดลตอบถูกไหม แพงไปไหม เริ่มเพี้ยนหรือยัง — บริษัทอย่าง Datadog กำลังบุกหนักด้านนี้
MLOps (Machine Learning Operations) = วิธีคิดและเครื่องมือที่เอาแนวทางของวงการซอฟต์แวร์ (อัตโนมัติ ทำซ้ำได้ ตรวจสอบได้) มาใช้กับการ “ผลิตและดูแลโมเดล AI” ให้เป็นระบบ ไม่ใช่งานมือ · LLMOps คือเวอร์ชันที่เจาะจงกับโมเดลภาษาขนาดใหญ่ (LLM) ซึ่งมีปัญหาเฉพาะตัว เช่น ตอบมั่ว (hallucination) และค่าโทเคนที่แพง
สรุปง่ายๆ: ถ้า Foundation Models คือ “เครื่องยนต์” node นี้คือ “สายการประกอบ ระบบเชื้อเพลิง และห้องควบคุม” ที่ทำให้เครื่องยนต์นั้นวิ่งบนถนนจริงได้
02ทำไม “ขายพลั่ว” ถึงดีกว่า “ขุดทอง”
มีคำพังเพยเก่าจากยุคตื่นทองแคลิฟอร์เนีย: “ตอนตื่นทอง คนที่รวยที่สุดไม่ใช่นักขุด แต่เป็นคนขายพลั่ว” เพราะนักขุดส่วนใหญ่กลับบ้านมือเปล่า แต่ทุกคนต้องซื้อพลั่ว — และนี่คือวิทยานิพนธ์การลงทุนทั้งหมดของ node นี้
ในศึกโมเดล AI ตอนนี้ ไม่มีใครรู้ว่าสุดท้าย GPT, Gemini, Claude หรือโมเดลโอเพนซอร์สจะชนะ การเดิมพันกับโมเดลตัวใดตัวหนึ่งจึงเสี่ยงมาก แต่ ไม่ว่าโมเดลตัวไหนจะชนะ ทุกตัวก็ต้องใช้ข้อมูลที่ติดป้ายมาดี ต้องเอาไปรันที่ไหนสักแห่ง และต้องมีคนเฝ้าดู ชั้นพลั่วนี้จึงเก็บเงินได้จาก “ทั้งสนาม” ไม่ใช่แค่ผู้ชนะ
ขนาดของชั้นพลั่วนี้กำลังโตเร็วกว่าตลาดเกือบทุกอย่าง ตลาด MLOps โดยเฉพาะถูกประเมินว่าจะโตจากราว $2,200 ล้านในปี 2024 ไปแตะ ~$16,600 ล้านในปี 2030 หรือโตเฉลี่ยปีละกว่า 40% ขณะที่ตลาดโครงสร้างพื้นฐาน AI โดยรวม (ฮาร์ดแวร์+ซอฟต์แวร์) แตะระดับแสนล้านดอลลาร์ไปแล้วในปี 2026
เหตุผลที่ตลาดนี้ระเบิดมาจากความจริงข้อหนึ่งที่บริษัทเพิ่งเรียนรู้กันเจ็บๆ: การทำเดโม AI ให้ดูเท่ในห้องประชุมนั้นง่าย แต่การเอามันไปรันจริงให้เสถียร ปลอดภัย และไม่เผาเงิน นั้นยากมาก ช่องว่างระหว่าง “เดโมที่ work” กับ “ระบบที่ใช้ได้จริง” คือที่ที่ชั้นพลั่วนี้ทำเงิน
03มันทำงานยังไง — วงจร MLOps
หัวใจของ node นี้คือสิ่งที่เรียกว่า “วงจร MLOps” — มันไม่ใช่เส้นตรงที่ทำครั้งเดียวจบ แต่เป็น วงกลม ที่หมุนไม่หยุด เพราะโมเดล AI ไม่เหมือนซอฟต์แวร์ทั่วไป มันเสื่อมตามเวลา (โลกเปลี่ยน ข้อมูลใหม่เข้ามา) จึงต้องวนกลับมาฝึกใหม่เรื่อยๆ
เดินทีละขั้น: (1) ข้อมูล คือจุดเริ่ม — โมเดลจะดีแค่ไหนขึ้นอยู่กับข้อมูลที่ป้อน ขั้นนี้คือการเก็บ ทำความสะอาด และ “ติดป้าย” (บอกว่ารูปนี้คือแมว ประโยคนี้สุภาพ ฯลฯ) ซึ่งเป็นงานที่ Scale AI ทำเป็นล้านชั่วโมงคน · (2) ฝึกโมเดล คือเอาข้อมูลไปสอนหรือ “จูน” โมเดล พร้อมจดบันทึกการทดลองทุกรอบว่าตั้งค่าแบบไหนได้ผลดีสุด · (3) นำไปรันจริง คือเสิร์ฟโมเดลให้ผู้ใช้เรียกได้ รวมถึงเทคนิค RAG ที่ดึงข้อมูลจริงมาเสริมก่อนตอบ · (4) เฝ้าดู คือคอยจับว่าโมเดลตอบช้าลงไหม แพงขึ้นไหม เริ่มมั่วไหม
หัวใจอยู่ที่ ลูกศรสีเด่น ในแผนภาพ — สิ่งที่ขั้น “เฝ้าดู” เห็น จะถูกป้อนกลับไปเป็นข้อมูลรอบใหม่ ทำให้ทั้งวงหมุนต่อ นี่คือสิ่งที่ทำให้ AI ในการผลิตจริงไม่เหมือนโปรเจกต์ที่ทำครั้งเดียวจบ มันคือ “สิ่งมีชีวิต” ที่ต้องเลี้ยงดูต่อเนื่อง — และทุกขั้นในวงนี้คือสินค้าที่บริษัทในชั้นพลั่วขายได้
RAG (Retrieval-Augmented Generation) = เทคนิคที่ก่อนให้ AI ตอบ จะ “ค้น” เอกสารจริงที่เกี่ยวข้องมาแปะให้ก่อน เพื่อลดการตอบมั่วและให้อ้างอิงข้อมูลล่าสุดของบริษัทได้ · Vector database = ฐานข้อมูลแบบใหม่ (เช่น Pinecone) ที่เก็บข้อมูลเป็น “พิกัดความหมาย” ทำให้ค้นเจอสิ่งที่ ความหมายใกล้กัน ไม่ใช่แค่คำตรงกัน — เป็นเครื่องมือหลักที่ทำให้ RAG ทำงานได้
04มันเชื่อมกับอะไรในระบบนิเวศ AI
node นี้นั่งอยู่ตรง “ชั้นกลาง” ของกองซ้อน AI — มันรับของจากชั้นล่าง และส่งของให้ชั้นบน:
- ป้อนและรับจาก Foundation Models: เครื่องมือชุดนี้คือสิ่งที่แล็บโมเดล (OpenAI, Anthropic, Google) ใช้ฝึกและจูนโมเดล ขณะเดียวกันโมเดลที่ออกมาก็ต้องวิ่งบนชั้นเครื่องมือนี้เพื่อไปถึงผู้ใช้ — สองชั้นนี้ผูกกันแน่น
- เป็นฐานให้ AI Applications & Copilots: ทุกแอป AI ที่บริษัทสร้าง (ผู้ช่วยตอบลูกค้า, copilot ในซอฟต์แวร์) ตั้งอยู่บนชั้นข้อมูล+เครื่องมือนี้ ถ้าไม่มี vector database และ MLOps แอปพวกนั้นก็สร้างไม่ได้
- เป็นกระดูกสันหลังของ Agentic AI: AI ที่ทำงานเองหลายขั้น (agent) ยิ่งต้องการการเฝ้าดูและ eval หนักกว่าเดิม เพราะมันตัดสินใจเองได้ — ความผิดพลาดจึงลามไกลกว่า
- พึ่ง Cloud & Digital Infrastructure: เครื่องมือพวกนี้รันบนคลาวด์เป็นหลัก และคลาวด์ยักษ์ใหญ่เองก็กำลังกลืนชั้นนี้เข้าไปเป็นบริการของตัวเอง — เป็นทั้งคู่ค้าและคู่แข่ง
- จุดชนวนดีมานด์ พลังงานและไฟฟ้า + วัตถุดิบสำคัญ: การฝึกและรันโมเดลกินไฟและชิปมหาศาล ชั้นนี้จึงเป็นต้นทางที่ดันดีมานด์พลังงานทั้งสายโซ่
วิธีจำง่ายๆ: ถ้าไล่กองซ้อน AI จากล่างขึ้นบน — ชิปและคลาวด์อยู่ล่างสุด, โมเดลอยู่ตรงกลาง, แอปอยู่บนสุด — node นี้คือ “ปูนและท่อ” ที่เชื่อมทุกชั้นเข้าด้วยกัน ทำให้ข้อมูลไหลและโมเดลทำงานได้จริง มันจึงเป็นหนึ่งใน node ที่ เชื่อมกับเทรนด์อื่นมากที่สุด ในทั้งแผนผัง
05ตอนนี้ไปถึงไหนแล้ว
ปี 2026 คือปีที่ชั้นพลั่วนี้พิสูจน์ตัวเองด้วย “เงินจริง” ไม่ใช่แค่คำสัญญา ดูจากผู้นำสองรายในชั้นข้อมูล: Databricks (บริษัทเอกชน แพลตฟอร์มข้อมูล+AI) ทำรายได้แตะระดับ $5,400 ล้านต่อปี โต 65% และเฉพาะรายได้จากผลิตภัณฑ์ AI แตะ $1,400 ล้าน (~26% ของทั้งหมด) จนถูกประเมินมูลค่าล่าสุดในการระดมทุนสูงถึง $134,000 ล้าน และมีข่าวว่ากำลังคุยรอบใหม่ที่ $165,000–175,000 ล้าน
ฝั่งบริษัทมหาชน Snowflake (SNOW) ทำรายได้ผลิตภัณฑ์ทั้งปีงบ 2026 ที่ $4,720 ล้าน และมีลูกค้ากว่า 9,100 รายที่เริ่มใช้ฟีเจอร์ AI ของมัน (Cortex) — สะท้อนว่าองค์กรกำลังย้าย AI เข้าไปทำงานติดกับข้อมูลของตัวเอง ไม่ใช่แค่เล่นกับ chatbot
ที่น่าสังเกตคือ ผู้เล่นตัวจริงหลายรายในชั้นนี้ยังเป็นบริษัทเอกชนที่ไม่ได้อยู่ในตลาดหุ้น — ทั้ง Databricks, Scale AI และ Pinecone ล้วนเป็นบริษัทเอกชนมูลค่าสูง ทำให้คนทั่วไปลงทุนตรงได้ยาก เราจึงจัดวางผู้เล่นด้านล่างตาม บทบาทในวงจร MLOps และส่วนแบ่งความเป็นผู้นำ มากกว่ามูลค่าตลาดดิบ เพื่อให้เห็นว่าใครคุมส่วนไหนของชั้นพลั่วนี้จริงๆ
06อนาคตข้างหน้า
ทิศทางแรกคือ RAG และ vector database จะกลายเป็นมาตรฐาน เพราะองค์กรไม่อยากให้ AI ตอบมั่ว และอยากให้มันอ้างอิงข้อมูลภายในของตัวเองได้ ตลาด RAG ถูกประเมินว่าจะโตจากราว $2,300 ล้านในปี 2025 ไปไกลถึงระดับหลายหมื่นล้านดอลลาร์ในทศวรรษหน้า ด้วยอัตราโตเฉลี่ยกว่า 40% ต่อปี — เป็นหนึ่งในหมวดที่โตเร็วที่สุดของชั้นพลั่ว
ทิศทางที่สองคือ การเลื่อนน้ำหนักจาก “ฝึก” ไป “รันและเฝ้าดู” ช่วงแรกเงินทุ่มไปที่การฝึกโมเดลใหญ่ๆ แต่เมื่อ AI เริ่มถูกใช้งานจริงในวงกว้าง น้ำหนักจะย้ายไปที่ขั้น “รันจริง” (inference) และ “เฝ้าดู” ซึ่งเกิดทุกวันตลอดเวลา — นี่คือเหตุผลที่บริษัท observability อย่าง Datadog ถึงตื่นเต้นกับ AI มาก เพราะทุกการเรียกใช้โมเดลคือสิ่งที่ต้องถูกวัดและเฝ้าดู
ทิศทางที่สามคือ เครื่องมือสำหรับ Agentic AI เมื่อ AI เริ่มทำงานเองหลายขั้น (จองตั๋ว เขียนโค้ด ประสานงาน) การ “ติดตามว่ามันทำอะไรไปบ้าง” และ “ทดสอบว่ามันเชื่อถือได้แค่ไหน” จะกลายเป็นชั้นเครื่องมือใหม่ทั้งชั้น ที่ยังไม่มีผู้ชนะชัดเจน — เป็นสนามเปิดที่ยังจับจองได้
07ความท้าทายและความเสี่ยง
เสน่ห์ของ “คนขายพลั่ว” มาพร้อมความเสี่ยงที่เฉพาะตัว และข้อใหญ่ที่สุดคือ การถูกกลืน (consolidation)
ปัญหาคือ ชั้นพลั่วนี้เต็มไปด้วยสตาร์ตอัปเครื่องมือเล็กๆ จำนวนมาก แต่ลูกค้าองค์กรไม่อยากซื้อเครื่องมือ 20 ตัวจาก 20 บริษัท พวกเขาอยากได้ “แพลตฟอร์มเดียวจบ” ผลคือยักษ์ใหญ่ — โดยเฉพาะคลาวด์อย่าง AWS, Azure, Google และผู้ให้บริการ AI cloud — กำลังกวาดซื้อหรือลอกฟีเจอร์ของเครื่องมือเล็กเข้าไปเป็นบริการของตัวเอง
ความเสี่ยงข้อสองคือ คูเมืองตื้น (thin moat) เครื่องมือบางอย่างในชั้นนี้ลอกเลียนได้ไม่ยาก โดยเฉพาะหลังจากผู้ใช้เข้าใจว่ามันทำอะไร vector database เป็นตัวอย่าง — ตอนแรกถูกมองว่าเป็นเทคโนโลยีล้ำ แต่ไม่นานฐานข้อมูลเดิมๆ (PostgreSQL, MongoDB, Oracle) ก็เพิ่มความสามารถนี้เข้าไป ทำให้ผู้บุกเบิกต้องแข่งกับของฟรีที่ “ติดมากับฐานข้อมูลที่ลูกค้ามีอยู่แล้ว”
ความเสี่ยงข้อสามคือ การพึ่งบูม AI รายได้ที่โตพรวดของชั้นนี้ผูกกับการที่ทั้งโลกกำลังเทเงินลงทุนใน AI อย่างมหาศาล ถ้าวงจรการลงทุน AI ชะลอ — หรือถ้าผลตอบแทนจาก AI ในองค์กรออกมาน่าผิดหวัง — ดีมานด์เครื่องมือพวกนี้ก็จะชะลอตาม กรณีของ Scale AI ที่ลูกค้าบางรายถอยหลังดีล Meta ก็เตือนว่า แม้แต่ผู้นำก็มีจุดเปราะของตัวเอง (ในกรณีนี้คือ การพึ่งลูกค้าน้อยรายและประเด็นความลับข้อมูล)
สรุปสั้นๆ: ในตำนานยุคตื่นทอง คนขายพลั่วคือคนที่รวยอย่างเงียบๆ และมั่นคงที่สุด ชั้นข้อมูล+เครื่องมือ+MLOps ของ AI ก็เล่นบทเดียวกัน — มันไม่หวือหวาเท่าตัวโมเดล แต่มันคือที่ที่ “เงินจริง” ไหลผ่านทุกวัน ไม่ว่าการตื่นทองรอบนี้จะจบลงด้วยใครเจอทอง