メガトレンド · Brain-Computer Interface
脳は何百万チャンネルもの“ざわめき”を発する——それを意味に翻訳するのは誰か
Neuralink や Synchron の「脳に埋め込むチップ」と聞くと、つい埋め込むハードウェアの方を思い浮かべます。でも本当にいちばん難しいのは——そして競合をはね返す本物の堀になるのは——何千個もの神経細胞から届く、ぐちゃぐちゃの電気信号を“意図”へと翻訳するソフトウェアの方。発話も、カーソルの移動も、ロボットアームの操作も、ここを通ります。この node は BCI の「脳みそ」にあたる層です——AI を使う decoder(デコーダー)と、どの回路が何を担うのかを描き出す脳マッピングの道具。AI と神経科学がちょうど出会う場所なんです。
01これは何?
想像してみてください。三万人が一斉に叫んでいるサッカー場の真ん中に立たされて、「12列7番のおばさんが何を言っているか聞き取って」と言われる——BCI のシステムが1ミリ秒ごとに解いているのは、まさにこの問題です。私たちの脳には860億ほどの神経細胞があり、いつも電気信号をやり取りしています。そこに電極を埋め込んでも、「命令」が文字で届くわけではありません。届くのは何千ものチャンネルから入り混じった、ごちゃごちゃの電気信号です。
この node——Neural Signal Processing & Brain-Mapping Tools——は、その生の信号を意味のあるものに変えるソフトウェアと道具の層です。メガトレンド Brain-Computer Interface の下にある一分野で、「infrastructure(基盤)」の層に位置します。つまり、脳に埋め込むタイプ(invasive)でも、頭の外に貼るタイプ(non-invasive)でも、すべての BCI が頼らざるをえない土台です。中身は、絡み合った大きな2つのパートに分かれます。
- 信号処理 + デコーダー(decoder): 信号をきれいにし、どの細胞がいつ発火したかを切り分け(spike-sorting)、どんな波形のパターンが何の意図にあたるかを Machine Learning で学習するソフトウェア。これが「翻訳役」です
- 脳マッピングの道具(brain-mapping): 高密度プローブ(たとえば Neuropixels)、二光子顕微鏡、そして MRI/connectomics。どの回路が何を担うのかという「地図」をつくる道具です——誰かが道路を敷く前に、まずその土地を測量するようなものなんです
「神経細胞の発火パターン」と「ユーザーが本当にやりたいこと」——たとえばカーソルを右に動かしたい、あるいは「水」と言いたい——の対応を学習する、数学・AI のモデル。あらゆる BCI の心臓部であり、いちばん真似しにくい部分でもあります。なぜなら、膨大な量の本物の脳データで訓練しないといけないからです。
ここでよく誤解されがちな大事な点を一つ。この node の定義をよく見ると、BCI はこの市場のほんの一角でしかありません。市場の大部分は、大学や製薬会社に売る神経科学の研究用機器の方なんです——そちらはもう今日きちんと稼いでいる市場。いっぽう BCI 側はまだ始まったばかりです。
02なぜ重要か——これは BCI の「脳みそ」
この話をいちばんうまく言い表した一文があります——ハードウェアは目に見えるもの、でもアルゴリズムこそが“買っているもの”だ。
Neuralink が電極を何千本も載せたチップを発表すると、みんなチップ本体に沸きます。でも実際は、電極をたくさん埋めて大量のデータが取れたとしても——生のまま素朴に decode すると、発話のタスクでエラー率は約40%にも達する。これでは実用になりません。使えるレベルにしたのは、十分に賢い「翻訳役」でした。2025年5月、Neuralink は大規模言語モデル(xAI の Grok)まで持ち込んで単語の推測を助けさせ、限られた語彙でのエラー率を10%未満まで下げたんです——要するに、generative AI が脳のデコード現場で本当に働き始めた、ということ。
市場規模の話は、はっきり分けて見る必要があります。神経科学の研究用機器全体(機器・脳イメージング・試薬を含む)は、2026年で約410億ドルの大きさで、2031年には約550億ドルへ伸びると見られています(CAGR 約6%)。なかでも熱く伸びているのは脳マッピングの道具と専門の顕微鏡で、年に10〜13%ほどの成長です——ここが「今日お金になる」部分。いっぽう BCI のデコーダー側は、まだ未来への投資という段階です。
03どう動くのか——ノイズから意図へ
信号がたどる道のりを追ってみましょう。まだただの“ごちゃごちゃの電気信号”だったところから、画面に「こんにちは」という言葉が出るまで。大きく4つの関所があります。
第一の関所は生信号——ノイズだらけのボケた写真のようなもの。第二の関所が spike-sorting:コンピューターが波形を見て、「このスパイクは細胞 A から? それとも B から?」を判定します。いまは Kilosort4(2024年末からデフォルトになりました)のような標準ソフトが、これを自動でこなします。第三の関所が decoder——どんな発火パターンが何を意味するかを学習する ML モデル。そして第四の関所が結果:発話、カーソル、あるいはロボットアームへの指令です。
神経細胞は「スパイク」——短い電気パルス——で会話します。1本の電極が近くの複数の細胞を同時に拾うと、信号は混ざってしまう。spike-sorting は、その一つひとつのパルスがどの細胞から来たのかを切り分ける作業です。みんなが同時に話している会議の録音を起こして、どの発言が誰のものかを言い当てる——そんなイメージです。
イメージしやすい数字を一つ。2025年の研究では「言おうとした言葉」を毎分62語で decode できました——従来の記録の3.4倍の速さで、自然な会話の速度(毎分約160語)にも近づいてきています。エラー率は50語の語彙では9.1%。ところが、12万5,000語のフル辞書を開くと23.8%まで跳ね上がります——この一組の数字が、大事な真実を語っています。狭いお題ではもう得意。でも、開かれたお題ではまだ仕事が山ほど残っている、ということ。
04もう半分:脳マッピングの道具
decoder が賢くなれるのは、「どの回路が何を担うか」を先に知っているときだけ——そしてそれが、脳マッピングの道具の仕事です。シンプルに言えば、脳の Google マップ。ナビできるようになる前に、まず誰かが出かけて測量し、地図を描かないといけません。
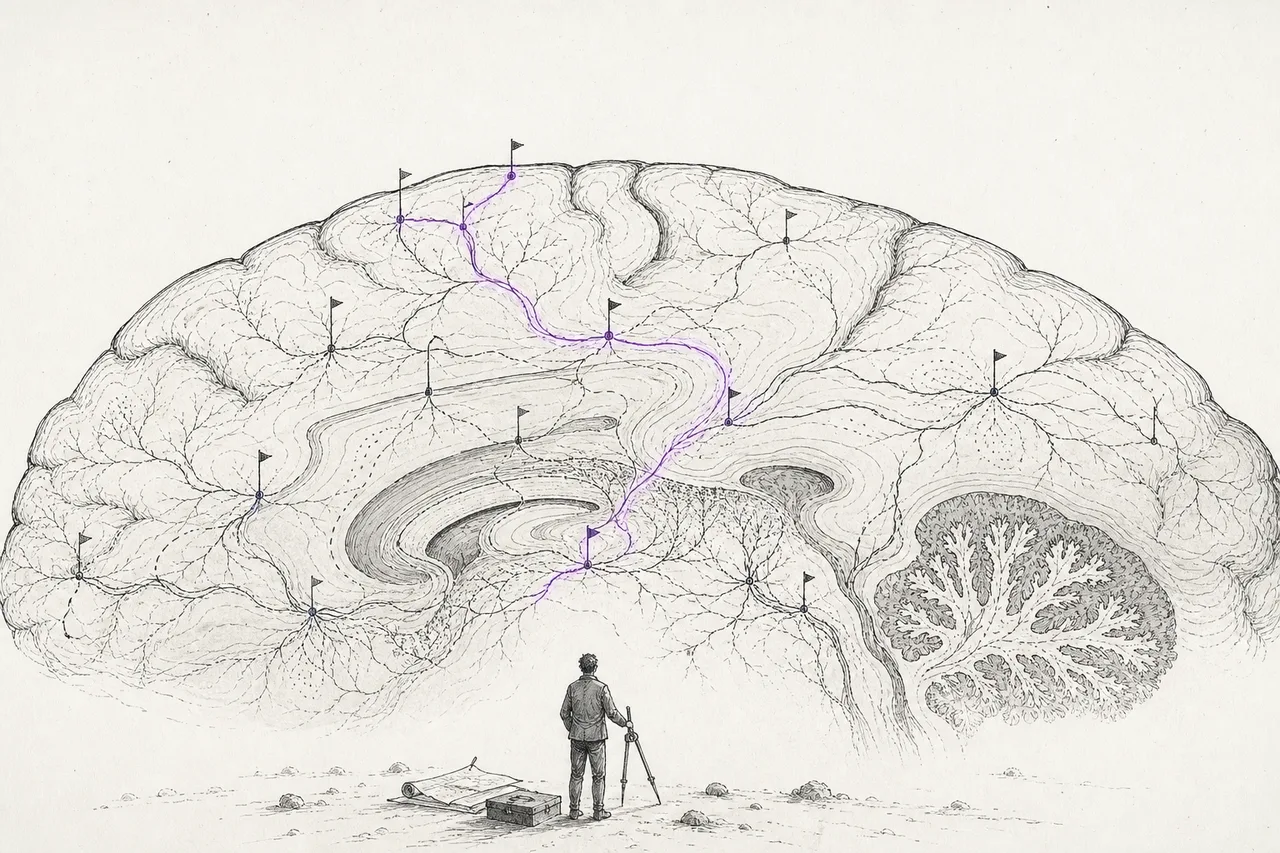
主な道具は3つの系統があります。
- 高密度プローブ(high-density probes): 花形は IMEC が開発した Neuropixels。2.0 世代は1本のプローブに記録点が5,120個(4本のシャンク)あり、同時に384チャンネルを読み出して、数百の神経細胞を長時間安定して同時記録できます——脳研究のやり方そのものを変えた道具です
- 二光子顕微鏡(two-photon microscopy): 生きたまま働いている神経細胞を実際にのぞき見る道具。2025年4月、Bruker は Inscopix のラインで超小型の nVista 2P を出したばかりです
- MRI と connectomics: 脳全体の配線図をつくります。米国の BRAIN Initiative は、これまでで最も高解像度の脳組織マップを公開し、細胞レベルの接続を約1億5,000万カ所ぶん記録しました
それぞれの神経細胞が、どの細胞とつながっているかを地図にすること——街じゅうの配線を、一本一本のレベルで図にするようなものです。究極の目標は「connectome」、つまり脳全体の接続地図。とはいえ約2,000億の細胞を持つ人の脳では、まだはるか遠いゴールです。
ここに注意したい点があります。こうした基礎研究を支える国の研究費が削られているんです——BRAIN Initiative の2025年度は3億2,100万ドルで、前年の4億200万ドルから約20%減。研究機器側は国の予算への依存が大きく、いつも一直線に伸びるわけではない、という警告です。
05BCI のエコシステムのどこにいるか
この node は、すべてがそこを通る「中間層」です。ご近所とどうつながっているか見てみましょう。
- Invasive BCI Systems から信号を受け取る: 脳に埋め込むチップが生の電気信号を集め、それをこの層に渡して翻訳させる——ハードウェアとソフトウェアは、切り離せない相棒どうしです
- そして Non-invasive BCI からも: 頭の外に貼るタイプ(EEG)は、もっとボケてノイズの多い信号しか取れません。だからこそ、優れた信号処理にいっそう頼ることになります
- Artificial Intelligence に深く頼る: いまの decoder は ML モデルで、最近は Foundation Models を借りて意図を推測し始めています——Synchron も Neuralink も、この道を歩んでいます
- Biotech & Genomic Medicine と補い合う: 脳の回路への理解は、神経の病気の治療にも、創薬にも役立ちます
いちばん面白いのは AI との関係です——これは双方向の道路。一方で AI は decoder を賢くしますが、もう一方で脳のデータが、新しい AI を訓練するための燃料になりつつある。2025年には、人の脳データから直接 foundation model を訓練しよう、という研究まで現れました。神経科学と AI が、本当に溶け合っていく地点なんです。
06いま、どこまで来たのか
2026年の全体像には、まるで違う2つの世界があります。一つ目は今日きちんと稼いでいる研究機器——顕微鏡や記録システムを世界中のラボに売る、巨大な科学機器メーカーたち。二つ目はBCI のデコーダー——進歩は速いものの、その多くがまだ非公開企業や大学のラボの中にあります。
今年いちばんの節目は、Synchron が Chiral を発表したこと——最初の「brain foundation model」と呼ばれるもので、脳データから直接訓練し、NVIDIA の技術(Holoscan)の上でリアルタイムにデコードします。「decoder こそが商品だ」を、はっきり裏づける出来事でした。
07これからの展開
第一の方向は brain foundation models。患者一人ひとりのために毎回 decoder を訓練し直すのではなく、まず「脳一般を理解する」大きなモデルをつくっておいて、個人ごとには素早く微調整する——ChatGPT が一度の訓練で誰にでも使えるのと同じ発想です。Synchron の Chiral は、その第一歩。うまくいけば、セットアップの時間を大きく減らし、安定性をぐっと高めます。
第二の方向は デコードがもっと安定すること。2026年に最も重要だと見られている進歩の一つが、毎日ほんの少しの校正データだけで decoder を素早く調整し直す技術です。まるごと訓練し直さなくてよくなる——この分野を長年足止めしてきた問題への答えなんです。
第三の方向は 研究機器がより精密に、より安くなること。Neuropixels のようなプローブや超小型の二光子顕微鏡のおかげで、小さなラボでも高度な技術に手が届くようになります。質のいい脳データが増えれば増えるほど decoder も賢くなる——マッピングの道具とデコーダーのあいだに働く、正のフィードバックの輪です。
08課題とリスク
正直に言うと、この node はまだ解かれていない難題だらけです。
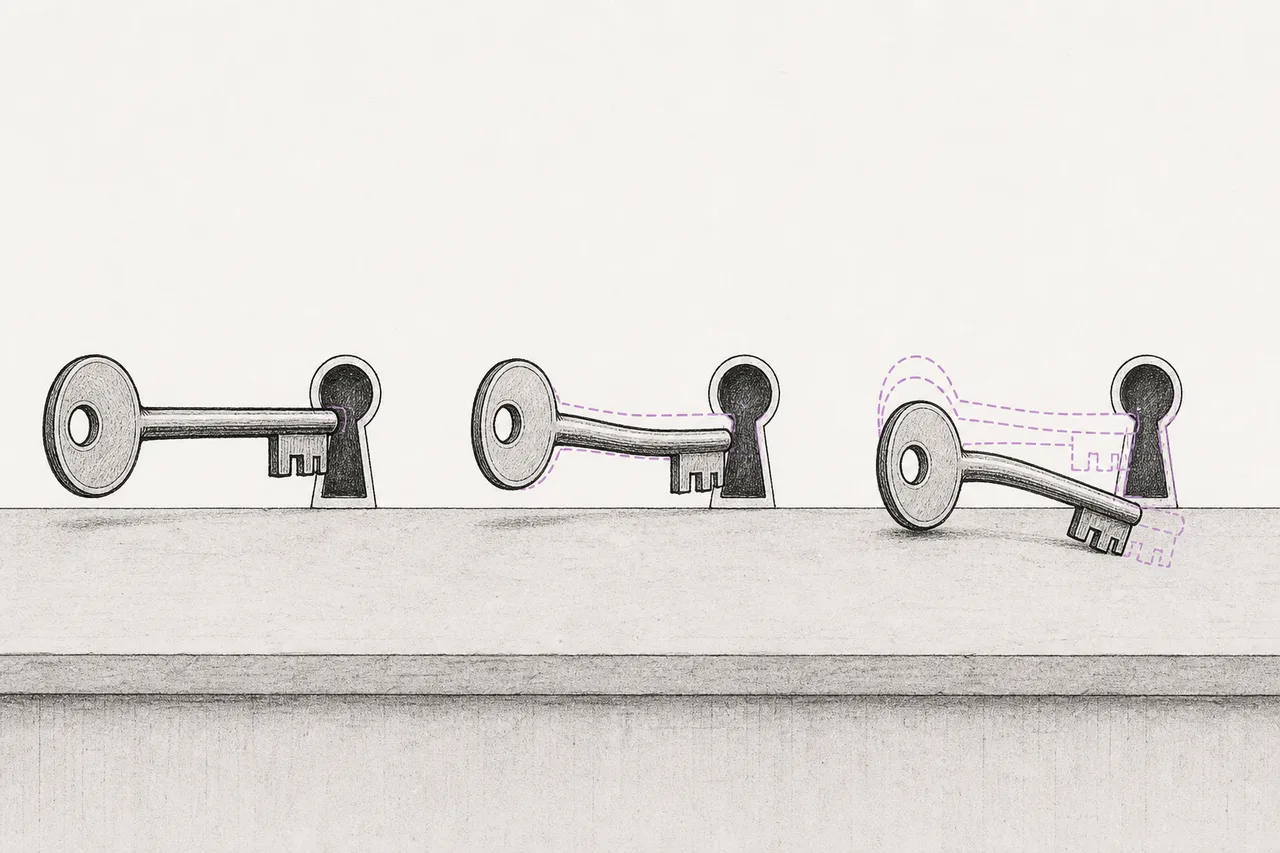
第一の、そしていちばん大きなリスクは 「decoder のズレ」(neural drift)。脳は静止した機械ではありません。電極が動いたり、細胞のふるまいが変わったり、記録条件が変わったりして、信号は毎日変化します。結果として、昨日まで正確だった decoder が、今日はズレているかもしれない。研究では、毎日 decoder を訓練し直さねばならないことを 「臨床での実用化を阻む最大の要因」と呼んでいます——細かな技術論に聞こえて、実はいちばん大きな壁なんです。
第二のリスクは generalize(汎化)。数字が示すとおり、decoder は狭いお題ではとても得意(50語の語彙でエラー9.1%)ですが、語彙をフルに開くとエラー率は23.8%へ跳ね上がります。開かれた現実の場面でも使えるようにするのは、まだ手強い課題です。
第三のリスクは 大部分がまだ学術と非公開企業の中にあること。いちばん優れたデコーダーは、大学のラボや、まだ上場していない非公開企業の中にあります。いっぽう株式市場にいるプレーヤーの多くは機器側で、成長は遅めで、国の研究費に頼っています——その研究費が、2025年に約20%カットされたばかりなんです。
短くまとめると——「障がいのある人が、考えるだけでカーソルを動かした」というニュースを見たとき、その陰の主役はこのソフトウェアの層です。何千チャンネルもの電気的な混沌を意図に翻訳し、脳がどう働くのかの地図を描いている層。AI が神経科学に出会う場所であり、BCI の本当の勝負が決まる場所——チップの上ではなく、翻訳役の上で。