メガトレンド · 人工知能
世界中のデータを一つの「脳」へと溶かし込む溶鉱炉
ChatGPT、Claude、Geminiの裏側には、ほんの数えるほどのラボがあります。一つのモデルに数億ドルを焼べて、最先端のAI(フロンティアモデル)を「訓練」しているんです。ここはメガトレンドAIのいちばん芯にある層——そして何より奇妙なのは、主役の会社たちがほとんどまだ非公開で、株を直接は買えないことです。
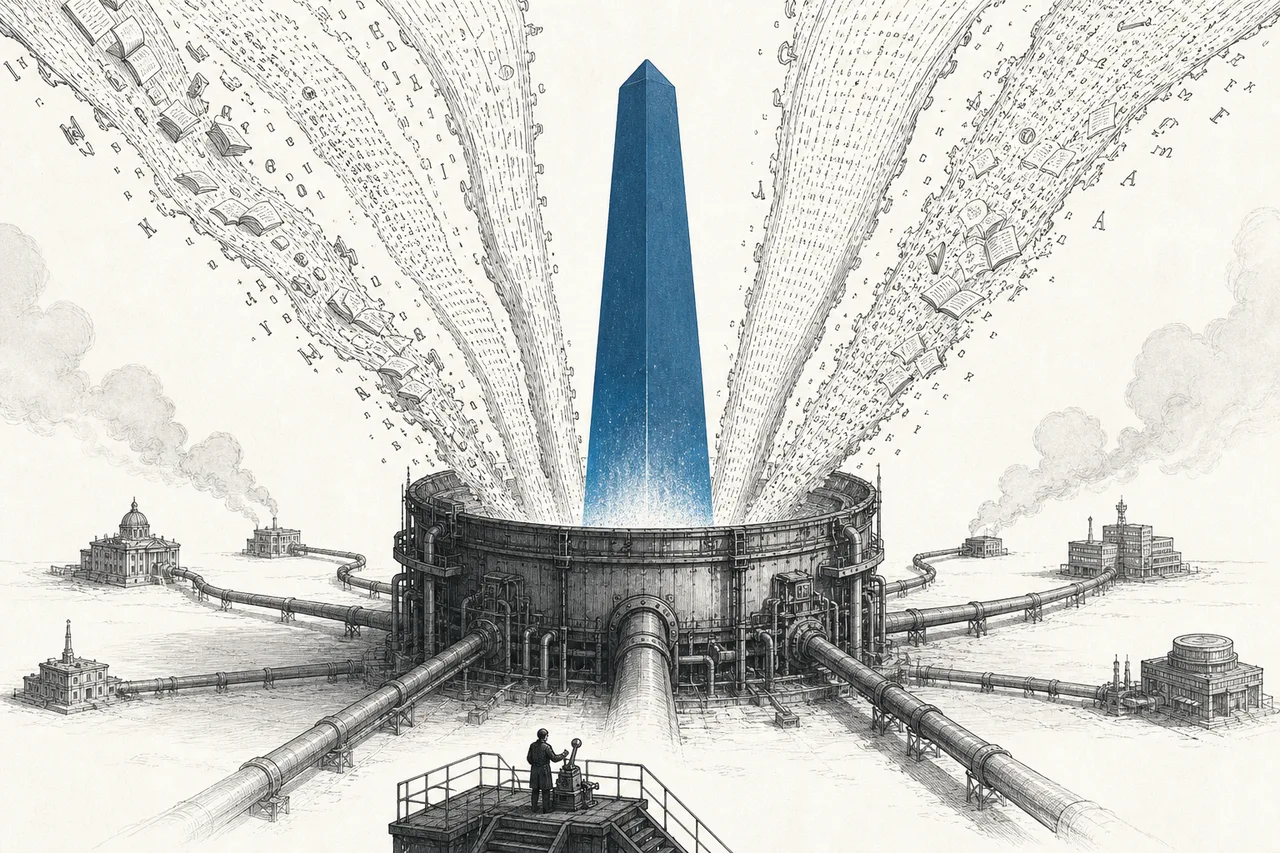
01これは何?
ChatGPT、Claude、Geminiに打ち込んで会話するたび、あなたはテクノロジー史上もっとも高価で複雑な工程の一つが生んだ「成果物」と話しています。このnodeは、そのモデルそのものを「訓練」する会社の話——モデルを使ってアプリを作る人ではなく、モデル本体を作る人の話です。
foundation model(基盤モデル)という言葉は、膨大なデータで広く一般的に訓練された巨大なAIモデルのこと。コードを書き、翻訳し、文書を要約し、質問に答える——何でもこなせて、仕事ごとに作り直す必要がありません。たとえるなら「万能エンジン」で、他社がそれを積んで何種類もの車を組み立てられる。いっぽうfrontier model(フロンティアモデル)は、その時々でいちばん大きく賢い最上位のモデル——もっとも資源を食う本物中の本物で、世界でも作れるのはほんの数社だけです。
Foundation model = 広く訓練され、いろいろな仕事に転用できる土台のモデル · Frontier model = その時点でいちばん最先端の基盤モデル(GPTの最新版、Claude、Geminiなど)——AIにできることの限界を押し広げる「最前線」で、もっとも多くのcomputeを使う。すべてのfrontier modelはfoundation modelだが、すべてのfoundation modelが最前線にいるわけではない。
メガトレンドの地図では、このnodeはArtificial Intelligenceの下にあるサブテーマで、「プラットフォーム層(platform layer)」にあたります——AIの他のすべての層が頼る心臓部です。チャットアプリも、賢いアシスタントも、自分で動くagentシステムも、その下に基盤モデルがなければ一つも成り立ちません。
02なぜそれがすべての中心なのか
第一の理由はお金——それがかつてないほど大きく、速く伸びていること。売上の数字を見るだけで分かります。OpenAIの年間換算売上(run-rate)は2025年初めの約130億ドルから約250億ドル(2026年初め)へ。Anthropicは2024年末の約10億ドルから2026年5月には470億ドル超へと駆け上がりました——1年あまりで80倍以上です。これはソフトウェアの世界ではほとんど見たことのない速さで、数兆円規模の事業が立ち上がっている姿です。
第二の理由は投資——企業価値が歴史的な水準まで跳ね上がっていること。OpenAIは約8,500億ドルのバリュエーションで大型調達を実施。Anthropicは2026年半ばに約9,650億ドルへと駆け上がり、世界でもっとも価値の高いAIスタートアップになりました。しかも2026年第1四半期だけで、世界のAIへの資金流入は1,800億ドルを超え——2024年の通年合計より多いのです。
でも、いちばん深い理由は数字ではありません。それは戦略上のポジションです。基盤モデルは、すべてのAIアプリが管をつないで飲みに来る「蛇口」——いちばん賢くいちばん安いモデルを握る者が、新世代ソフトウェアまるごとのコストと能力を握ります。だからこそ巨大テックはどこも——Microsoft、Amazon、Google、Meta、Nvidia——自前で作りつつ、他のラボにも投資して、この層に巨費を注ぎ込むんです。
03どう動くのか
フロンティアモデルを一つ作る工程は大きく三つの関門に分かれます。この三つを理解すれば、なぜこれほど高くつくのか、なぜ作れるのが数社だけなのかが見えてきます。
第一の関門はpretraining(事前学習)——インターネットの文章をほぼ丸ごと(何兆語も)モデルに「読ませ」、次に来る単語を当てる訓練を何兆回も繰り返させます。そうして言語の構造・知識・推論を、数十億個もの数値(parameters)の中に染み込ませていく。この関門がcomputeとお金をいちばん食います——数万個のGPUを何か月も連続で回す必要があるんです。
第二の関門はpost-training(事後学習)。pretrainを終えたばかりのモデルは賢いけれど「生(なま)」——たくさん知っているのに、人とどう話せばいいかを知りません。だからこの関門で礼儀と安全性を教えます。主役の技術がRLHF(Reinforcement Learning from Human Feedback)——人が答えに点数をつけ、その点数を使って、役に立ち害のない受け答えへとモデルを調整します。後半では「順を追って考える力(reasoning)」の訓練も加わり、ここが最新モデルが一気に賢くなった転換点になりました。
第三の関門はinference(実利用)——あなたが質問を打ち、モデルが答えるその瞬間です。ここは毎日休みなく「お金を焼べ続ける」関門。どの答えにも実際に計算チップを使うので、使う人が増えるほどinferenceのコストは膨らみます——だからラボのcompute費用は、訓練が終わっても決して終わらないんです。
では、なぜコストは毎年跳ね上がるのか? 答えはscaling laws(スケーリング則)という法則にあります。研究で分かったのは、モデルを大きくし+データを増やし+computeを増やすほど、賢さは予測どおりに伸びる——ただし一段賢くなるには資源を「何倍にも」増やさなければならない、ということ。つまりフロンティアモデルの訓練費は、GPT-4時代の数千万ドル(約7,800万〜1億ドル)から、2025〜2026年には1モデルあたり2〜5億ドルへ。アナリストは2027年までに1モデル10〜30億ドルに達すると見ています。
04二つの系統:クローズド vs オープン
モデルラボの世界は、はっきり対立する二つの哲学に分かれます——そしてこれがこのnodeの二つのサブテーマです。
一つ目はClosed / Frontier Labs(クローズドなラボ)——できる限り最高のモデルを訓練し、それを「閉じ込めて」APIやアプリ経由でしか触れさせない方式。賢さを「借りて使う」ことはできても、モデル本体は手に入りません。これがOpenAI、Anthropic、Google DeepMind、xAIの道です。世界最強クラスのモデルはほぼこちら側にあり、プレミアムな売上もこちらから生まれます——Anthropicは利用「量」のシェアこそ約12%ですが、企業向けに高めの価格をつけているため、金額ベースではそれを大きく上回って稼いでいます。
二つ目はOpen-Weight Model Developers(オープンウェイトのラボ)——モデルを訓練したうえで「設計図」を公開する(weightsをダウンロード可能にする)方式。誰でも自分のマシンで動かし、自由に調整できます。この陣営の先頭はMeta(Llamaシリーズ)、フランスのMistral、中国のDeepSeek/Qwen。売りは主権とコントロール——データを米国のAPIに預けたくない組織や国は、オープンモデルを自前の環境で動かせるんです。
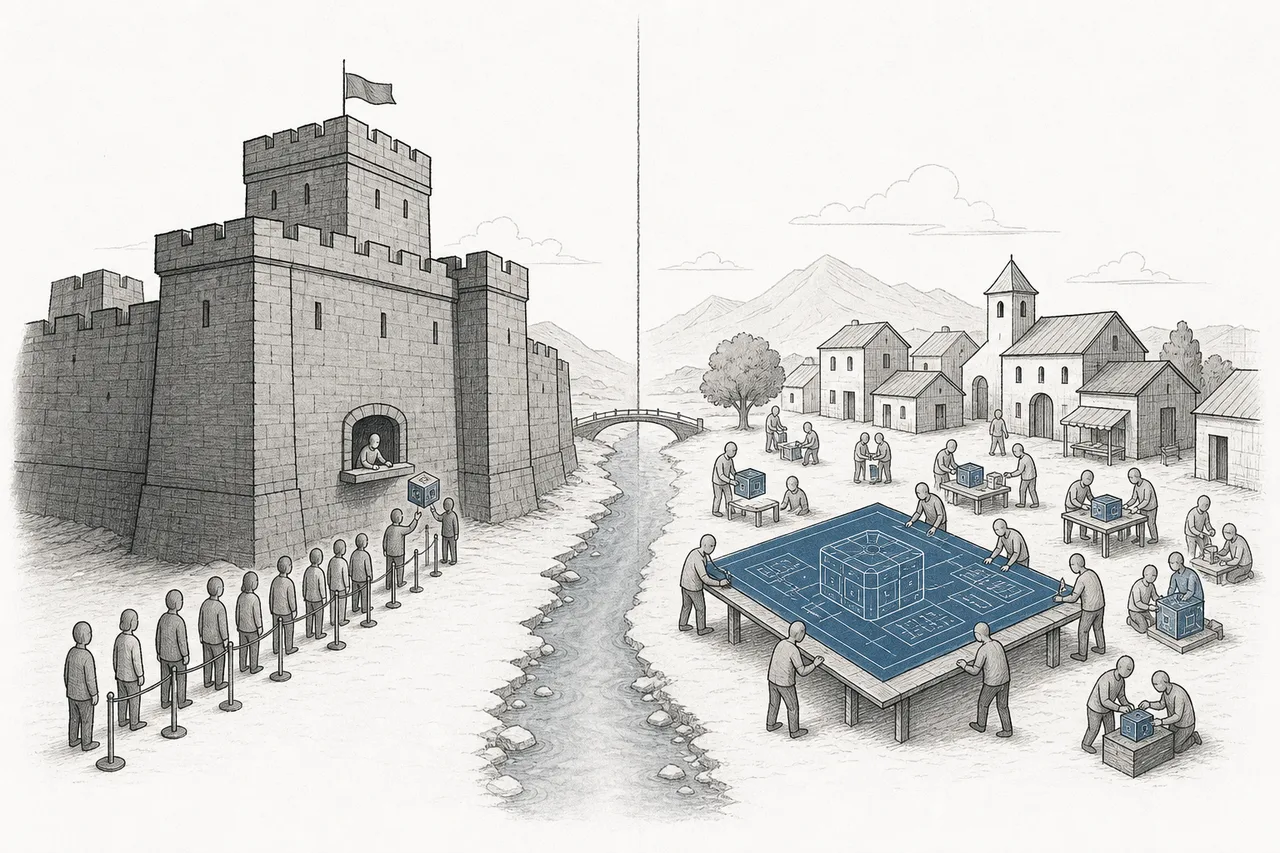
この境界線が、いま面白い動き方をしています。2024年にはオープンモデルがクローズドモデルに品質で1年近く遅れていましたが、2025〜2026年にはその差が約6か月まで縮みました。そして驚くのは、中国発のモデル(DeepSeek、Qwen、MiniMax、Moonshot)が、モデル集約プラットフォーム上の利用量で2%未満から、わずか1年でトークン量の45%超へと跳ね上がったことです。
Open-weight = 「訓練済みの数値」(weights)をダウンロードして動かしたり調整したりできるようにすること。ただし学習に使ったデータや訓練レシピのすべては公開しないことが多く、何もかも開示する一般的なopen-sourceソフトウェアとは違います · 大事なのは、open-weightは「動かす」のは無料でも「作る」のは無料ではないこと——訓練費は相変わらず数億ドル。得をするのは使う側で、作る側ではありません。
05エコシステムの中でのつながり
このnodeは、メガトレンドAI全体のど真ん中に座っています。他の層が頼り、かつ逆に栄養を送り返す「プラットフォーム層」です:
- AI Compute & Accelerator Siliconから膨大な電力(≒計算力)を吸い上げる: pretrain・post-train・inferenceのどの関門も、高価なGPU/acceleratorチップの上で走る。ラボの需要こそがNvidiaの売上を押し上げ、computeをボトルネックにしている。この関係がいちばん直接的で深い
- AI Applications & Copilotsに原料を供給する: チャットアプリ、コーディング補助、文書要約ツール——すべて基盤モデルから管を引いている。モデルが安くなったり賢くなったりすれば、アプリの一群がすぐに恩恵を受ける
- Agentic AI & Autonomous Workflowsのエンジンになる: 何段階も自分で動くAIシステムは、「順を追って考える」モデルを必要とする。それは最新のpost-trainingから直接生まれる
- Energy Transition & Power Demandからエネルギーを吸う: モデルを動かすデータセンターは都市規模の電力を食い、いまや電力こそが次世代モデルを拡張するうえでの本当の制約になっている
そしてこのnodeは、AIの外にあるトレンドにも「火を点け」ます——Biotech(AIによる創薬)からCybersecurityまで。多くの人が基盤モデルを、電気やインターネットと同じ「汎用技術(general-purpose technology)」と呼ぶのはこのためです——単体の製品ではなく、他のすべてが積み上がる土台の層なんです。
06いま、どこまで来たのか
プレーヤーの話に入る前に、この層への投資の仕方をまるごと決める一つの事実を押さえておく必要があります:フロンティアモデルを訓練する主役の会社は、ほぼすべてまだ非公開だ——OpenAI、Anthropic、xAI、Mistralはどれも未上場です(OpenAIはようやくIPOの準備を始めたところ)。これはがっかりする話ではなく、大事な「市場の事実」です:一般の投資家がこの層に関わる道は、それらのラボに資金を出し、computeも所有する上場ジャイアントを通じて、ということになります。
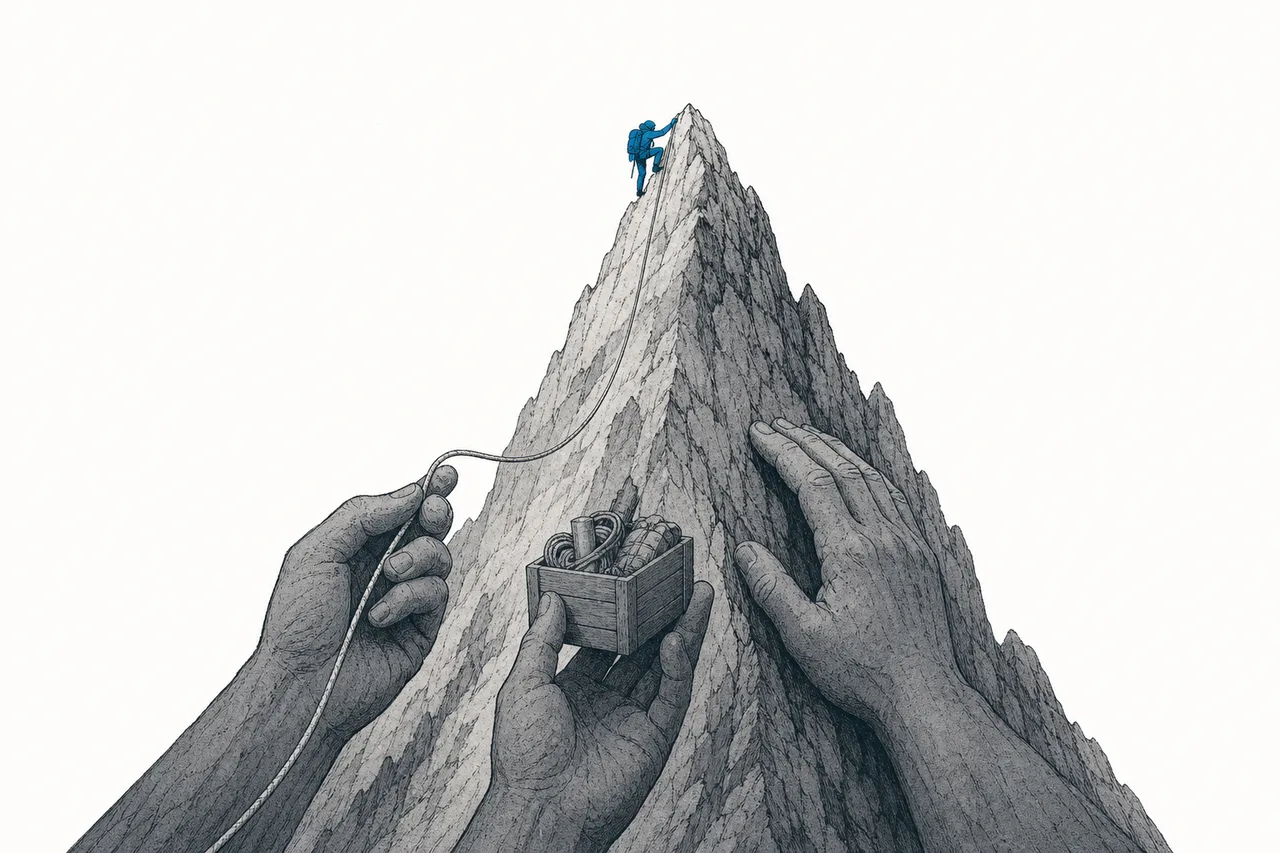
お金の流れは、はっきりした「資本のホイール」を描きます:Microsoft、Amazon、Alphabetといった上場ジャイアントがクローズドなラボに資金とcomputeを注ぐ。すると今度はラボがそのお金で、同じジャイアントからチップを買いデータセンターを借り戻す——お金は支援者の決算に、売上としても保有stakeとしても巡って帰ってくる。この仕組みこそ、一般の投資家が支援者の株を通じて非公開ラボへのexposureを持てる理由です(各社の個別ディール——Amazon/Trainium、xAI/SpaceX、合計で数十兆円規模のcapex——の深掘りはClosed / Frontier Labsへ)。
アジア側にも、このトレンドに乗る上場プレーヤーがいます——Baidu(Ernieモデル)、Alibaba、Tencentはそれぞれ自前の基盤モデルに投資し、より小さなSenseTimeやMiniMaxは特化型モデルに注力しています。だから世界の先頭ラボが非公開でも、アジア市場には触れられる「上場の代理プレーヤー」がそれなりに揃っているわけです。
オープン側にも自前の柱があります——Meta(Llamaシリーズ)が米国の柱、Mistralが欧州の旗手、そして利用量で先頭を走る中国のQwen/DeepSeek。買える株という意味で触れられるオープン勢はMetaとAlibaba(Qwenの親)——深掘りはOpen-Weight Model Developersへ。
07これからの展開
第一の方向は「大きく」訓練するより「考えさせる」訓練へ。何年もの間、賢さはモデルとデータの規模を増やすこと(pretraining scaling)から来ていました。でもいまの新しい波は、答えるときの「順を追って考える」段階(test-time/reasoning)にcomputeを注ぐことから来ています——難しい問いに、より長く考えてよりよく答える。これがコストの方程式を変えます:これまでは訓練でお金を焼べていたのが、これからはinferenceでどんどん焼べるようになるんです。
第二の方向は制約がチップから電力へ移ること。去年のボトルネックは「GPUを十分そろえる」ことでした。今年は「十分な電力とデータセンターの用地を確保する」ことになりつつあります。次世代モデルの訓練(2027年までに1モデル10〜30億ドルに届くかもしれない)は、お金やチップよりもエネルギーに縛られていく——ここがAIとエネルギーのトレンドが切り離せなく結びつく地点です。
第三の方向はオープンがクローズドを追い詰めること。オープンとクローズドの品質差がこのまま縮んでほぼゼロになったら、大きな問いはこうです——「ほぼ十分に良いもの」が自前で動かせて無料になったとき、クローズドなラボは価格決定力を保てるのか? その答えが、この層に流れ込む莫大な価値が長期的に誰のところへ落ち着くかを決めます。
08課題とリスク
AIのいちばん芯にある層は、いちばん固有のリスクを抱える層でもあります。
第一のリスクはcommoditization(コモディティ化=「並品」になること)。オープンモデルが追いつき、中国のモデルが値段をどんどん下げていくと、「1トークンあたりの賢さ」は価格だけで競う日用品になりかねません——2025年初め、DeepSeekが「近い水準のものに数十億ドルは要らないかもしれない」と市場を震え上がらせたとおりです(「DeepSeek Monday」の全容はOpen-Weight Model Developersへ)。
第二のリスクは終わらないコスト。世代ごとに跳ね上がる訓練費(1モデル10〜30億ドルへ)に、利用者数とともに膨らむinference費が重なる——つまりラボは絶え間なく巨額の資金を調達し続けなければなりません。もしいつか投資家が「売上はいつコストに追いつくのか」と問い始めれば、資金調達はつまずきかねない——そして「訓練を止めれば抜かれる」事業では、お金のつまずきはとても大きなリスクなんです。
第三のリスクは集中と地政学。世界最強のモデルはほんの数社の手にあり、ごく限られた場所でしか作れない先端チップに頼っています。チップの輸出規制、米中の競争、そしてどんどん賢くなるAIの安全性をめぐる問い——どれもが、思ったより速く全体の地図を塗り替えうる変数です。
ひとことで言えば:AI ComputeがAI時代の「機械」なら、基盤モデルは世界中のデータを売れる賢さへと鋳造する「工場」です。主役の多くがまだ株式市場の外にいて、買える株は彼らに「ロープを握り電気代を払う」会社だ——そう理解することは、いちばん手の届きにくく見えるこのnodeが、なぜメガトレンドまるごとの行方を決めるnodeなのかを理解することなんです。