Megatrend · Artificial Intelligence
เมื่อ AI ย้ายออกจากคลาวด์ มาอยู่ในมือถือ โน้ตบุ๊ก และรถของคุณ
ทุกครั้งที่เราถาม ChatGPT คำถามจะวิ่งข้ามโลกไปหาชิปยักษ์ในศูนย์ข้อมูล แล้ววิ่งกลับมา — แต่มี AI อีกประเภทที่ไม่วิ่งไปไหนเลย มันรันอยู่ในเครื่องที่อยู่ในมือเรา บนชิปจิ๋วชื่อ NPU node นี้คือเรื่องของซิลิคอนที่ทำให้ AI ทำงาน “ในเครื่อง” ได้ — เร็วทันใจ ทำงานตอนไม่มีเน็ตก็ได้ ข้อมูลส่วนตัวไม่ต้องออกจากเครื่อง และไม่ต้องจ่ายค่าคลาวด์ทุกครั้งที่ถาม นี่คือคลื่นลูกใหม่ที่กำลังเปลี่ยนมือถือ คอมพิวเตอร์ และรถยนต์ทุกคันให้ “คิดเองได้”
01มันคืออะไร (ชิป AI ในเครื่อง — NPU)
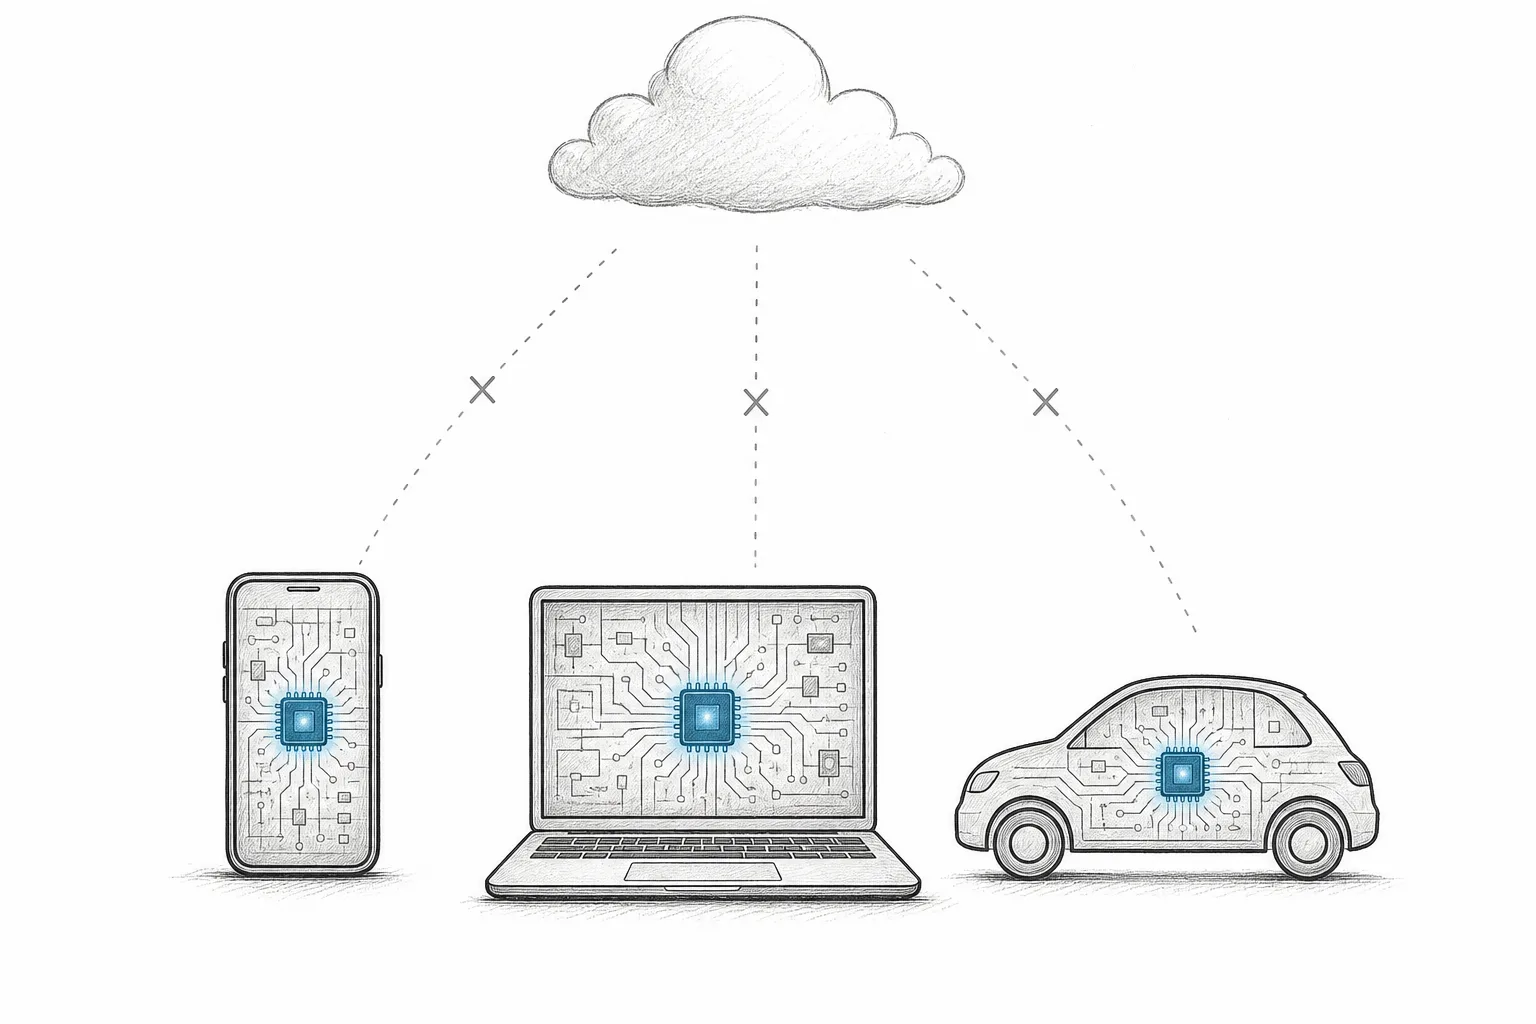
ลองนึกถึงสองโลกของ AI โลกแรกคือ AI ที่อยู่ใน “คลาวด์” — เราพิมพ์คำถามใส่ ChatGPT คำถามวิ่งข้ามโลกไปหาชิปยักษ์ในศูนย์ข้อมูล คำนวณเสร็จแล้ววิ่งกลับมาหาเรา ส่วนโลกที่สอง — ซึ่งเป็นเรื่องของ node นี้ — คือ AI ที่ ทำงานอยู่ในเครื่องที่เราถืออยู่ ไม่ต้องวิ่งไปไหนเลย เวลามือถือเบลอฉากหลังตอนวิดีโอคอล แปลภาษาแบบออฟไลน์ หรือสรุปข้อความให้เราโดยที่เครื่องบินยังเปิดโหมดบินอยู่ — นั่นคือ AI ที่รันในเครื่อง
หัวใจของมันคือชิปจิ๋วประเภทหนึ่งชื่อ NPU (Neural Processing Unit หรือ “หน่วยประมวลผลโครงข่ายประสาท”) มันไม่ใช่ GPU ยักษ์ในศูนย์ข้อมูล แต่เป็นบล็อกเล็กๆ ที่ฝังอยู่ใน SoC (System-on-Chip — ชิปก้อนเดียวที่รวม CPU, GPU, NPU ไว้ด้วยกัน) ของมือถือ โน้ตบุ๊ก หรือกล่องควบคุมในรถ หน้าที่ของ NPU มีอย่างเดียว: รันงาน AI (โดยเฉพาะการ inference หรือ “ใช้งานโมเดลที่ฝึกเสร็จแล้ว”) ให้เร็วและประหยัดไฟที่สุด
ในแผนผังเมกะเทรนด์ node นี้เป็นสาขาย่อยภายใต้ AI Compute & Accelerator Silicon ในเทรนด์ใหญ่ Artificial Intelligence พี่น้องที่อยู่ข้างกันคือชิปฝั่ง “คลาวด์” — GPU & Merchant Accelerators (ชิปยักษ์ในศูนย์ข้อมูล) และ Inference-Optimized Silicon (ชิปที่เน้นรันโมเดลในคลาวด์) ความต่างชัดเจน: ฝั่งคลาวด์คือ AI ที่ ใหญ่และทรงพลังที่สุด แต่อยู่ไกล ส่วน node นี้คือ AI ที่ เล็กพอจะอยู่ในมือเรา และอยู่ใกล้สุด
NPU = ชิปเฉพาะทางที่ออกแบบมารันงาน AI ในเครื่อง เก่งการคูณเมทริกซ์เล็กๆ ซ้ำๆ ขณะกินไฟต่ำ · TOPS (Tera Operations Per Second) = หน่วยวัดความเร็ว NPU คือ “ทำได้กี่ล้านล้านการคำนวณต่อวินาที” — ยิ่งมาก ยิ่งรันโมเดลใหญ่ในเครื่องได้ · SoC = ชิปก้อนเดียวที่รวม CPU + GPU + NPU ไว้ในตัว เหมือนใน Snapdragon ของมือถือ หรือชิป M-series ของ Mac
02ทำไมถึงสำคัญ — เหตุผล 4 ข้อที่ต้องรันในเครื่อง
คำถามที่ตรงไปตรงมาคือ: ในเมื่อคลาวด์ทรงพลังกว่ามาก ทำไมต้องดิ้นรนเอา AI มารันในเครื่องเล็กๆ ที่กินไฟจากแบตเตอรี่? คำตอบคือ การรันในเครื่องชนะคลาวด์ใน 4 เรื่องที่ผู้ใช้รู้สึกได้ทันที และทั้ง 4 เรื่องนี้คือเหตุผลที่ทำให้ NPU กลายเป็นชิ้นส่วนมาตรฐานของอุปกรณ์ยุคใหม่
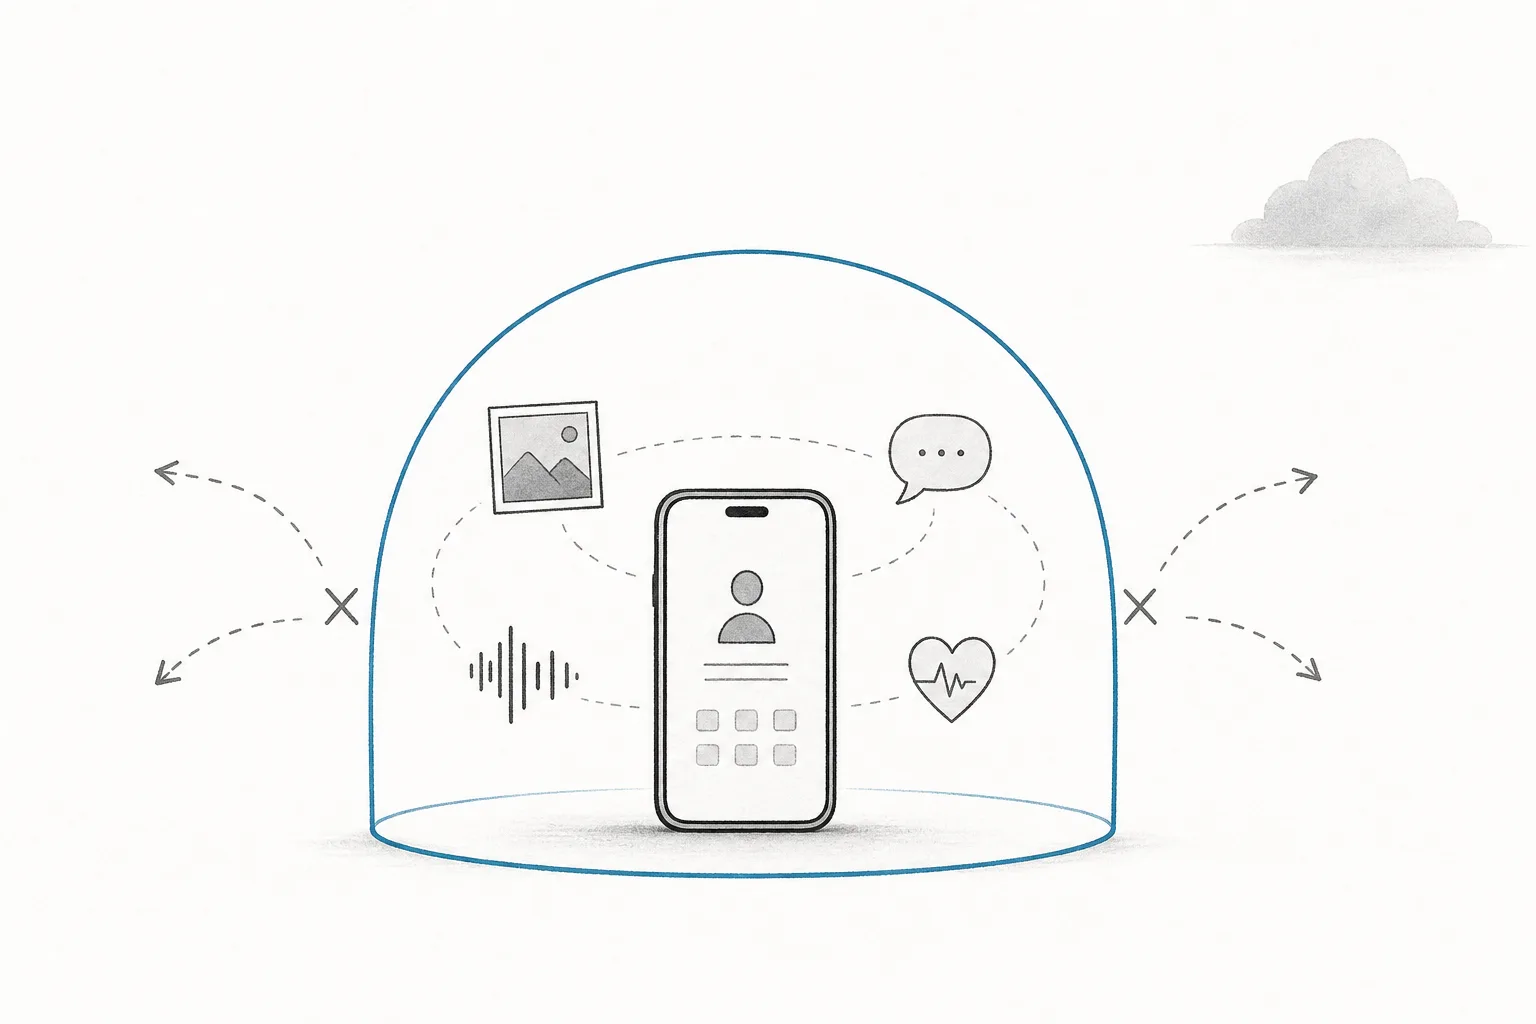
- ความเป็นส่วนตัว (privacy): ข้อมูลที่อ่อนไหวที่สุด — รูปถ่าย ข้อความ เสียง สุขภาพ — ไม่ต้องออกจากเครื่องไปนั่งบนเซิร์ฟเวอร์ของใคร ประมวลผลในเครื่องแล้วจบ นี่คือจุดขายหลักของ Apple Intelligence ที่ชูเรื่อง “ข้อมูลอยู่ในเครื่อง”
- ความหน่วงต่ำ (latency): ไม่ต้องรอข้อมูลวิ่งไป-กลับคลาวด์ การ inference ในเครื่องบนมือถือยุคใหม่ทำได้เร็วระดับ ต่ำกว่า 20 มิลลิวินาที — เร็วพอสำหรับงานเรียลไทม์อย่างการเบลอฉากหลังวิดีโอ หรือระบบช่วยเบรกในรถที่รอ “เสี้ยววินาที” ไม่ได้
- ทำงานออฟไลน์ (offline): ไม่มีเน็ตก็ใช้ได้ บนเครื่องบิน ใต้ดิน หรือพื้นที่สัญญาณอ่อน แปลภาษา สรุปเอกสาร หรือสั่งงานด้วยเสียงได้ปกติ
- ลดต้นทุนคลาวด์ (cost): ทุกคำตอบที่รันบนคลาวด์มีค่าไฟและค่า GPU จริงๆ ยิ่งมีคนใช้ AI มากเท่าไหร่ บิลคลาวด์ก็ยิ่งบาน การย้ายงานเล็กๆ ที่เกิดบ่อยๆ มารันในเครื่องผู้ใช้ ช่วยให้บริษัทไม่ต้องแบกค่า inference มหาศาลในศูนย์ข้อมูล
เมื่อรวมแรงทั้ง 4 ข้อ ตลาดฮาร์ดแวร์ AI ที่ขอบ (edge) จึงโตเร็วมาก ประเมินกันว่าจากราว $26,000 ล้านในปี 2025 จะโตไปแตะ ~$59,000 ล้านในปี 2030 ที่อัตราเฉลี่ยราว 17–18% ต่อปี และนั่นยังไม่นับว่ามันค่อยๆ กลายเป็น “ของแถมมาตรฐาน” ในชิปมือถือและโน้ตบุ๊กแทบทุกตัว
03มันทำงานยังไง (คำถามไม่วิ่งออกจากเครื่อง)
วิธีเข้าใจ node นี้ที่ง่ายที่สุดคือเทียบสองเส้นทางของคำถามเดียวกัน — เส้นทางคลาวด์ที่ต้องวิ่งข้ามโลก กับเส้นทางในเครื่องที่จบในตัวมันเอง
เคล็ดลับที่ทำให้รันในเครื่องได้คือ “โมเดลย่อ” โมเดลในคลาวด์อาจมีพารามิเตอร์เป็นล้านล้านตัวจนใส่ในมือถือไม่ได้ ทางออกคือเทคนิคอย่าง quantization (ลดความละเอียดของตัวเลขในโมเดล เช่นจาก 16-bit เหลือ 4-bit) และการใช้ โมเดลภาษาขนาดเล็ก (SLM) เช่นตระกูล Phi ของ Microsoft หรือ Gemini Nano ของ Google ที่ถูกบีบจนเล็กพอจะรันบน NPU ในมือถือได้ — แลกความฉลาดสุดขีดบางส่วนกับการที่มัน “อยู่ในเครื่องเรา” ตลอดเวลา
ส่วน NPU เองเก่งงานนี้เพราะมันถูกออกแบบมาเฉพาะ — แทนที่จะเป็นชิปอเนกประสงค์ มันเต็มไปด้วยหน่วยคูณ-บวกเมทริกซ์เล็กๆ จำนวนมากที่ทำงานพร้อมกันขณะกินไฟต่ำมาก ความเร็วของมันวัดเป็น TOPS และตัวเลขนี้เองที่กลายเป็น “สเปกใหม่” ที่ทุกค่ายแข่งกันโชว์ในงานเปิดตัวมือถือและโน้ตบุ๊ก
04มันอยู่ตรงไหนในระบบนิเวศ
node นี้ไม่ได้แข่งกับคลาวด์แบบเอาเป็นเอาตาย — มันเป็น คู่หูที่แบ่งงานกัน ในสถาปัตยกรรม AI ยุคใหม่ งานที่เล็ก เกิดบ่อย และอ่อนไหวเรื่องความเป็นส่วนตัว ลงมาอยู่ในเครื่อง ส่วนงานที่ใหญ่และซับซ้อนสุดยังต้องพึ่งคลาวด์ ลองดูว่ามันเชื่อมกับใครบ้าง
- เสริม (ไม่ใช่แทน) Inference-Optimized Silicon ในคลาวด์: เมื่อโมเดลในเครื่องเจองานที่ใหญ่เกินกำลัง มันจะ “ส่งต่อ” ขึ้นคลาวด์ — แนวคิดที่เรียกว่า hybrid AI โมเดลจิ๋วในเครื่องจัดการ 80% ของงานประจำวัน ส่วนชิป inference ในศูนย์ข้อมูลรับงานหนักที่เหลือ สองชั้นนี้ทำงานต่อเนื่องกัน
- ใช้เทคโนโลยีเดียวกับ Logic Chips ที่ก้าวหน้าสุด: NPU ในมือถือเรือธงผลิตบนกระบวนการ 3nm เทียบเท่าชิปคอมพิวเตอร์ระดับบน — node นี้จึงเป็นลูกค้ารายสำคัญที่ดูดดีมานด์เข้าสู่วงการ Semiconductors ทั้งสาย โดยเฉพาะฝั่งลอจิกขั้นสูง
- ปลดล็อก Robotics & Physical AI โดยตรง: หุ่นยนต์ โดรน และเครื่องจักรอัตโนมัติต้อง “คิด” ตรงหน้างานแบบเรียลไทม์ จะรอคลาวด์ไม่ได้ — NPU ที่ขอบคือสมองที่ทำให้มันตัดสินใจเองได้ทันที
- เป็นหัวใจของ AI ที่ “อยู่ใกล้คนที่สุด”: โมเดลและแอป AI ที่อยู่ชั้นบนจะแพร่หลายจริงก็ต่อเมื่อมันทำงานได้ในอุปกรณ์ที่คนถืออยู่ — node นี้คือชั้นที่พา AI ออกจากศูนย์ข้อมูลมาถึงมือผู้ใช้หลายพันล้านคน
05ตอนนี้ไปถึงไหนแล้ว (2025–2026)
คลื่นที่เปลี่ยนเกมเร็วที่สุดตอนนี้คือ “AI PC” ในปี 2024 Microsoft ตั้งมาตรฐานใหม่ชื่อ Copilot+ PC โดยขีดเส้นว่าเครื่องต้องมี NPU แรงอย่างน้อย 40 TOPS ถึงจะรันฟีเจอร์ AI ในเครื่องของ Windows ได้ — เส้น 40 TOPS นี้กลายเป็น “บาร์” ที่ทุกค่ายชิปต้องข้ามให้ได้ทันที ผลคือ Intel (Core Ultra ~48 TOPS), AMD (Ryzen AI 300 ~50 TOPS) และ Qualcomm (Snapdragon X Elite ~45 TOPS) แข่งกันยัด NPU แรงๆ ลงในชิปโน้ตบุ๊ก
ผลของบาร์นี้เห็นชัดในตัวเลขยอดขาย Gartner ประเมินว่าสัดส่วน AI PC ในตลาดคอมพิวเตอร์ทั้งหมดพุ่งจาก ~16% ในปี 2024 เป็น ~31% ในปี 2025 (ราว 78 ล้านเครื่อง) และจะแตะ ~55% ในปี 2026 (ราว 143 ล้านเครื่อง) — แปลว่าภายในปี 2026 คอมพิวเตอร์ที่ขายออกไปเกินครึ่งจะมี NPU ติดมาด้วย
ฝั่งมือถือก็เร่งไม่แพ้กัน NPU ในชิปเรือธงโตเร็วจนน่าตกใจ — Hexagon NPU ใน Snapdragon 8 Elite Gen 5 ของ Qualcomm (เปิดตัวปลายปี 2025) แตะระดับ ~100 TOPS แรงพอจะรันโมเดลภาษาในเครื่องได้โดยไม่กินแบตจนหมด ด้าน Apple ใส่ Neural Engine 38 TOPS ในชิป A18 Pro และ M4 เป็นรากของ Apple Intelligence ที่ชูเรื่องประมวลผลในเครื่อง ส่วน MediaTek ใส่ NPU ~50 TOPS ใน Dimensity 9400 — ตัวเลข TOPS กลายเป็นสเปกที่ผู้บริโภคเริ่มดูพอๆ กับกล้องและแบตเตอรี่
เรื่องที่น่าจับตาคือ ภูมิทัศน์ผู้เล่นต่างจากฝั่งคลาวด์โดยสิ้นเชิง ในศูนย์ข้อมูล NVIDIA ครองตลาดเกือบเบ็ดเสร็จ แต่ที่ขอบเป็นสนามเปิดที่กระจายตัว — เจ้ามือถือ (Qualcomm, MediaTek, Apple), เจ้า IP ที่ขายแบบให้ออกแบบ NPU (Arm), และผู้เชี่ยวชาญ edge เฉพาะทาง (Ambarella ในกล้อง/รถ, Synaptics ใน IoT) ต่างมีที่ยืนของตัวเอง
06อนาคตข้างหน้า — AI PC, โมเดลจิ๋ว, หุ่นยนต์
ทิศทางแรกคือ NPU จะกลายเป็น “ของมาตรฐาน” ในทุกอุปกรณ์ เหมือนที่กล้องและ Wi-Fi เคยจากของพิเศษกลายเป็นของที่ทุกเครื่องต้องมี เมื่อคอมพิวเตอร์เกินครึ่งในปี 2026 มี NPU ติดมาแล้ว และมือถือเรือธงทุกตัวมี NPU เป็นหัวใจ — การมี AI ในเครื่องจะเลิกเป็นจุดขาย แล้วกลายเป็นสิ่งที่ทุกคนคาดหวังโดยปริยาย
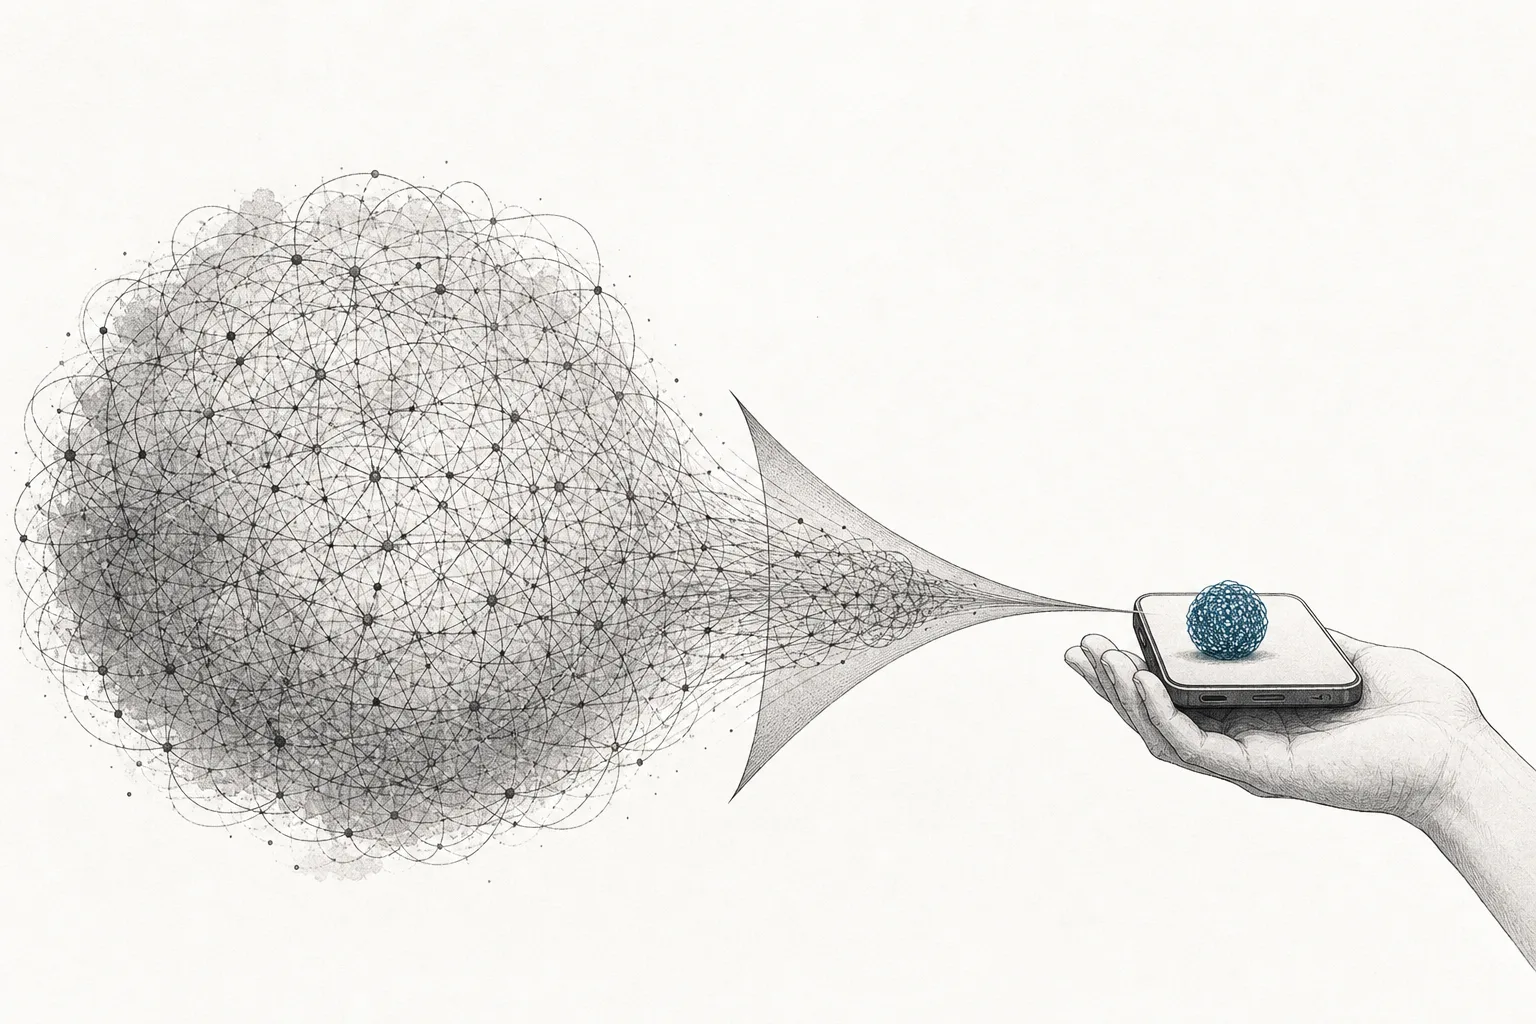
ทิศทางที่สองคือ โมเดลย่อจะฉลาดขึ้นเร็วกว่าที่คิด งานวิจัยด้านโมเดลภาษาขนาดเล็ก (SLM) และเทคนิคบีบโมเดลก้าวหน้าทุกเดือน โมเดลจิ๋วที่รันบน NPU วันนี้ทำงานได้ใกล้เคียงโมเดลคลาวด์ของเมื่อปีก่อนแล้ว ยิ่งช่องว่างนี้แคบลง งานยิ่งไหลลงมาอยู่ในเครื่องมากขึ้น — นี่คือลมหนุนเชิงโครงสร้างของ node นี้
ทิศทางที่สามคือ การขยายออกจากมือถือ-พีซี ไปสู่รถยนต์และหุ่นยนต์ รถยนต์ยุคใหม่คือ “ดาต้าเซ็นเตอร์บนล้อ” ที่ต้องประมวลผลภาพจากกล้องรอบคันแบบเรียลไทม์ — งานที่รอคลาวด์ไม่ได้เด็ดขาด เช่นเดียวกับหุ่นยนต์และโดรนใน Robotics & Physical AI ที่ต้องการสมองที่ขอบเพื่อตัดสินใจเอง ตลาดใหม่เหล่านี้คือสนามที่ผู้เล่น edge เฉพาะทางอย่าง Ambarella และ Nvidia (ฝั่งชิปรถ) แข่งกันดุเดือด
07ความท้าทายและความเสี่ยง
ความเสี่ยงข้อแรกคือ โมเดลที่ใหญ่และฉลาดสุดยังต้องอยู่บนคลาวด์ NPU ในเครื่องเก่งงานเล็กๆ ที่เกิดบ่อย แต่งานที่ต้องการเหตุผลซับซ้อน บริบทยาวมาก หรือความรู้ล่าสุด ยังต้องพึ่งโมเดลยักษ์ในศูนย์ข้อมูล ถ้าผู้ใช้ยังรู้สึกว่า AI ในเครื่อง “โง่กว่า” คลาวด์อย่างเห็นได้ชัด ความต้องการจ่ายเพิ่มเพื่อ NPU แรงๆ ก็อาจไม่มากเท่าที่ค่ายชิปหวัง
ความเสี่ยงข้อสองคือ การแข่งขันที่ดุและกระจายตัว ต่างจากคลาวด์ที่มีเจ้าตลาดชัด สนามที่ขอบเปิดกว้างจนเบียดกันแน่น — Qualcomm, Apple, MediaTek, Intel, AMD, Arm และผู้เล่น edge เฉพาะทางอีกหลายราย ต่างชิงพื้นที่เดียวกัน เมื่อ NPU กลายเป็น “ของมาตรฐาน” ที่ทุกชิปต้องมี มันก็เสี่ยงกลายเป็นฟีเจอร์ที่แข่งกันด้วยราคามากกว่ากำไรงาม
ความเสี่ยงข้อสามคือ ปัญหา “ซอฟต์แวร์แตกเป็นเสี่ยง” NPU แต่ละค่ายมีชุดเครื่องมือของตัวเอง — Qualcomm มี QNN, Apple มี Core ML, MediaTek มี NeuroPilot นักพัฒนาที่อยากให้แอป AI รันได้ดีในทุกเครื่องต้องปรับจูนหลายรอบ ความยุ่งยากนี้ทำให้การนำ AI ในเครื่องไปใช้จริงช้ากว่าที่ฮาร์ดแวร์พร้อม — แม้ชิปจะแรงแค่ไหน ถ้าซอฟต์แวร์ตามไม่ทัน พลังก็ถูกใช้ไม่เต็มที่
สรุปสั้นๆ: node นี้คือเรื่องของ AI ที่ “ย้ายบ้าน” จากศูนย์ข้อมูลที่อยู่ไกล มาอยู่ในชิปจิ๋วของเครื่องที่เราถืออยู่ มันทำให้ปัญญาประดิษฐ์เร็วขึ้น เป็นส่วนตัวขึ้น และเข้าถึงคนหลายพันล้านได้จริง — และยิ่งโมเดลย่อเก่งขึ้นเท่าไหร่ เส้นแบ่งระหว่าง “AI ในเครื่อง” กับ “AI ในคลาวด์” ก็จะยิ่งจางลงเท่านั้น