Megatrend · Artificial Intelligence
ชิปที่ “คิดแทนเรา” และบริษัทเดียวที่คุมก๊อกน้ำของยุค AI
ทุกคำตอบของ ChatGPT ทุกภาพที่ AI วาด ทุกโมเดลที่ถูกฝึก ล้วนวิ่งผ่านชิปพิเศษไม่กี่ชนิด — และตลาดนี้ถูกครองโดยบริษัทเดียวเกือบเบ็ดเสร็จ ด้วย “คูเมือง” ที่ไม่ได้สร้างจากตัวชิป แต่จากซอฟต์แวร์ บทเรียนนี้พาไปดูว่าทำไมการคูณเมทริกซ์ถึงเปลี่ยนโลก GPU ต่างกับชิปสั่งทำ (ASIC) อย่างไร และทำไมยักษ์ทุกรายถึงเริ่มออกแบบชิปของตัวเองเพื่อหนีจากเจ้าตลาด
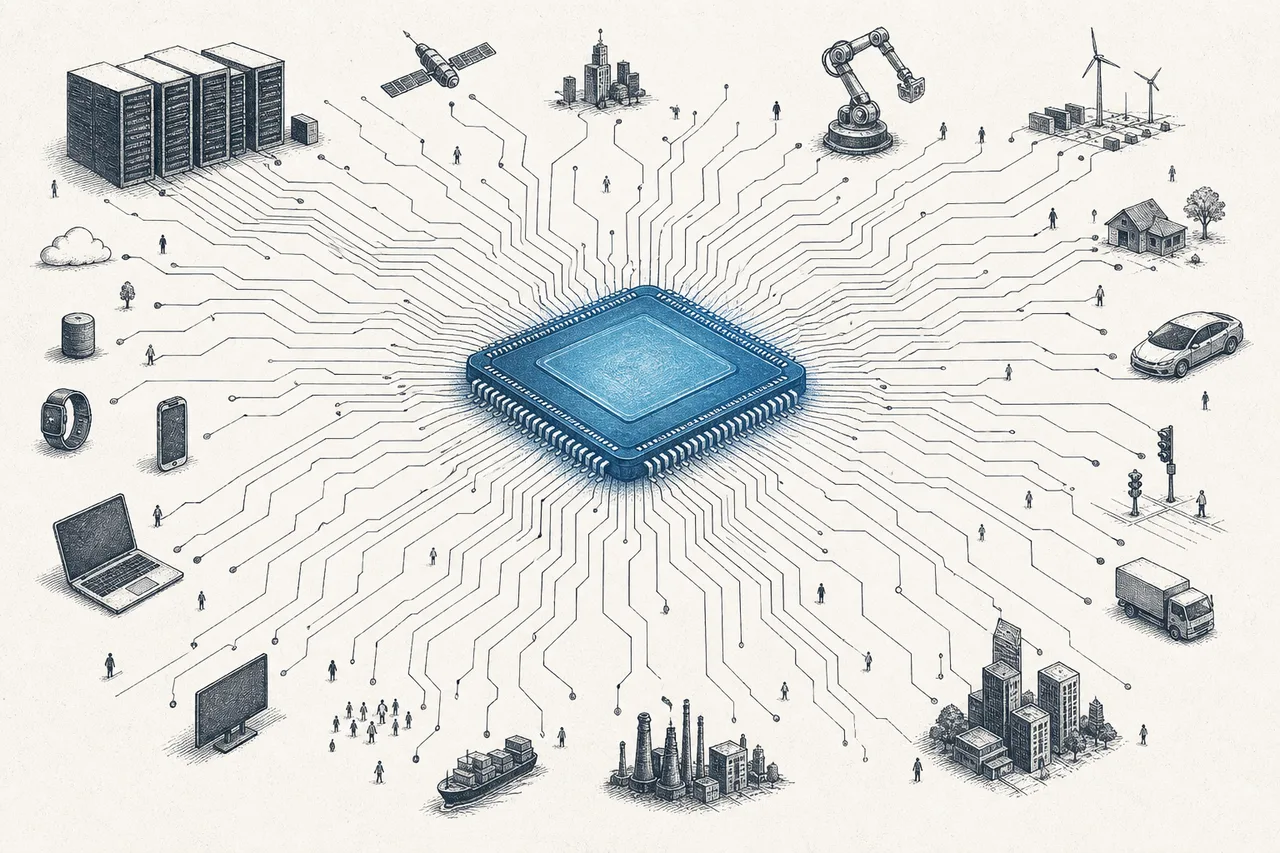
01มันคืออะไร (ชิปที่ “คิด”)
เวลาเราพิมพ์คำถามใส่ ChatGPT แล้วได้คำตอบกลับมาในไม่กี่วินาที เบื้องหลังนั้นมีชิปจำนวนมหาศาลกำลังคำนวณตัวเลขเป็นล้านล้านครั้ง node นี้คือเรื่องของ “ซิลิคอน” ที่ทำงานนั้น — ชิปที่ออกแบบมาเพื่อ ฝึก (train) และ รัน (inference) โมเดล AI โดยเฉพาะ
คำว่า “accelerator” (ตัวเร่ง) สำคัญมาก เพราะชิปกลุ่มนี้ไม่ได้มาแทน CPU ที่เป็นสมองหลักของคอมพิวเตอร์ แต่มาทำหน้าที่ “ผู้ช่วยพิเศษ” ที่เก่งงานบางอย่างกว่าหลายร้อยเท่า — งานนั้นคือ การคูณเมทริกซ์ขนาดใหญ่ ซึ่งเป็นหัวใจของ AI ทุกตัว (เดี๋ยวเราจะเจาะลึกในบทที่ 3)
ในแผนผังเมกะเทรนด์ node นี้เป็นสาขาย่อยภายใต้ Artificial Intelligence และนิยามของมันบอกชัดว่าเป็น “ชั้นที่ ขาดแคลน (supply-constrained) ที่สุด” ของทั้งเทรนด์ — พูดง่ายๆ คือไม่ว่าใครจะมีไอเดีย AI เจ๋งแค่ไหน ถ้าไม่มีชิป ก็ทำอะไรไม่ได้
CPU = สมองอเนกประสงค์ ทำได้ทุกอย่างแต่ทีละเรื่อง · GPU (Graphics Processing Unit) = ชิปที่มีคอร์เล็กๆ นับพัน ทำงานพร้อมกันได้ เดิมออกแบบไว้เรนเดอร์ภาพเกม แต่กลับเหมาะกับ AI พอดี · ASIC (Application-Specific Integrated Circuit) = ชิป “สั่งทำ” ที่ออกแบบมาเพื่องานเดียวโดยเฉพาะ เลยเร็วและประหยัดไฟกว่าในงานนั้น แต่ทำอย่างอื่นไม่ได้ — TPU ของ Google และ Trainium ของ Amazon คือ ASIC
node นี้กว้างกว่าที่คิด มันครอบคลุมตั้งแต่ GPU สำหรับศูนย์ข้อมูล (GPU & Merchant Accelerators), ชิปสั่งทำของยักษ์เทค (Custom Silicon / ASIC), ชิปที่เน้นการรันโมเดลโดยเฉพาะ (Inference-Optimized Silicon), หน่วยความจำพิเศษ HBM (HBM & AI Memory) ไปจนถึงชิป AI ในอุปกรณ์พกพา (Edge & On-device AI Silicon) — บทเรียนนี้จะร้อยทั้งหมดเข้าด้วยกัน
02ทำไมมันถึงเป็นชั้นที่ขาดที่สุดของยุค AI
เหตุผลแรกคือ ขนาดของเงิน ในปีงบ 2026 รายได้ของ NVIDIA แตะ $215,900 ล้าน โต 65% เฉพาะธุรกิจชิปศูนย์ข้อมูล (data center) ก็เกิน $200,000 ล้านแล้ว — จากที่เคยทำได้ $115,200 ล้านในปีก่อนหน้า นี่ไม่ใช่การเติบโตแบบบริษัททั่วไป แต่คือบริษัทเดียวที่ดูดเงินลงทุน AI ของทั้งโลกเข้ามาเป็นกระแสหลัก
เหตุผลที่สองคือ ตลาดนี้กำลังพองตัวมหาศาล ภาพรวมตลาดชิป AI accelerator อยู่ที่ราว $140,000 ล้านในปี 2024 และหลายสำนักประเมินว่าจะโตทะลุ $400,000–600,000 ล้านภายในปี 2030–2033 ที่อัตราโตเฉลี่ย ~16–25% ต่อปี บางสำนัก (Bloomberg Intelligence) ถึงกับมองว่าเฉพาะ accelerator จะเกิน $600,000 ล้านในปี 2033 และถ้านับทั้งสแต็ก (รวมหน่วยความจำ เครือข่าย CPU) อาจแตะ ~$1.7 ล้านล้าน
เหตุผลที่สามคือคำว่า “ขาดแคลน” ไม่ใช่คำพูดเกินจริง NVIDIA จองกำลังผลิตชิป Blackwell รุ่นใหม่ (B200) เกือบหมดยาวถึงกลางปี 2026 และจัดสรรให้ลูกค้ารายใหญ่อย่าง Microsoft, Google, Amazon, Meta ก่อน คอขวดไม่ได้อยู่ที่ดีมานด์ แต่อยู่ที่ กำลังผลิต — โดยเฉพาะขั้นตอนแพ็กเกจชิปขั้นสูง (CoWoS) ที่ใช้ต่อ HBM เข้ากับ GPU
03มันทำงานยังไง — การคูณเมทริกซ์ และทำไมต้องเป็น GPU
เพื่อเข้าใจทุกอย่างในบทเรียนนี้ ต้องเข้าใจความจริงข้อเดียว: เบื้องหลัง AI เกือบทั้งหมดคือการ “คูณเมทริกซ์” (matrix multiplication) — การเอาตารางตัวเลขใหญ่ๆ สองตารางมาคูณกัน ซ้ำแล้วซ้ำเล่าเป็นพันล้านครั้ง โมเดลภาษาขนาดใหญ่ที่มีพารามิเตอร์เป็นล้านล้านตัว แท้จริงก็คือกองเมทริกซ์มหึมาที่ต้องคูณกันไม่หยุด
ทีนี้ความมหัศจรรย์อยู่ตรงนี้: การคูณเมทริกซ์ “แตกออกเป็นชิ้นเล็กๆ ที่คำนวณพร้อมกันได้” — ตัวเลขแต่ละช่องในผลลัพธ์ คำนวณแยกจากกันได้โดยไม่ต้องรอกัน นี่คือเหตุผลที่ CPU ซึ่งมีคอร์น้อยแต่ทำงานทีละเรื่องอย่างรวดเร็ว สู้ไม่ได้เลย ขณะที่ GPU ซึ่งมีคอร์เล็กๆ นับ พันถึงหมื่น คอร์ สามารถแบ่งงานคูณออกเป็นชิ้นเล็กๆ แล้วลุยพร้อมกันทั้งหมด
แต่นี่ก็เปิดประตูให้ทางเลือกที่สอง: ถ้างานคือการคูณเมทริกซ์อย่างเดียวจริงๆ ทำไมไม่ออกแบบชิปที่ทำ เฉพาะ งานนั้นให้ดีที่สุดไปเลย? นี่คือไอเดียของ ASIC — ชิปสั่งทำ GPU เก่งหลายอย่าง (ความยืดหยุ่นคือจุดแข็ง) แต่ ASIC อย่าง TPU ของ Google ตัดทุกอย่างที่ไม่จำเป็นทิ้ง เหลือแต่หน่วยคูณเมทริกซ์ขนาดยักษ์ ผลคือในงานที่มันถูกออกแบบมา มันมักประหยัดไฟและถูกกว่าต่อการคำนวณ — แลกกับการที่มันทำงานอื่นไม่ได้และพัฒนายากกว่า
ชิป AI เร็วแค่ไหนก็ไร้ค่า ถ้า “ป้อนข้อมูล” ให้ไม่ทัน ทุกตัวจึงต้องพึ่งหน่วยความจำพิเศษชื่อ HBM (High Bandwidth Memory) ที่ซ้อนกันในแนวตั้งและวางติดกับชิป เช่น Blackwell ของ NVIDIA ใช้ HBM3E 192GB แบนด์วิดท์ 8 TB/s นี่คือจุดที่ node นี้บรรจบกับ HBM & AI Memory โดยตรง — และคอขวด HBM ก็คือคอขวดของชิป AI ทั้งวงการ
04ฝึก vs ใช้งาน — สมรภูมิที่กำลังเปลี่ยนมือ
ชิป AI ทำงานสองโหมดที่ต่างกันมาก และความต่างนี้กำลังกำหนดอนาคตของทั้งอุตสาหกรรม
- Training (การฝึก): สอนโมเดลครั้งใหญ่ครั้งเดียว — กินพลังมหาศาล ต้องใช้ GPU หมื่นๆ ตัวต่อกันเป็นเดือน งานนี้ซับซ้อน ยืดหยุ่น และผูกกับซอฟต์แวร์ของ NVIDIA แน่นมาก
- Inference (การใช้งาน): เอาโมเดลที่ฝึกแล้วมา “รัน” ตอบคำถามจริง — เกิดขึ้นนับล้านครั้งต่อวัน ทุกครั้งที่มีคนพิมพ์ถาม งานนี้ทำซ้ำๆ คาดเดาได้ จึงเหมาะกับชิปสั่งทำที่ประหยัดกว่า
จุดพลิกคือ เมื่อ AI แพร่หลาย น้ำหนักของการใช้งานจริง (inference) จะมากกว่าการฝึกเรื่อยๆ และนี่คือ จุดอ่อนที่สุดของคูเมือง NVIDIA เพราะคูเมืองที่ชื่อ CUDA ถูกสร้างมาเพื่อ “การฝึก” เป็นหลัก พอโลกเลื่อนไปทาง inference ความจำเป็นต้องพึ่ง CUDA ก็คลายลง — เปิดช่องให้ ASIC ของยักษ์เทคและชิป inference เฉพาะทาง (Inference-Optimized Silicon) แทรกเข้ามาได้
CUDA คือชุดซอฟต์แวร์ของ NVIDIA ที่ให้นักพัฒนาสั่งงาน GPU ได้ ความน่ากลัวคือ ไลบรารีและเฟรมเวิร์ก AI เกือบทั้งโลกถูกปรับแต่งมาให้ทำงานบน CUDA และนักพัฒนานับล้านเรียนรู้มันมาทั้งอาชีพ การย้ายไปใช้ชิปยี่ห้ออื่นจึงแพงและเสียเวลาจนแทบไม่คุ้ม — นี่คือ “คูเมือง” ที่แท้จริงของ NVIDIA ที่ทำให้คู่แข่งที่มีชิปดีเท่ากันก็ยังแย่งลูกค้าได้ยาก
เหตุผลทางเศรษฐกิจง่ายมาก: ถ้าชิปสั่งทำของ Google, Amazon หรือ Microsoft ทำงาน inference ได้ราว 80% ของ GPU แต่ ต้นทุนรวม (TCO) ถูกกว่าราว 40% ยักษ์เหล่านี้ก็มีแรงจูงใจมหาศาลที่จะย้ายงาน inference ภายในของตัวเองออกจาก NVIDIA — และนั่นกำลังเกิดขึ้นจริง
05มันเชื่อมกับอะไรในระบบนิเวศ
ชั้นชิป AI ไม่ได้ลอยอยู่เดี่ยวๆ มันคือจุดที่เทรนด์ใหญ่หลายตัวมาบรรจบ:
- เป็นรากของ AI ทั้งหมด: โมเดล แอป และ AI ตัวแทน (agent) ทุกอย่างที่อยู่ชั้นบน ล้วนตั้งอยู่บนชิปชั้นนี้ — ถ้าชิปขาด ทั้งเทรนด์สะดุด
- บรรจบกับ Semiconductors ทั้งสาย: ชิป AI คือลูกค้ารายใหญ่ที่สุดของวงการชิป ทั้งฝั่งคำนวณ (Logic), หน่วยความจำ (Memory / HBM) และการผลิต (Foundry) ที่ TSMC ผลิตชิป AI ระดับล้ำสุดเกือบทั้งหมด
- ดูดพลังจาก Energy Transition & Power: ศูนย์ข้อมูล AI กินไฟมหาศาลจนกลายเป็นแรงขับสำคัญของดีมานด์ไฟฟ้าโลก — node นี้ “drives demand” ให้พลังงานโดยตรง
- พึ่ง Critical Materials: เวเฟอร์ซิลิคอนคุณภาพสูง สารเคมีพิเศษ และวัสดุหายากเป็นวัตถุดิบที่ขาดไม่ได้
- เริ่มที่ซอฟต์แวร์ออกแบบ (EDA & IP): ก่อนชิปตัวไหนจะเกิด ทุกดีไซน์ต้องผ่านซอฟต์แวร์ออกแบบ (EDA) ของ Synopsys/Cadence และบล็อก IP อย่างแกน Arm — ชั้นต้นน้ำที่เก็บค่าผ่านทางจากทุกค่าย (ดู EDA & Semiconductor IP)
- ไม่ได้อยู่แค่ในศูนย์ข้อมูล: ไม่ใช่ชิป AI ทุกตัวที่วิ่งในศูนย์ข้อมูล — NPU ในมือถือ พีซี และรถยนต์รัน inference อยู่บนเครื่อง (on-device) เพื่อความเร็วและความเป็นส่วนตัว (ดู Edge & On-device AI Silicon)
- ปลดล็อกเทรนด์อื่น: ชิป AI “enables” ทั้ง Robotics, Biotech และ Cybersecurity — เป็นโครงสร้างพื้นฐานที่เทรนด์อื่นยืนอยู่บน
มองในมุมห่วงโซ่คุณค่า node นี้คือ “คอขวด” ที่อำนาจกระจุกตัวมากที่สุด เพราะมันรวมเอาความยากสามชั้นไว้ด้วยกัน — การออกแบบชิป (ที่ NVIDIA นำ), การผลิต (ที่ TSMC ผูกขาดระดับล้ำสุด) และหน่วยความจำ HBM (ที่มีผู้ผลิตแค่ 3 ราย) ใครก็ตามที่อยากแข่ง ต้องฝ่าทั้งสามด่านพร้อมกัน
06ตอนนี้ไปถึงไหนแล้ว + ผู้เล่นตัวจริง
ภาพปัจจุบันคือ “หนึ่งยักษ์ + กองทัพผู้ท้าชิง” NVIDIA ยังครองตลาด AI accelerator ราว 80–90% โดยรายได้ ในปี 2024–2025 (เคยแตะ ~90% ในปี 2024) แต่นักวิเคราะห์คาดว่าส่วนแบ่งจะค่อยๆ ลดเหลือ ~75% ภายในปี 2026 — ไม่ใช่เพราะ NVIDIA โตช้าลง แต่เพราะ เค้กทั้งก้อนโตเร็วกว่าที่ใครคนเดียวจะกินหมด
ความต่างที่เล่าเรื่องได้ชัดที่สุดคือ อัตรากำไร ในไตรมาสที่สิ้นสุด ต.ค. 2025 กำไรขั้นต้นของ NVIDIA อยู่ที่ราว 73% ขณะที่ AMD ซึ่งเป็นคู่แข่งเบอร์สองอยู่ที่ราว 50% ช่องว่างนี้คือ “ค่าคูเมือง CUDA” ที่ NVIDIA เก็บได้ — และเป็นเหตุผลที่ทุกยักษ์เทคอยากออกแบบชิปเองเพื่อเลี่ยงค่าต๋งนี้
การไล่ของฝั่งชิปสั่งทำเริ่มมีน้ำหนักจริง: Broadcom และ Marvell รับออกแบบ ASIC ให้ยักษ์เทคเกือบทั้งหมด คุมตลาดนี้รวมกันราว 80–95% และออเดอร์ชิปสั่งทำกำลังพุ่งแรง (เจาะลึกใครสั่งใครเท่าไรในบทของ node นั้น)
07อนาคตข้างหน้า
ทิศทางแรกคือ การเลื่อนน้ำหนักไปทาง inference เมื่อ AI ฝังตัวในทุกแอปและทุกอุปกรณ์ การ “รัน” โมเดลจะกินคอมพิวต์มากกว่าการ “ฝึก” เรื่อยๆ ซึ่งเป็นสนามที่ชิปสั่งทำและชิปเฉพาะทางได้เปรียบเรื่องต้นทุน — นี่คือช่องที่จะกัดกร่อนส่วนแบ่ง (แต่ไม่ใช่ความเป็นผู้นำ) ของ NVIDIA ทีละน้อย
ทิศทางที่สองคือ ยักษ์เทคทุกรายจะมีชิปของตัวเอง Google, Amazon, Microsoft, Meta และ OpenAI ต่างทุ่มเงินสร้าง ASIC ผ่าน Broadcom/Marvell เพื่อลดการพึ่ง NVIDIA และคุมต้นทุนคลาวด์ของตัวเอง — เปลี่ยนภูมิทัศน์จาก “ทุกคนซื้อจาก NVIDIA” เป็น “ลูกค้ารายใหญ่ที่สุดกลายเป็นคู่แข่งด้วย”
ทิศทางที่สามคือ ชิป AI ลงสู่ขอบ (edge) ไม่ใช่ทุกงาน AI ที่ต้องวิ่งในศูนย์ข้อมูล มือถือ รถยนต์ และอุปกรณ์ IoT เริ่มมีชิป AI ในตัว (Edge & On-device AI Silicon) เพื่อความเร็ว ความเป็นส่วนตัว และประหยัดค่าคลาวด์ — เปิดตลาดใหม่ที่ผู้เล่นมือถืออย่าง Qualcomm และ Apple ได้เปรียบ
ทิศทางที่สี่คือ คอขวดย้ายที่ วันนี้คอขวดอยู่ที่ HBM และการแพ็กเกจ (CoWoS) พรุ่งนี้อาจย้ายไปที่ พลังงานและการระบายความร้อน — เพราะศูนย์ข้อมูล AI กินไฟจนเริ่มชนเพดานโครงข่ายไฟฟ้า ใครแก้คอขวดถัดไปได้ก่อน ก็ได้เปรียบ
08ความท้าทายและความเสี่ยง
เสน่ห์ของชั้นชิป AI มาพร้อมความเสี่ยงที่เฉพาะตัว
ความเสี่ยงข้อแรกคือ การกระจุกตัวสุดขั้ว มูลค่ามหาศาลผูกกับบริษัทไม่กี่ราย — NVIDIA ฝั่งออกแบบ, TSMC ฝั่งผลิต, และผู้ผลิต HBM แค่ 3 ราย ถ้าจุดใดจุดหนึ่งสะดุด (ภัยพิบัติ ภูมิรัฐศาสตร์ หรือเทคนิค) ทั้งห่วงโซ่สะเทือน และเพราะการผลิตล้ำสุดกระจุกที่ไต้หวัน ความเสี่ยงภูมิรัฐศาสตร์จึงไม่ใช่เรื่องไกลตัว
ความเสี่ยงข้อสองคือ คูเมือง CUDA อาจไม่กว้างเท่าเดิม ตราบใดที่งานเป็นการฝึกโมเดล CUDA ยังเหนียวแน่น แต่เมื่อโลกเลื่อนไป inference การพึ่ง CUDA ก็คลายลง ถ้าชิปสั่งทำของยักษ์เทคทำงานได้ดีพอที่ต้นทุนต่ำกว่ามาก ส่วนแบ่งและมาร์จิ้นระดับ 73% ของเจ้าตลาดก็อาจถูกบีบ — บทเรียนของวงการชิปคือ “ผู้นำวันนี้ พลาดคลื่นเทคโนโลยีลูกเดียวก็ร่วงได้”
ความเสี่ยงข้อสามคือ คำถามเรื่องวัฏจักรและฟองสบู่ ดีมานด์ชิป AI ตอนนี้แรงมากเพราะยักษ์เทคทุ่มลงทุน (capex) มหาศาลพร้อมกัน ถ้าผลตอบแทนจาก AI มาช้ากว่าที่คาด หรือการลงทุนชะลอ ดีมานด์ที่ดูไม่มีวันเต็มอาจหดตัวเร็ว — เพราะส่วนใหญ่มาจากลูกค้ากระเป๋าหนักกลุ่มเดียวกันไม่กี่ราย
สรุปสั้นๆ: ชิป AI accelerator คือ “ก๊อกน้ำ” ที่เปิด-ปิดยุคปัญญาประดิษฐ์ได้จริง วันนี้บริษัทเดียวคุมก๊อกนั้นไว้ด้วยซอฟต์แวร์มากกว่าตัวชิป แต่สนามกำลังเปลี่ยน เมื่อโลกเลื่อนจาก “การฝึก” ไปสู่ “การใช้งาน” และลูกค้ารายใหญ่ที่สุดเริ่มสร้างชิปของตัวเอง — เข้าใจชั้นนี้ ก็เข้าใจว่าทำไมมันถึงเป็นทั้งหัวใจและคอขวดของเศรษฐกิจ AI ทั้งใบ