Megatrend · Artificial Intelligence
การ์ดเร่ง AI ที่ “ใครก็ซื้อได้” — และคนขายพลั่วที่รวยที่สุดในยุคตื่นทอง
ในศึก AI ที่ทุกบริษัทแย่งกันสร้างโมเดล มีของชิ้นเดียวที่ทุกคนต้องซื้อก่อนเริ่มเล่น — การ์ดเร่งความเร็ว (accelerator) ที่ขายแบบ “เปิดร้านให้ใครก็เดินมาซื้อ” ไม่ใช่ชิปลับที่ยักษ์เทคทำใช้เอง บทเรียนนี้พาไปดูว่าทำไมการฝึก AI ต้องใช้ GPU เป็นพันเป็นหมื่นใบขนานกัน ทำไมบริษัทเดียวถึงกินตลาดนี้ไปเกือบ 90% ด้วย “คูเมือง” ที่ทำจากซอฟต์แวร์ และ AMD กับ Intel ผู้ท้าชิงจะแหวกเข้ามาได้แค่ไหน
01มันคืออะไร (การ์ดเร่ง AI ที่ “ใครก็ซื้อได้”)
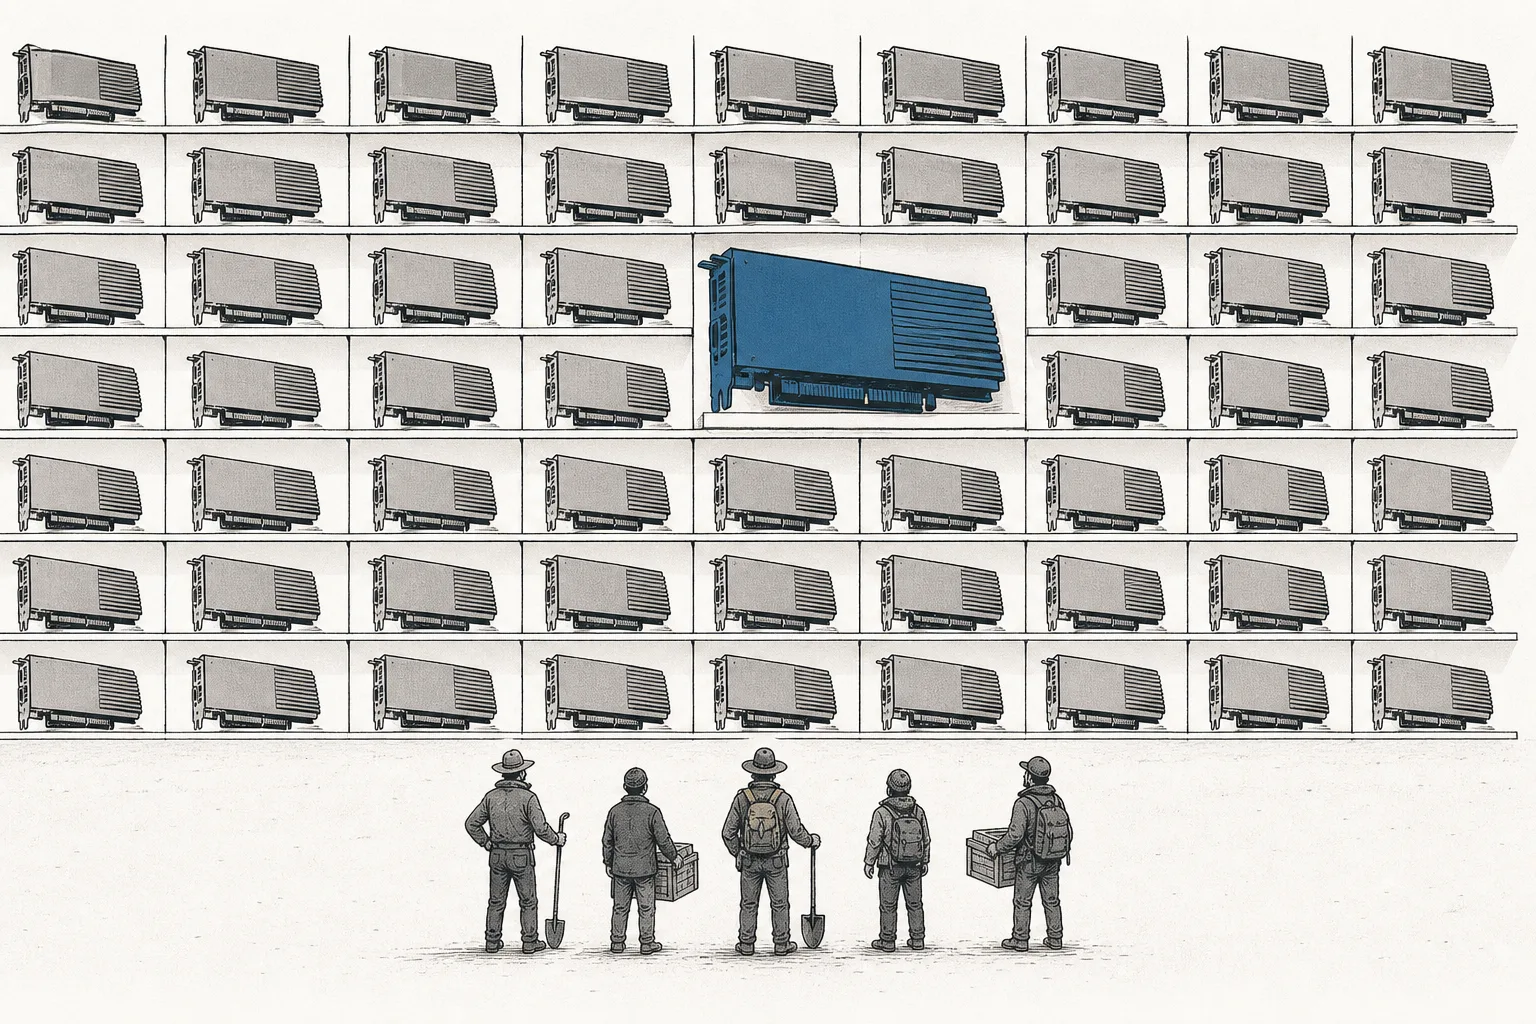
ลองนึกภาพร้านขายเครื่องมือช่างที่เปิดให้ใครเดินเข้ามาซื้อก็ได้ — ตั้งแต่บริษัทยักษ์ใหญ่ ไปจนถึงสตาร์ทอัพห้องเดียว ทุกคนซื้อของรุ่นเดียวกันจากชั้นวางเดียวกัน นั่นคือหัวใจของคำว่า “merchant” (ขายแบบพาณิชย์) — การ์ดเร่งความเร็ว AI ที่ผลิตเป็นมาตรฐาน วางขายให้ทุกคน ไม่ใช่ชิปลับที่ออกแบบมาให้บริษัทเดียวใช้เอง
node นี้คือเรื่องของ การ์ดเร่ง (accelerator) แบบ “ซื้อมาเสียบใช้ได้เลย” — ส่วนใหญ่คือ GPU สำหรับศูนย์ข้อมูล อย่างชิปตระกูล Blackwell ของ NVIDIA, Instinct ของ AMD หรือการ์ดของ Intel ที่ทุกคนสั่งซื้อได้เหมือนกัน คำว่า “accelerator” (ตัวเร่ง) สำคัญ เพราะมันไม่ได้มาแทน CPU ที่เป็นสมองหลักของเครื่อง แต่มาเป็น “ผู้ช่วยพิเศษ” ที่เก่งงานเดียวกว่าหลายร้อยเท่า — งานนั้นคือการคูณเมทริกซ์ขนาดยักษ์ ซึ่งเป็นหัวใจของ AI ทุกตัว (เดี๋ยวเราเจาะลึกในบทที่ 3)
ในแผนผังเมกะเทรนด์ node นี้เป็นสาขาย่อยภายใต้ AI Compute & Accelerator Silicon ในเทรนด์ใหญ่ Artificial Intelligence จุดที่ทำให้มันต่างจากพี่น้องข้างกันคือคำว่า “merchant” นั่นเอง — มันไม่ใช่ Custom Silicon / ASIC (ชิปสั่งทำที่ Google, Amazon ออกแบบให้ตัวเองใช้คนเดียว) และไม่ใช่ Inference-Optimized Silicon (ชิปที่ตัดมาเน้นงาน “รัน” โมเดลโดยเฉพาะ) แต่เป็นการ์ดอเนกประสงค์ที่ทำได้ทั้งฝึกและรัน วางขายเป็นมาตรฐานในตลาดเปิด
Merchant GPU = การ์ดที่ผลิตเป็นมาตรฐานแล้ววางขายให้ทุกคน (NVIDIA, AMD, Intel) — ยืดหยุ่น ทำได้ทั้งฝึกและรัน เปลี่ยนงานได้ · Custom ASIC = ชิป “สั่งทำ” ที่ยักษ์เทคออกแบบให้ตัวเองใช้คนเดียว (TPU ของ Google, Trainium ของ Amazon) — ประหยัดกว่าในงานเฉพาะ แต่ทำอย่างอื่นไม่ได้และคนนอกซื้อไม่ได้ · เส้นแบ่งคือ “ขายให้ทุกคน” vs “ทำให้ตัวเอง” — node นี้คือฝั่งแรก
02ทำไมถึงสำคัญ — พลั่วและจอบของยุค AI
มีประโยคคลาสสิกที่ใช้ได้กับวงการนี้แบบไม่มีอะไรเหมาะกว่า: ในยุคตื่นทอง คนที่รวยแน่ๆ ไม่ใช่นักขุดทอง แต่เป็นคนขายพลั่วกับจอบ ไม่ว่าศึก AI จะจบลงที่ OpenAI, Google หรือสตาร์ทอัพหน้าใหม่เจ้าไหน — ทุกคนต้องซื้อการ์ดเร่งพวกนี้ก่อนถึงจะเริ่มฝึกโมเดลได้ node นี้คือร้านที่ขายพลั่วให้ทุกคนในสนาม และร้านที่ขายดีที่สุดก็เก็บค่าผ่านทางได้มหาศาล
ขนาดของเงินบอกเรื่องนี้ชัดเจน ในปีงบ 2026 รายได้ของ NVIDIA แตะ $215,900 ล้าน โต 65% และเฉพาะไตรมาสสุดท้าย รายได้ธุรกิจศูนย์ข้อมูลทำสถิติ $62,300 ล้านในไตรมาสเดียว โต 75% จากปีก่อน — นี่ไม่ใช่การเติบโตแบบบริษัททั่วไป แต่คือบริษัทเดียวที่ดูดเงินลงทุน AI ของทั้งโลกเข้ามาเป็นกระแสหลัก
แต่สิ่งที่ทำให้ node นี้ทรงพลังกว่าแค่ขนาดตลาด คือ กำไรที่เก็บได้ ในรอบล่าสุด NVIDIA ทำกำไรขั้นต้น (gross margin) ราว 73% — แปลว่าทุกๆ 100 บาทที่ขายการ์ดได้ เหลือเป็นกำไรขั้นต้นถึง 73 บาท ตัวเลขระดับนี้สำหรับธุรกิจที่ขาย “ฮาร์ดแวร์” เป็นเรื่องผิดธรรมชาติ และมันคือสัญญาณว่ามีคูเมืองบางอย่างที่ทำให้ลูกค้ายอมจ่ายแพงโดยไม่หนีไปไหน (เดี๋ยวเราจะเจาะว่าคูเมืองนั้นคืออะไรในบทที่ 4)
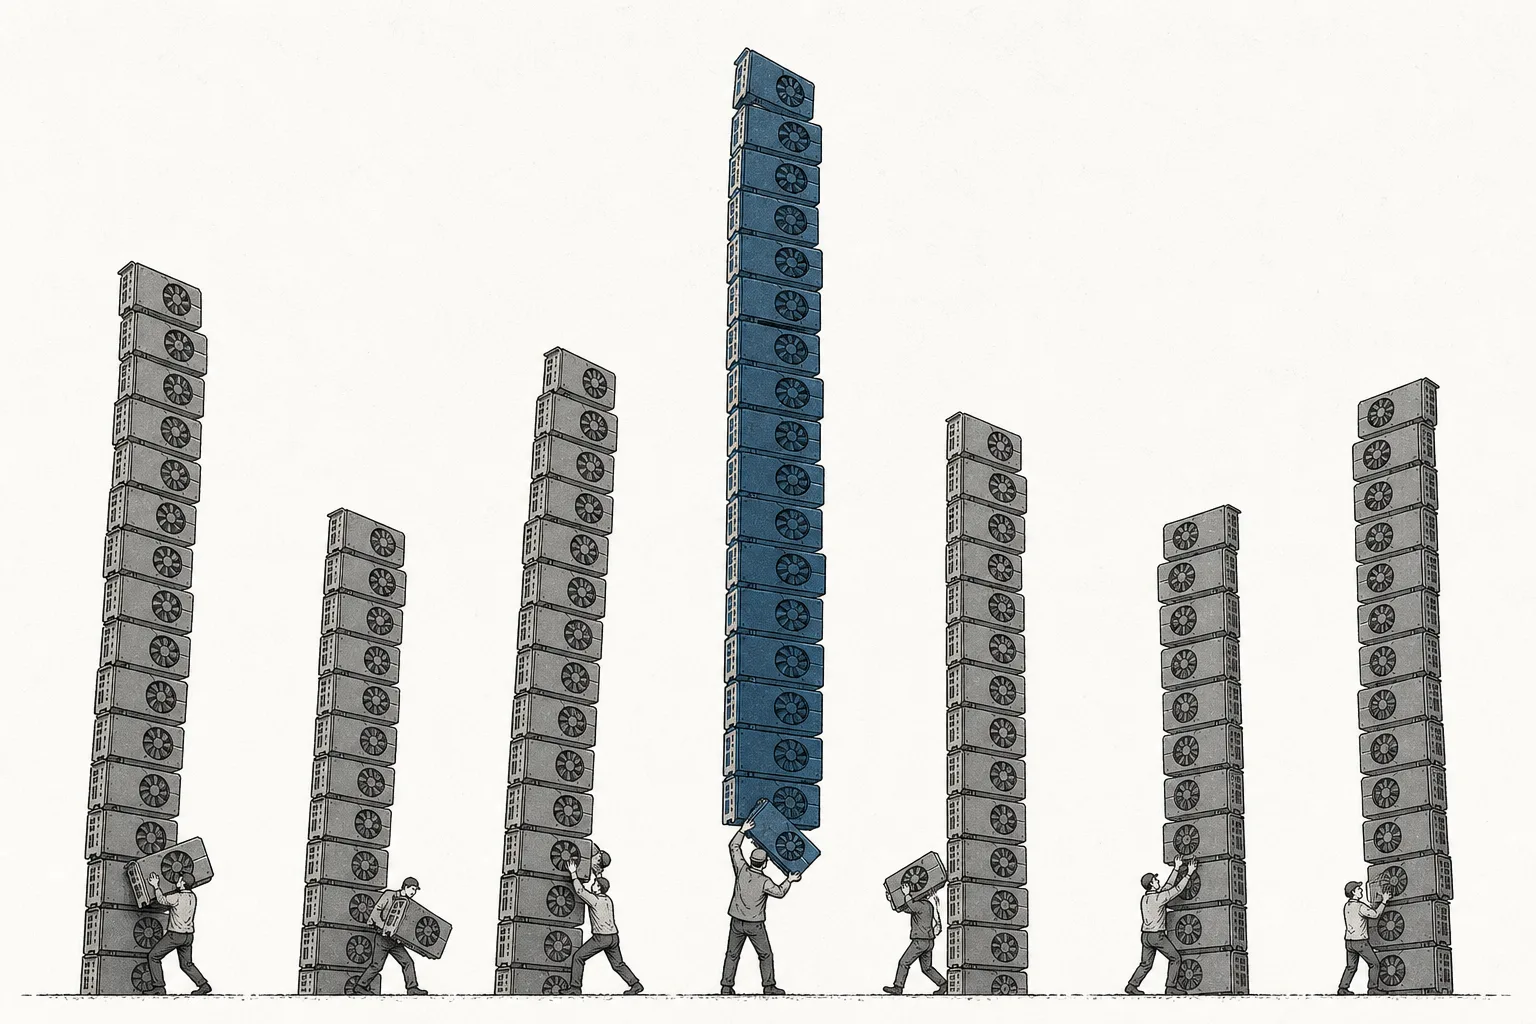
ทำไมทุกคนถึงต้องซื้อ “ตอนนี้” พร้อมกันหมด? เพราะนี่คือ การแข่งสะสมพลังคำนวณ (compute arms race) — บริษัทที่มีการ์ดเร่งมากกว่า ฝึกโมเดลที่ใหญ่กว่าและฉลาดกว่าได้ก่อน คู่แข่งจึงไม่กล้ารอ ผลคือยักษ์เทคทุ่มงบลงทุน (capex) รวมกันราว $410,000 ล้านในปี 2025 และตั้งงบไว้ราว $600,000–725,000 ล้านในปี 2026 โดยกว่า 75% เทไปที่โครงสร้างพื้นฐาน AI — และก้อนแรกที่เงินนั้นวิ่งไปถึงเสมอ คือชั้นการ์ดเร่งนี้
03มันทำงานยังไง — จากโมเดลหนึ่งตัว ถึง GPU พันใบที่ลุยพร้อมกัน
เพื่อเข้าใจว่าทำไม AI ถึง “กิน” การ์ดเร่งไม่อั้น ต้องเข้าใจความจริงข้อเดียว: เบื้องหลัง AI เกือบทั้งหมดคือการคูณเมทริกซ์ — การเอาตารางตัวเลขมหึมาสองตารางมาคูณกัน ซ้ำเป็นพันล้านครั้ง ความมหัศจรรย์อยู่ตรงที่งานนี้ “แตกเป็นชิ้นเล็กๆ ที่คำนวณพร้อมกันได้” ตัวเลขแต่ละช่องในผลลัพธ์คำนวณแยกกันได้โดยไม่ต้องรอกัน นี่คือเหตุผลที่ GPU ซึ่งมีคอร์เล็กๆ นับพันถึงหมื่นคอร์ ลุยงานนี้ได้เร็วกว่า CPU ที่ทำทีละเรื่องหลายร้อยเท่า
แต่โมเดลยุคนี้ใหญ่เกินกว่า GPU ใบเดียวจะรับไหว โมเดลภาษาขนาดใหญ่หนึ่งตัวมีพารามิเตอร์เป็นล้านล้านตัว ใหญ่จนต้อง หั่นโมเดลแล้วกระจายลง GPU หลายพันใบที่ต่อกันเป็นคลัสเตอร์เดียว ลองไล่ดูทีละก้าวว่างานนี้เดินยังไง
ตัวเลขจริงทำให้เห็นภาพ: GPT-4 ถูกฝึกบนการ์ดราว 25,000 ใบ (รุ่น A100) ทำงานต่อเนื่องเป็นเดือนๆ พอถึงปี 2024–2025 คลัสเตอร์ฝึกโมเดลระดับแนวหน้าไต่ขึ้นไปถึง 100,000 ใบ (เช่นคลัสเตอร์ของ xAI ที่เมมฟิส) และมีแผนคลัสเตอร์ระดับ 300,000 ใบขึ้นไป ตามมา — นี่คือเหตุผลที่ดีมานด์การ์ดเร่งดูเหมือนไม่มีเพดาน เพราะทุกครั้งที่อยากได้โมเดลที่ฉลาดขึ้น วิธีที่ตรงที่สุดคือ “ใส่การ์ดเพิ่ม” และ เครือข่ายที่ต่อการ์ดพันใบให้คุยกันเร็ว ก็สำคัญพอๆ กับตัวการ์ดเอง — รายได้ส่วนเครือข่ายของ NVIDIA ในไตรมาสเดียวโตถึง 142% เพราะเหตุนี้
04ระบบนิเวศ — CUDA, ชิปสั่งทำ และวงการชิป
คำถามที่นักลงทุนทุกคนถามคือ ในเมื่อ AMD ก็ทำการ์ดที่แรงพอกัน ทำไมตลาดถึงยังกระจุกอยู่ที่ NVIDIA เกือบเบ็ดเสร็จ? คำตอบไม่ได้อยู่ที่ตัวการ์ด แต่อยู่ที่ ซอฟต์แวร์ชื่อ CUDA — และนี่คือสิ่งที่ทำให้ node นี้ต่างจากธุรกิจฮาร์ดแวร์ทั่วไป
CUDA คือชุดซอฟต์แวร์ของ NVIDIA ที่ให้นักพัฒนาสั่งงาน GPU ได้ จุดที่น่ากลัวคือ ไลบรารีและเฟรมเวิร์ก AI เกือบทั้งโลกถูกปรับแต่งมาให้ทำงานบน CUDA และมีนักพัฒนากว่า 4 ล้านคน กับองค์กรกว่า 40,000 แห่ง ที่ใช้มันจนชำนาญ การย้ายไปใช้ชิปยี่ห้ออื่นต้องเขียนโค้ดใหม่ ปรับจูนใหม่ และเสี่ยงว่าจะช้าลง — แพงและเสียเวลาจนหลายทีมไม่กล้าเสี่ยง นี่คือ “คูเมือง” ที่ทำให้คู่แข่งที่มีการ์ดดีพอๆ กันก็ยังแย่งลูกค้าได้ยาก
เพื่อเข้าใจว่า node นี้ยืนตรงไหน ต้องดูเทียบกับพี่น้องในตระกูลเดียวกัน — และความต่างนี้คือกุญแจของทั้งบทเรียน:
- ต่างจากชิปสั่งทำ — Custom Silicon / ASIC: Google (TPU), Amazon (Trainium), Meta (MTIA) ออกแบบชิปให้ ตัวเองใช้คนเดียว เพื่อเลี่ยงค่าต๋ง 73% ของ NVIDIA คนนอกซื้อไม่ได้ ขณะที่การ์ด merchant ของ node นี้ขายให้ทุกคน — เส้นแบ่งคือ “ทำใช้เอง” vs “ขายให้ทุกคน”
- ต่างจากชิปเน้นรัน — Inference-Optimized Silicon: การ์ด merchant ทำได้ทั้ง “ฝึก” (train) และ “รัน” (inference) ส่วนชิป inference เฉพาะทางตัดมาเน้นงานรันโมเดลที่ทำซ้ำๆ ให้ถูกและประหยัดไฟกว่า — เป็นสนามที่ผู้ท้าชิงพยายามแทรกเข้ามา
- เป็นชิป “logic” ของวงการชิป — Logic / Compute (Semiconductors): ในเชิงเทคนิค การ์ดเร่งเหล่านี้คือชิปประมวลผลแบบ logic ที่ผลิตด้วยเทคโนโลยีล้ำสุด มุมมองของ node นี้คือ “ทำไม AI ถึงต้องการมัน” ส่วนเรื่องการผลิตชิป logic โดยทั่วไปอยู่ในเทรนด์ Semiconductors
- คู่กับหน่วยความจำ HBM และการผลิต: การ์ดเร่งเร็วแค่ไหนก็ไร้ค่าถ้าป้อนข้อมูลไม่ทัน ทุกใบจึงต้องพึ่งหน่วยความจำพิเศษ HBM และการผลิต/แพ็กเกจขั้นสูง (Foundry & Contract Fabrication) ที่ TSMC ทำเกือบทั้งหมด — คอขวด HBM และ CoWoS คือคอขวดของทั้งวงการ
- ป้อนพลังให้ AI Cloud & Platforms และดูดไฟจาก Energy Transition & Power: การ์ดเหล่านี้คือเครื่องจักรในศูนย์ข้อมูล AI ที่กินไฟมหาศาลจนกลายเป็นแรงขับดีมานด์ไฟฟ้าโลก
05ตอนนี้ไปถึงไหนแล้ว (2025–2026)
ภาพปัจจุบันคือ “หนึ่งยักษ์ + กองทัพผู้ท้าชิง” NVIDIA ยังครองตลาดการ์ดเร่ง AI ราว 80–90% โดยรายได้ (เคยแตะ ~92% ในกลุ่มการ์ดศูนย์ข้อมูลระดับสูงช่วงปี 2025) แต่นักวิเคราะห์คาดว่าส่วนแบ่งจะค่อยๆ ลดเหลือราว 75% ภายในปลายปี 2026 — ไม่ใช่เพราะ NVIDIA โตช้าลง แต่เพราะเค้กทั้งก้อนโตเร็วกว่าที่ใครคนเดียวจะกินหมด
เครื่องยนต์ของ NVIDIA ตอนนี้คือชิปตระกูล Blackwell ที่กำลังเร่งส่งมอบ — รุ่น GB300 เพิ่งแซง GB200 จนกินสัดส่วนราวสองในสามของรายได้ Blackwell แล้ว ความน่ากลัวคือ NVIDIA เดินเครื่องด้วย จังหวะออกสถาปัตยกรรมใหม่ทุกปี (Hopper 2022 → Blackwell 2024–25 → Rubin ปลายปี 2026) ทำให้คู่แข่งวิ่งตามแทบไม่ทัน เพราะพอจะตามทันรุ่นหนึ่ง NVIDIA ก็ออกรุ่นใหม่แล้ว
ฝั่งผู้ท้าชิงเริ่มมีน้ำหนักจริง AMD คือคู่แข่ง merchant เบอร์สองที่ชัดที่สุด — การ์ด Instinct MI350 มาพร้อมหน่วยความจำ HBM3E 288GB (มากกว่าของ NVIDIA) และรุ่น MI400 กำลังจะมาในปี 2026 รายได้ธุรกิจศูนย์ข้อมูลของ AMD ในไตรมาสล่าสุดแตะ $5,800 ล้าน โต 57% และดีลใหญ่ที่สุดคือ Meta ประกาศจะติดตั้งการ์ด AMD ระดับ 6 กิกะวัตต์ จุดอ่อนที่ AMD ยังต้องไล่คือซอฟต์แวร์ ROCm ที่ยังตามหลัง CUDA อยู่หลายก้าว — แต่ก็ค่อยๆ ดีขึ้นเรื่อยๆ
ส่วน Intel เป็นบทเรียนของความยากในสนามนี้ — สาย Gaudi ถูกปิดฉาก การ์ดเรือธง Falcon Shores ถูกยกเลิกไม่ออกขาย Intel หันไปเล่นเกมแคบลงด้วยการ์ด Crescent Island ที่เน้นงาน inference (เริ่มให้ลูกค้าทดสอบครึ่งหลังปี 2026) และวางเดิมพันใหญ่ไว้ที่รุ่น Jaguar Shores ในปี 2027 สะท้อนว่าแม้แต่ยักษ์ชิปเก่าแก่ก็ยังเจ็บตัวเมื่อเข้ามาท้าชน NVIDIA ตรงๆ
อีกสนามที่กำลังเดือดคือ จีน ภายใต้มาตรการควบคุมการส่งออกของสหรัฐฯ ที่ตัดการ์ดระดับสูงของ NVIDIA ออกจากตลาดจีน ส่วนแบ่งของ NVIDIA ในจีนร่วงจากเคย ~95% เหลือราว 55% เปิดช่องให้ผู้เล่นในประเทศโตเร็วมาก — การ์ด AI ที่ผลิตในจีนกินสัดส่วนราว 41% ของการส่งมอบในประเทศปี 2025 (ราว 1.65 ล้านใบจาก 4 ล้านใบ) นำโดย Huawei (สาย Ascend) ตามด้วยผู้เล่นตลาดหุ้นอย่าง Hygon, MetaX และ Biren — โดย MetaX เพิ่งเข้าตลาดหุ้นเซี่ยงไฮ้ปลายปี 2025 ด้วยราคาพุ่งเกือบ 700% ในวันแรก
06อนาคต — Rubin, สงครามราคาและพลังงาน
ทิศทางแรกคือ จังหวะรายปีจะยิ่งกดดันคู่แข่ง ปลายปี 2026 NVIDIA จะเปิดตัวสถาปัตยกรรม Rubin (ใช้หน่วยความจำ HBM4 รุ่นใหม่) ตามด้วย Rubin Ultra ปี 2027 และ Feynman ปี 2028 ทุกรุ่นมาพร้อม CPU, สวิตช์เครือข่าย และระบบครบชุด — กลยุทธ์คือขาย “ทั้งระบบ” ไม่ใช่แค่การ์ด ทำให้ลูกค้ายิ่งถอนตัวยาก และคู่แข่งที่ขายแค่ชิปเปล่าๆ ยิ่งเสียเปรียบ
ทิศทางที่สองคือ สงครามจะย้ายไปที่งาน “รัน” (inference) เมื่อ AI แพร่หลาย น้ำหนักจะเลื่อนจากการ “ฝึก” ครั้งใหญ่ ไปสู่การ “รัน” โมเดลตอบคำถามนับล้านครั้งต่อวัน นี่คือจุดที่คูเมือง CUDA แข็งแรงน้อยลง และเป็นช่องให้การ์ด merchant ของ AMD/Intel รวมถึงชิปสั่งทำ (ASIC) และชิป inference เฉพาะทาง (Inference-Optimized Silicon) แทรกเข้ามาแข่งเรื่องต้นทุน — เพราะงานรันที่ทำซ้ำๆ ไม่ต้องการความยืดหยุ่นเท่างานฝึก
ทิศทางที่สามคือ คอขวดกำลังย้ายที่ วันนี้คอขวดคือ HBM และการแพ็กเกจ (CoWoS) แต่พรุ่งนี้อาจเป็น พลังงานและการระบายความร้อน — การ์ด Blackwell รุ่นใหม่กินไฟเกิน 1,000 วัตต์ต่อใบ และคลัสเตอร์ระดับแสนใบเริ่มชนเพดานโครงข่ายไฟฟ้า ใครแก้คอขวดพลังงานถัดไปได้ก่อน ก็ได้เปรียบ และนี่คือเหตุผลที่ node นี้ผูกกับเทรนด์ พลังงาน แน่นขึ้นทุกที
ทิศทางที่สี่คือ เค้กที่โตเร็วกว่าทำให้ “เสียส่วนแบ่งแต่ยังโต” แม้ส่วนแบ่งของ NVIDIA จะลดลง แต่ตลาดทั้งก้อนโตเร็วมากจนรายได้ทุกเจ้ายังเพิ่มได้พร้อมกัน — ที่น่าจับตาคือชิปสั่งทำ (ASIC) ที่คาดว่าจำนวนการส่งมอบจะโตเร็วกว่าการ์ด merchant ในปี 2026 เป็นปีแรก (โต ~45% เทียบกับ ~16%) สัญญาณว่าการ “หนีค่าต๋ง” ของยักษ์เทคเริ่มเป็นจริง
07ความท้าทายและความเสี่ยง
ความเสี่ยงข้อแรกคือ การกระจุกตัวสุดขั้ว มูลค่ามหาศาลผูกกับ NVIDIA เกือบเจ้าเดียว และเบื้องหลังก็พึ่งซัพพลายเออร์น้อยรายอีกชั้น — TSMC ผลิตการ์ดล้ำสุดเกือบทั้งหมด และ HBM มีผู้ผลิตแค่ 3 ราย ถ้าจุดใดจุดหนึ่งสะดุด (ภัยพิบัติ ภูมิรัฐศาสตร์ หรือเทคนิค) ทั้งห่วงโซ่สะเทือน และเพราะการผลิตล้ำสุดกระจุกที่ไต้หวัน ความเสี่ยงภูมิรัฐศาสตร์จึงไม่ใช่เรื่องไกลตัว
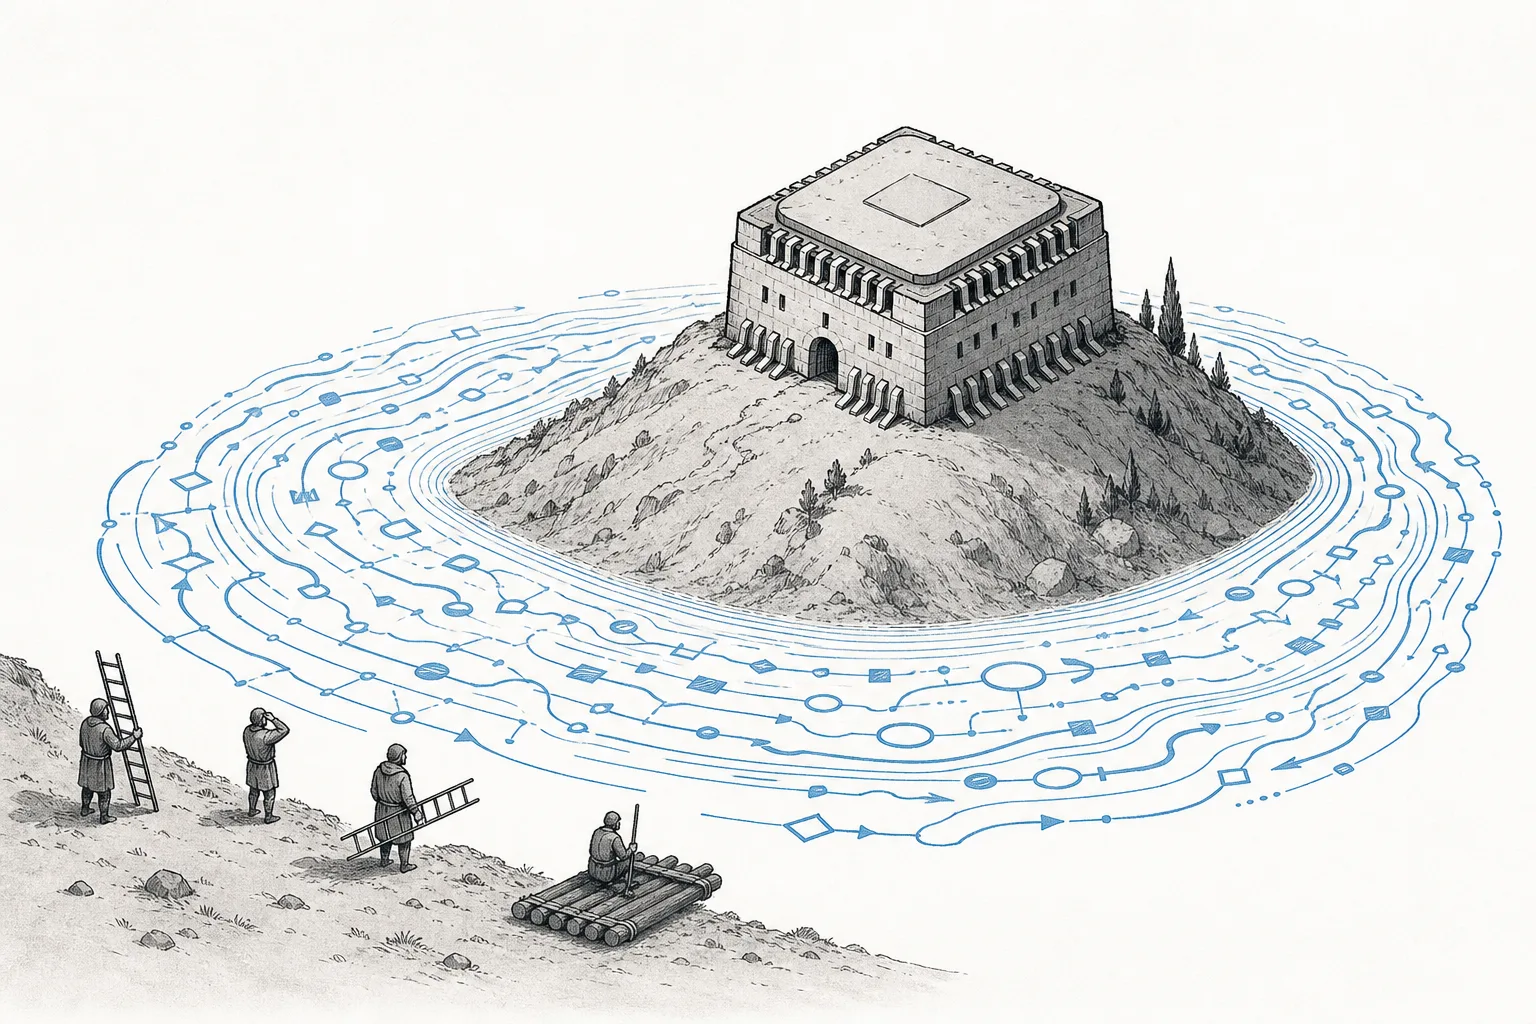
ความเสี่ยงข้อสองคือ ลูกค้ารายใหญ่ที่สุดกำลังกลายเป็นคู่แข่ง Google, Amazon, Microsoft, Meta คือลูกค้าที่ซื้อการ์ดมากที่สุด แต่พวกเขาก็กำลังสร้างชิปสั่งทำของตัวเองเพื่อเลี่ยงค่าต๋ง 73% เหตุผลทางเศรษฐกิจชัดมาก: ถ้าชิปของตัวเองทำงานได้ราว 70% ของการ์ดเรือธง แต่ต้นทุนรวมถูกกว่า 40–65% ในงาน inference ก็คุ้มมหาศาลที่จะย้ายงานภายในออกจากการ์ด merchant — นี่คือแรงกดดันระยะยาวต่อทั้งส่วนแบ่งและมาร์จิ้น
ความเสี่ยงข้อสามคือ คำถามเรื่องวัฏจักรและฟองสบู่ ดีมานด์การ์ดตอนนี้แรงมากเพราะยักษ์เทคทุ่ม capex มหาศาลพร้อมกัน — แต่ตัวเลขชวนกังวล: รายได้จริงจาก AI ยังเล็กเมื่อเทียบกับเงินที่ทุ่มลงไป (เช่น ARR ของ OpenAI ราว $20,000 ล้าน เทียบกับ capex ยักษ์เทคหลายแสนล้าน) ถ้าผลตอบแทนมาช้ากว่าที่คาด หรือการลงทุนชะลอลงพร้อมกัน ดีมานด์ที่ดูไม่มีวันเต็มอาจหดตัวเร็ว — เพราะส่วนใหญ่มาจากลูกค้ากระเป๋าหนักกลุ่มเดียวกันไม่กี่ราย
ความเสี่ยงข้อสี่คือ กำแพงภูมิรัฐศาสตร์เป็นดาบสองคม มาตรการควบคุมการส่งออกตัดตลาดจีนซึ่งเคยใหญ่มากออกจากผู้ผลิตอเมริกัน — พอขายไม่ได้ ก็เท่ากับเร่งให้ผู้เล่นจีน (Huawei, Hygon, MetaX, Biren) สร้างการ์ดเองเร็วขึ้น สุดท้ายผู้นำตลาดเสี่ยงทั้งเสียยอดขายวันนี้และเสียส่วนแบ่งระยะยาวในจีนไปด้วย
สรุปสั้นๆ: node นี้คือร้านขายพลั่วที่ทุกคนต้องแวะก่อนเข้าสนาม AI วันนี้บริษัทเดียวคุมร้านไว้ด้วยซอฟต์แวร์มากกว่าตัวการ์ด แต่สนามกำลังเปลี่ยน — เมื่อโลกเลื่อนจาก “การฝึก” ไปสู่ “การใช้งาน” ลูกค้ารายใหญ่เริ่มหลอมพลั่วเอง และจีนสร้างร้านของตัวเองคู่ขนาน เข้าใจชั้นนี้ ก็เข้าใจว่าทำไมการ์ดเล็กๆ ไม่กี่ชนิดถึงกลายเป็นทั้งหัวใจและคอขวดของเศรษฐกิจ AI ทั้งใบ