Megatrend · Artificial Intelligence
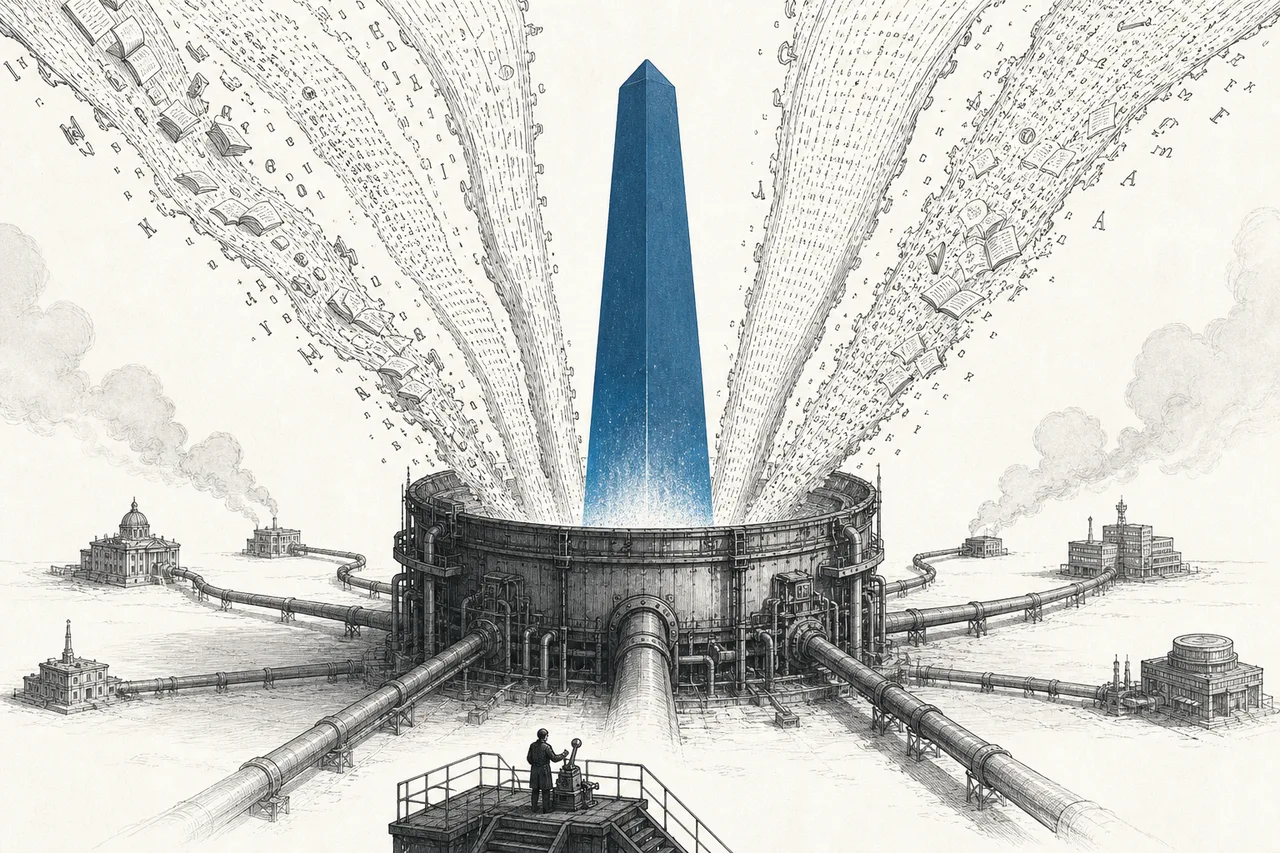
โรงหลอมที่หลอมข้อมูลทั้งโลกให้เป็น “สมอง” เดียว
เบื้องหลัง ChatGPT, Claude และ Gemini มีแล็บไม่กี่แห่งที่เผาเงินระดับหลายร้อยล้านดอลลาร์ต่อโมเดลหนึ่งตัว เพื่อ “เทรน” ปัญญาประดิษฐ์รุ่นแนวหน้า (frontier model) ขึ้นมา นี่คือชั้นที่อยู่ใจกลางสุดของเมกะเทรนด์ AI — และเรื่องที่แปลกที่สุดคือ ผู้เล่นตัวจริงเกือบทั้งหมดยังเป็นบริษัทเอกชนที่ซื้อหุ้นตรงๆ ไม่ได้
01มันคืออะไร
ทุกครั้งที่คุณพิมพ์คุยกับ ChatGPT, Claude หรือ Gemini คุณกำลังคุยกับ “ผลผลิต” ของกระบวนการที่แพงและซับซ้อนที่สุดอย่างหนึ่งในประวัติศาสตร์เทคโนโลยี node นี้คือเรื่องของ บริษัทที่ “เทรน” โมเดลพวกนั้นขึ้นมา — ไม่ใช่คนที่เอาโมเดลไปทำแอป แต่คือคนที่สร้างตัวโมเดลเอง
คำว่า foundation model (โมเดลพื้นฐาน) หมายถึงโมเดล AI ขนาดยักษ์ที่ถูกฝึกบนข้อมูลมหาศาลแบบทั่วๆ ไป จนทำงานได้สารพัด — เขียนโค้ด แปลภาษา สรุปเอกสาร ตอบคำถาม — โดยไม่ต้องสร้างใหม่ทุกงาน เปรียบง่ายๆ คือมันเป็น “เครื่องยนต์อเนกประสงค์” ที่คนอื่นเอาไปประกอบเป็นรถได้หลายรุ่น ส่วน frontier model (โมเดลแนวหน้า) คือรุ่นที่ใหญ่และเก่งที่สุดในแต่ละช่วงเวลา — ของจริงที่กินทรัพยากรมากที่สุด และมีคนทำได้แค่ไม่กี่เจ้าในโลก
Foundation model = โมเดลฐานที่ฝึกแบบกว้างๆ แล้วเอาไปปรับใช้ได้หลายงาน · Frontier model = โมเดลฐานรุ่นที่ล้ำที่สุด ณ ขณะนั้น (เช่น GPT รุ่นล่าสุด, Claude, Gemini) — “แนวหน้า” เพราะมันดันขีดจำกัดของสิ่งที่ AI ทำได้ และต้องใช้ compute มากที่สุด ทุก frontier model เป็น foundation model แต่ไม่ใช่ทุก foundation model จะอยู่แนวหน้า
ในแผนผังเมกะเทรนด์ node นี้เป็นสาขาย่อยภายใต้ Artificial Intelligence และมันคือ “ชั้นแพลตฟอร์ม (platform layer)” — หัวใจที่ชั้นอื่นๆ ของ AI ทั้งหมดต้องพึ่งพา แอปแชต ผู้ช่วยอัจฉริยะ ระบบ agent ที่ทำงานเองได้ ทั้งหมดนี้ไม่มีทางเกิดขึ้นได้เลยถ้าไม่มีโมเดลฐานให้ยืนอยู่ข้างบน
02ทำไมมันถึงเป็นใจกลางของทุกอย่าง
เหตุผลแรกคือ เงิน — มันใหญ่และโตเร็วอย่างไม่เคยมีมาก่อน ลองดูแค่ตัวเลขรายได้: OpenAI ทำรายได้ต่อปี (run-rate) จากราว $13,000 ล้านต้นปี 2025 ขึ้นไปแตะระดับ ~$25,000 ล้าน (ต้นปี 2026) ส่วน Anthropic วิ่งจาก ~$1,000 ล้านปลายปี 2024 ขึ้นไปทะลุ $47,000 ล้าน ในเดือนพฤษภาคม 2026 — โตเร็วกว่า 80 เท่าในเวลาปีกว่าๆ นี่คือการสร้างธุรกิจระดับหลายหมื่นล้านดอลลาร์ในเวลาที่แทบไม่เคยเห็นในโลกซอฟต์แวร์
เหตุผลที่สองคือ การลงทุน มูลค่าบริษัทพุ่งจนเป็นประวัติศาสตร์ — OpenAI ระดมทุนรอบใหญ่ที่ valuation ราว $850,000 ล้าน ส่วน Anthropic แซงขึ้นเป็นสตาร์ทอัพ AI ที่มีมูลค่าสูงสุดที่ราว $965,000 ล้าน ในกลางปี 2026 และในไตรมาสแรกของปี 2026 เพียงไตรมาสเดียว เงินที่ไหลเข้า AI ทั่วโลกเกิน $180,000 ล้าน — มากกว่าทั้งปี 2024 รวมกัน
แต่เหตุผลที่ลึกที่สุดไม่ใช่ตัวเลข มันคือ ตำแหน่งทางยุทธศาสตร์ โมเดลฐานคือ “ก๊อกน้ำ” ที่ทุกแอป AI ต้องต่อท่อมาดื่ม ใครคุมโมเดลที่เก่งที่สุดและถูกที่สุด ก็คุมต้นทุนและความสามารถของซอฟต์แวร์รุ่นใหม่ทั้งระลอก นี่คือเหตุผลที่ยักษ์เทคทุกตัว — Microsoft, Amazon, Google, Meta, Nvidia — ยอมทุ่มเงินมหาศาลเข้ามาในชั้นนี้ ทั้งสร้างเองและลงทุนในแล็บอื่น
03มันทำงานยังไง
การสร้างโมเดลแนวหน้าหนึ่งตัวแบ่งเป็นสามด่านใหญ่ และเข้าใจสามด่านนี้ คือเข้าใจว่าทำไมมันถึงแพงระดับนี้ และทำไมไม่กี่เจ้าเท่านั้นที่ทำได้
ด่านแรกคือ pretraining (การฝึกฐาน) — เอาข้อความเกือบทั้งอินเทอร์เน็ต (เป็นล้านล้านคำ) มาให้โมเดล “อ่าน” โดยฝึกให้มันทายคำถัดไปซ้ำๆ นับล้านล้านครั้ง จนมันซึมซับโครงสร้างของภาษา ความรู้ และเหตุผลเข้าไปในตัวเลขนับพันล้านค่า (parameters) ด่านนี้แหละที่กิน compute และเงินมากที่สุด — ต้องใช้ชิป GPU หลายหมื่นตัวรันต่อเนื่องเป็นเดือนๆ
ด่านสองคือ post-training (การฝึกหลัง) โมเดลที่เพิ่ง pretrain เสร็จเก่งแต่ “ดิบ” — มันรู้เยอะแต่ไม่รู้จะคุยกับคนยังไง ด่านนี้จึงสอนมารยาทและความปลอดภัย เทคนิคหลักชื่อ RLHF (Reinforcement Learning from Human Feedback) — ให้คนจริงให้คะแนนคำตอบ แล้วใช้คะแนนนั้นปรับโมเดลให้ตอบแบบที่มีประโยชน์และไม่เป็นพิษ ช่วงหลังด่านนี้ยังเพิ่ม “การฝึกให้คิดเป็นขั้นตอน” (reasoning) ซึ่งกลายเป็นจุดที่โมเดลรุ่นใหม่เก่งขึ้นแบบก้าวกระโดด
ด่านสามคือ inference (การใช้งานจริง) — ตอนที่คุณพิมพ์คำถามแล้วโมเดลตอบ นี่คือด่านที่ “เผาเงิน” ทุกวันตลอดเวลา เพราะทุกคำตอบต้องใช้ชิปคำนวณจริง ยิ่งมีคนใช้มาก ต้นทุน inference ยิ่งบาน — และนี่คือเหตุผลที่ค่าใช้จ่ายด้าน compute ของแล็บไม่เคยจบแค่ตอนเทรนเสร็จ
แล้วทำไมต้นทุนถึงพุ่งทุกปี? คำตอบอยู่ที่กฎที่ชื่อ scaling laws (กฎการขยายมาตราส่วน) งานวิจัยพบว่า ยิ่งโมเดลใหญ่ขึ้น + ป้อนข้อมูลมากขึ้น + ใช้ compute มากขึ้น ความเก่งก็เพิ่มขึ้นอย่างคาดเดาได้ — แต่ในอัตราที่ต้องเพิ่มทรัพยากร “เป็นทวีคูณ” เพื่อเก่งขึ้นอีกขั้น นั่นแปลว่าค่าฝึกของโมเดลแนวหน้าวิ่งจากหลักสิบล้านในยุค GPT-4 (~$78–100M) ขึ้นไปสู่ระดับ $200–500 ล้านต่อโมเดลในปี 2025–2026 และนักวิเคราะห์คาดว่าจะแตะ $1,000–3,000 ล้านต่อโมเดลภายในปี 2027
04สองสายพันธุ์: ปิด vs เปิด
โลกของแล็บโมเดลแบ่งเป็นสองปรัชญาที่ขัดกันชัดเจน และนี่คือสองหมวดย่อยของ node นี้
ฝั่งแรกคือ Closed / Frontier Labs (แล็บปิด) — เทรนโมเดลที่ดีที่สุดเท่าที่ทำได้ แล้ว “ขังมันไว้” ให้เข้าถึงผ่าน API หรือแอปเท่านั้น คุณเช่าใช้ความฉลาดได้ แต่ไม่ได้ตัวโมเดล นี่คือทาง OpenAI, Anthropic, Google DeepMind และ xAI โมเดลที่เก่งที่สุดในโลกแทบทั้งหมดอยู่ฝั่งนี้ และรายได้พรีเมียมก็มาจากฝั่งนี้ — Anthropic แม้กินสัดส่วนปริมาณการใช้งานราว 12% แต่เก็บเป็นเม็ดเงินได้มากกว่านั้นมาก เพราะตั้งราคาสูงในงานระดับองค์กร
ฝั่งที่สองคือ Open-Weight Model Developers (แล็บเปิดน้ำหนัก) — เทรนโมเดลแล้ว “แจกพิมพ์เขียว” ออกมา (ปล่อย weights ให้ดาวน์โหลด) ใครก็เอาไปรันเอง ปรับแต่งเอง บนเครื่องตัวเองได้ ผู้นำฝั่งนี้คือ Meta (ตระกูล Llama), Mistral ของฝรั่งเศส และ DeepSeek/Qwen ของจีน จุดขายคือ อธิปไตยและการควบคุม — องค์กรหรือประเทศที่ไม่อยากฝากข้อมูลไว้กับ API อเมริกา เลือกรันโมเดลเปิดในบ้านตัวเองได้
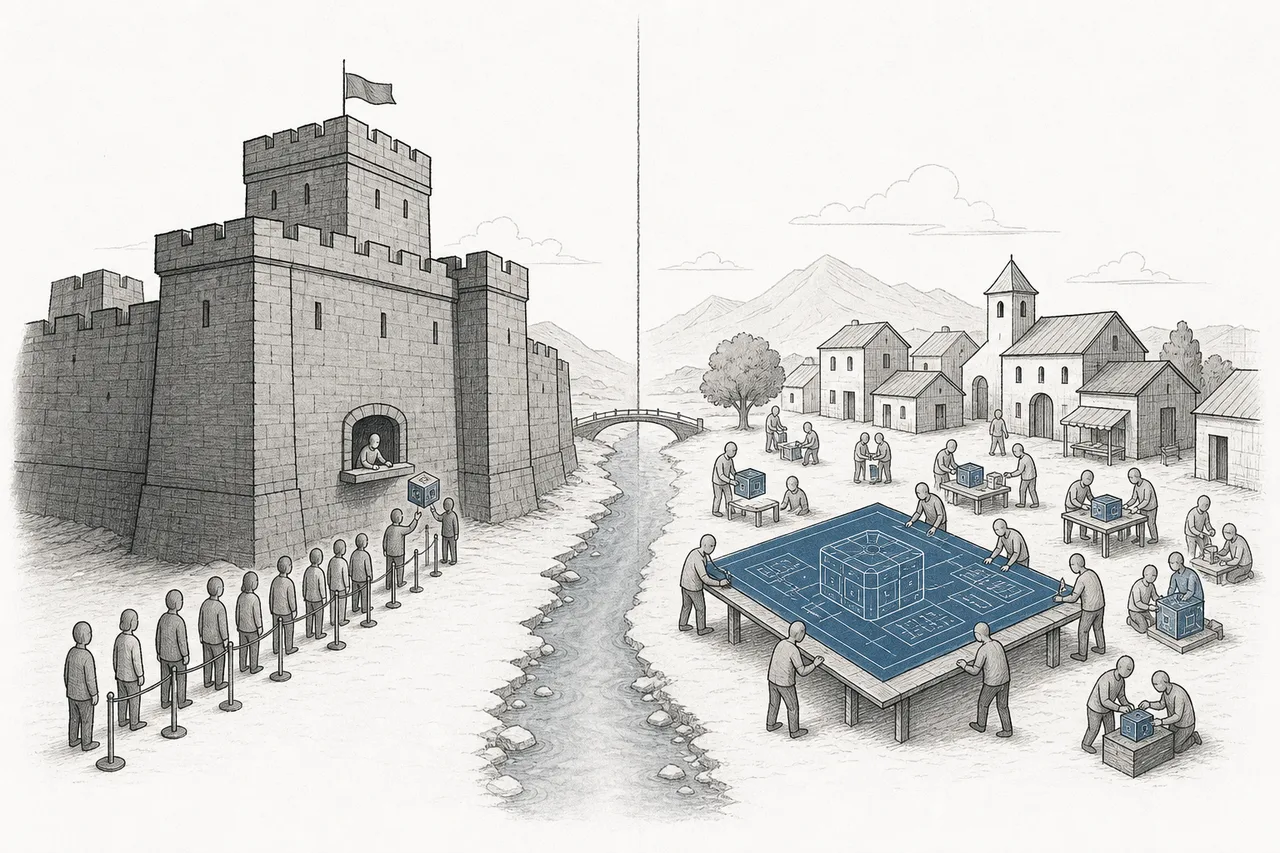
เส้นแบ่งนี้กำลังขยับอย่างน่าสนใจ ในปี 2024 โมเดลเปิดตามหลังโมเดลปิดด้านคุณภาพอยู่เกือบหนึ่งปี แต่พอถึงปี 2025–2026 ช่องว่างหดเหลือราว 6 เดือน และที่น่าตกใจคือโมเดลจากจีน (DeepSeek, Qwen, MiniMax, Moonshot) พุ่งจากต่ำกว่า 2% ของปริมาณการใช้งานบนแพลตฟอร์มรวมโมเดล ขึ้นมาเกิน 45% ของปริมาณ token ภายในเวลาปีเดียว
Open-weight = ปล่อย “ตัวเลขที่ฝึกมาแล้ว” (weights) ให้ดาวน์โหลดไปรันและปรับแต่งได้ แต่มักไม่เปิดเผยข้อมูลที่ใช้ฝึกหรือสูตรเทรนทั้งหมด จึงต่างจาก open-source ซอฟต์แวร์ทั่วไปที่เปิดทุกอย่าง · ที่สำคัญ open-weight ฟรีให้รัน แต่ไม่ฟรีให้ “สร้าง” — ค่าเทรนยังหลักร้อยล้านเหมือนเดิม คนได้ประโยชน์คือคนเอาไปใช้ ไม่ใช่คนทำ
05มันเชื่อมกับอะไรในระบบนิเวศ
node นี้นั่งอยู่ใจกลางของเมกะเทรนด์ AI ทั้งหมด มันเป็น “ชั้นแพลตฟอร์ม” ที่ชั้นอื่นทั้งพึ่งพาและป้อนกลับ:
- กินไฟจาก AI Compute & Accelerator Silicon มหาศาล: ทุกด่าน — pretrain, post-train, inference — รันบนชิป GPU/accelerator ราคาแพง ดีมานด์ของแล็บคือสิ่งที่ดันยอดขาย Nvidia และทำให้ compute กลายเป็นคอขวด ความสัมพันธ์นี้ตรงและลึกที่สุด
- ป้อนวัตถุดิบให้ AI Applications & Copilots: แอปแชต ผู้ช่วยเขียนโค้ด เครื่องมือสรุปเอกสาร — ทั้งหมดต่อท่อมาจากโมเดลฐาน ถ้าโมเดลถูกลงหรือเก่งขึ้น แอปทั้งระลอกก็ได้อานิสงส์ทันที
- เป็นเครื่องยนต์ของ Agentic AI & Autonomous Workflows: ระบบ AI ที่ทำงานเองหลายขั้นตอนต้องอาศัยโมเดลที่ “คิดเป็นขั้นตอน” ได้ ซึ่งมาจาก post-training รุ่นใหม่โดยตรง
- ดูดพลังงานจาก Energy Transition & Power Demand: ศูนย์ข้อมูลที่รันโมเดลกินไฟระดับเมือง จนกำลังไฟฟ้ากลายเป็นข้อจำกัดที่แท้จริงของการขยายโมเดลรุ่นถัดไป
และมันยัง “จุดไฟ” ให้เทรนด์อื่นนอกวง AI ด้วย — ตั้งแต่ Biotech (ออกแบบยาด้วย AI) ไปจนถึง Cybersecurity นี่คือเหตุผลที่หลายคนเรียกโมเดลฐานว่า “เทคโนโลยีอเนกประสงค์” แบบเดียวกับไฟฟ้าหรืออินเทอร์เน็ต — มันไม่ใช่สินค้าชิ้นเดียว แต่เป็นชั้นพื้นฐานที่อย่างอื่นมาต่อยอด
06ตอนนี้ไปถึงไหนแล้ว (และใครคือผู้เล่น)
ก่อนจะพูดถึงผู้เล่น ต้องเข้าใจความจริงข้อหนึ่งที่กำหนดวิธีลงทุนในชั้นนี้ทั้งหมด: ผู้เล่นตัวจริงที่เทรนโมเดลแนวหน้าเกือบทั้งหมดยังเป็นบริษัทเอกชน — OpenAI, Anthropic, xAI และ Mistral ล้วนยังไม่เข้าตลาดหุ้น (OpenAI เพิ่งเริ่มเตรียมยื่น IPO) นี่ไม่ใช่เรื่องน่าผิดหวัง แต่เป็น “ข้อเท็จจริงของตลาด” ที่สำคัญ: ทางที่นักลงทุนทั่วไปจะมีส่วนร่วมในชั้นนี้ คือผ่าน ยักษ์จดทะเบียนที่เป็นทั้งผู้สนับสนุนเงินทุนและเจ้าของ compute ของแล็บเหล่านั้น
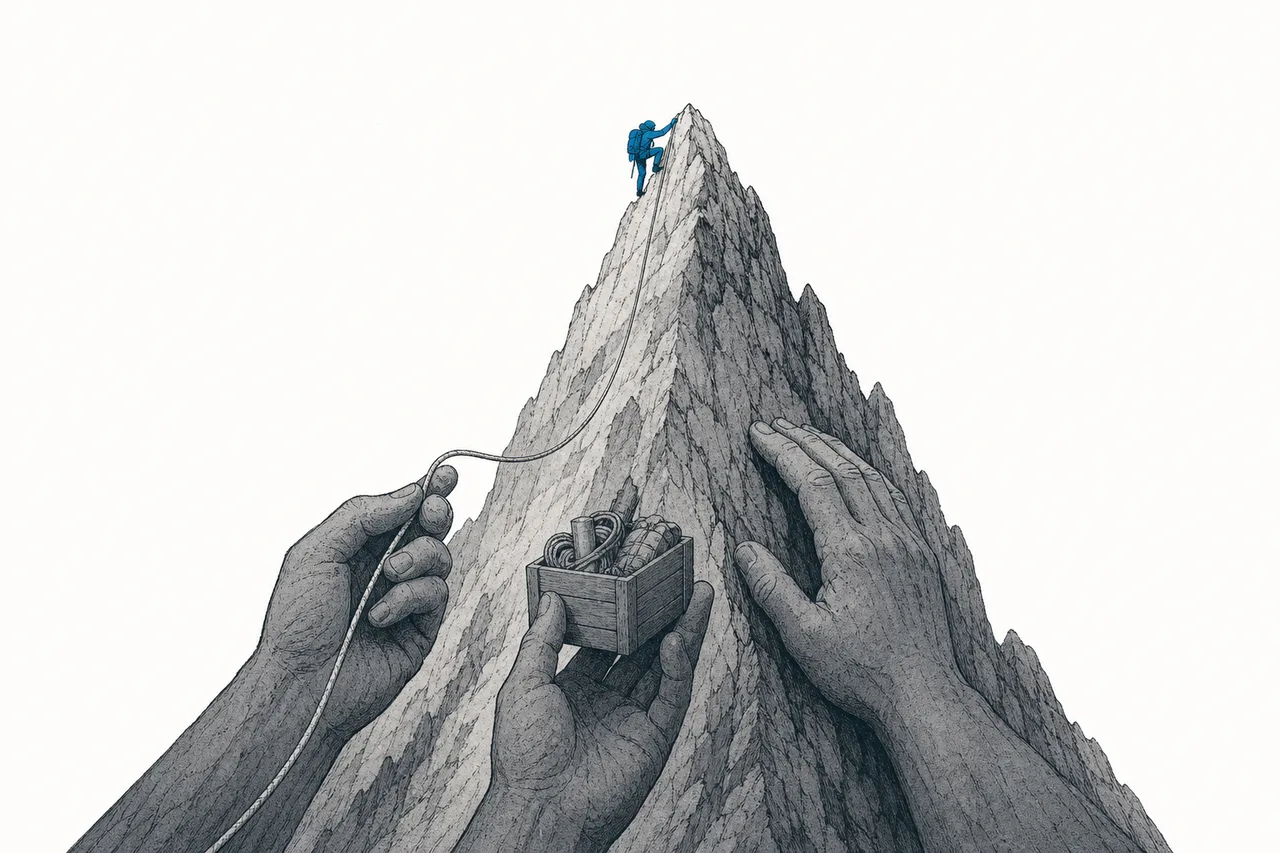
เส้นเงินมันวิ่งเป็น “วงล้อทุน” ที่ชัดเจน: ยักษ์จดทะเบียนอย่าง Microsoft, Amazon และ Alphabet อัดเงินและ compute เข้าแล็บปิด แล้วแล็บก็เอาเงินนั้นไปซื้อชิปและเช่าศูนย์ข้อมูลคืนจากยักษ์เหล่านั้นอีกที — เงินหมุนกลับมาเป็นทั้งรายได้และ stake ในงบของผู้หนุน นี่แหละคือกลไกที่ทำให้นักลงทุนทั่วไป มี exposure ต่อแล็บเอกชนผ่านหุ้นของผู้สนับสนุน ได้ (รายละเอียดดีลรายเจ้า — Amazon/Trainium, xAI/SpaceX, capex รวมหลายแสนล้าน — ดูแบบเจาะลึกใน Closed / Frontier Labs)
ฝั่งเอเชียก็มีผู้เล่นจดทะเบียนที่เกาะเทรนด์นี้ — Baidu (โมเดล Ernie), Alibaba และ Tencent ต่างทุ่มสร้างโมเดลฐานของตัวเอง ขณะที่รายเล็กลงมาอย่าง SenseTime และ MiniMax เน้นโมเดลเฉพาะทาง ทำให้แม้แล็บนำของโลกจะเป็นเอกชน แต่ยังมี “ตัวแทนจดทะเบียน” ให้จับต้องได้พอสมควรในตลาดเอเชีย
ฝั่งเปิดก็มีเสาหลักของตัวเอง — Meta (ตระกูล Llama) เป็นเสาหลักอเมริกา, Mistral ถือธงยุโรป และ Qwen/DeepSeek ของจีนที่พุ่งนำด้านปริมาณการใช้งาน ในแง่หุ้นที่ซื้อได้ ผู้เล่นเปิดที่จับต้องได้คือ Meta และ Alibaba (เจ้าของ Qwen) — ดูแบบเจาะลึกใน Open-Weight Model Developers
07อนาคตข้างหน้า
ทิศทางแรกคือ การฝึกให้ “คิด” แทนการฝึกให้ “ใหญ่” เป็นเวลาหลายปีที่ความเก่งมาจากการเพิ่มขนาดโมเดลและข้อมูล (pretraining scaling) แต่ตอนนี้คลื่นใหม่มาจากการทุ่ม compute ไปที่ขั้น “คิดเป็นขั้นตอน” ตอนตอบ (test-time / reasoning) — โมเดลใช้เวลาคิดนานขึ้นเพื่อตอบยากๆ ได้ดีขึ้น นี่เปลี่ยนสมการต้นทุน: ของเดิมเผาเงินตอนเทรน ของใหม่เผาเงินตอน inference มากขึ้นเรื่อยๆ
ทิศทางที่สองคือ ข้อจำกัดย้ายจากชิปไปสู่ไฟฟ้า ปีก่อนคอขวดคือหา GPU ให้พอ ปีนี้คอขวดเริ่มเป็น “หากำลังไฟฟ้าและที่ตั้งศูนย์ข้อมูลให้พอ” การฝึกโมเดลรุ่นถัดไป (ที่อาจแตะ $1–3 พันล้านต่อตัวภายในปี 2027) จะถูกจำกัดด้วยพลังงานมากกว่าด้วยเงินหรือชิป — นี่คือจุดที่ AI ไปผูกกับเทรนด์พลังงานอย่างแยกไม่ออก
ทิศทางที่สามคือ เปิดไล่ปิด ถ้าช่องว่างคุณภาพระหว่างโมเดลเปิดกับปิดหดต่อไปจนเกือบเป็นศูนย์ คำถามใหญ่คือ แล็บปิดจะรักษาอำนาจตั้งราคาไว้ได้ไหม เมื่อ “ของเกือบดีพอ” แจกฟรีให้รันเอง คำตอบจะกำหนดว่ามูลค่ามหาศาลที่ไหลเข้าชั้นนี้จะอยู่ที่ใครในระยะยาว
08ความท้าทายและความเสี่ยง
ชั้นที่อยู่ใจกลางที่สุดของ AI ก็เป็นชั้นที่มีความเสี่ยงเฉพาะตัวที่สุดเช่นกัน
ความเสี่ยงข้อแรกคือ commoditization (กลายเป็นของโหล) เมื่อโมเดลเปิดไล่ทันและโมเดลจีนตั้งราคาถูกลงเรื่อยๆ “ความฉลาดต่อหนึ่งโทเค็น” อาจกลายเป็นสินค้าโภคภัณฑ์ที่แข่งกันที่ราคาล้วนๆ — ดังที่ DeepSeek จุดชนวนให้ตลาดตื่นตระหนกในต้นปี 2025 ว่าของระดับใกล้เคียงอาจไม่ต้องใช้เงินหลายพันล้าน (เหตุการณ์ “DeepSeek Monday” เต็มรูปแบบ ดูใน Open-Weight Model Developers)
ความเสี่ยงข้อสองคือ ต้นทุนที่ไม่เคยจบ ค่าฝึกที่พุ่งทุกรุ่น (สู่ $1–3 พันล้านต่อโมเดล) บวกกับค่า inference ที่บานตามจำนวนผู้ใช้ แปลว่าแล็บต้องระดมทุนต่อเนื่องมหาศาล ถ้าวันหนึ่งนักลงทุนเริ่มตั้งคำถามว่ารายได้จะตามทันต้นทุนเมื่อไหร่ การระดมทุนอาจสะดุด — และในธุรกิจที่ “หยุดเทรนคือถูกแซง” การสะดุดเรื่องเงินคือความเสี่ยงที่ใหญ่มาก
ความเสี่ยงข้อสามคือ การกระจุกตัวและภูมิรัฐศาสตร์ โมเดลที่ทรงพลังที่สุดในโลกอยู่ในมือบริษัทไม่กี่แห่ง และต้องพึ่งชิปขั้นสูงที่ผลิตได้แค่ไม่กี่ที่ การกีดกันการส่งออกชิป การแข่งขันสหรัฐฯ-จีน และคำถามด้านความปลอดภัยของ AI ที่เก่งขึ้นเรื่อยๆ ล้วนเป็นตัวแปรที่อาจเปลี่ยนภูมิทัศน์ทั้งหมดได้เร็วกว่าที่คิด
สรุปสั้นๆ: ถ้า AI Compute คือ “เครื่องจักร” ของยุค AI โมเดลฐานก็คือ “โรงงาน” ที่หลอมข้อมูลทั้งโลกให้กลายเป็นความฉลาดที่ขายได้ การเข้าใจว่าผู้เล่นตัวจริงส่วนใหญ่ยังอยู่นอกตลาดหุ้น และหุ้นที่จับต้องได้คือ “คนที่ถือเชือกและจ่ายค่าไฟ” ให้พวกเขา — คือเข้าใจว่าทำไม node ที่ดูเข้าถึงยากที่สุดนี้ ถึงเป็น node ที่กำหนดทิศทางของทั้งเมกะเทรนด์