メガトレンド · サイバーセキュリティ&デジタルトラスト
AIが本当に「代わりに働ける」ようになると、たった一通のメールで裏切らせることもできる
これまでは「AIが答えを間違えたら」と心配していました。でも今のAIは、私たちの代わりに“手を動かす”ようになってきています——メールを読み、お金を払い、ファイルを開き、データを送る。そして手を動かせるようになると、その手を「だまして」やってはいけないことをさせる、というのがAIそのものと一緒に生まれた新しい攻撃口になります。これは二つの戦場の話です:AIがだまされないように守ること、そしてAIを使う悪意ある側にAIで対抗すること。
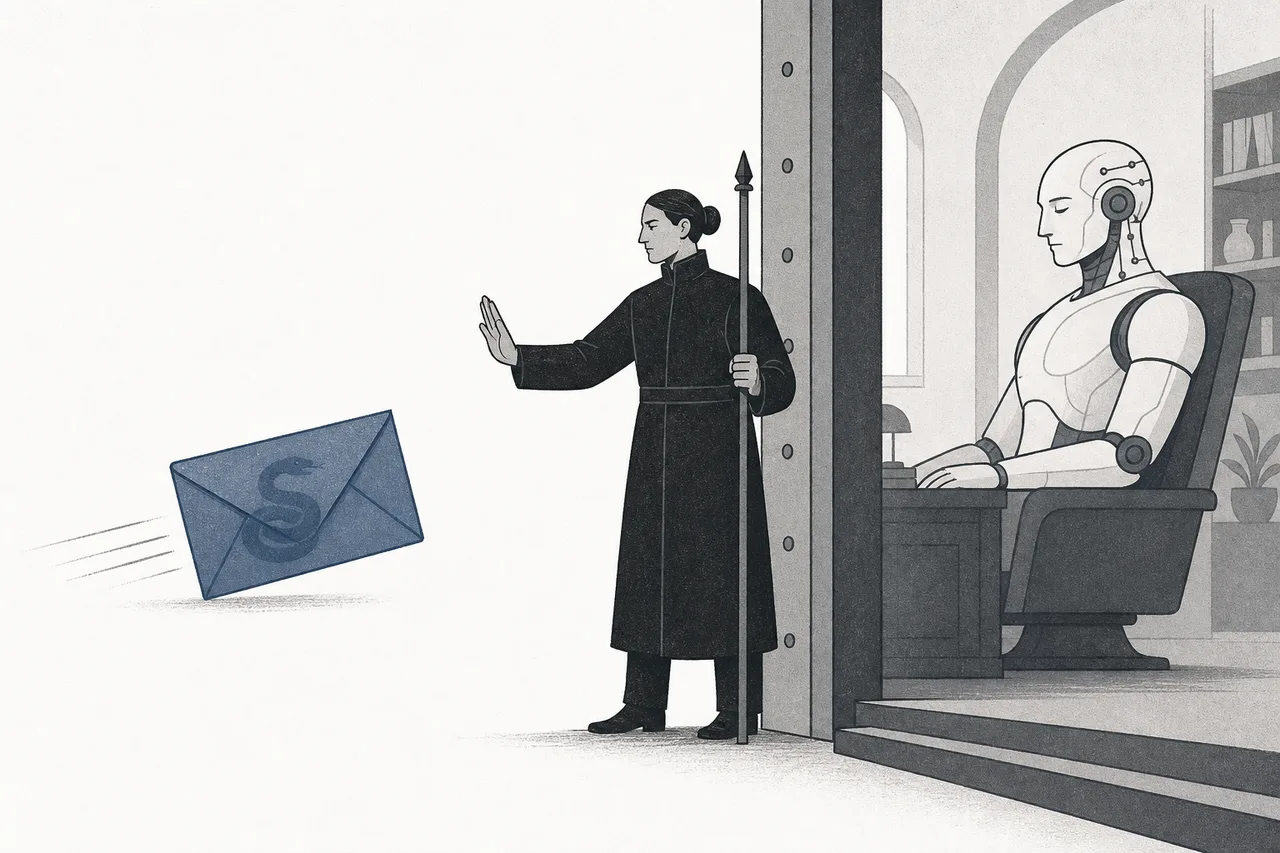
01これは何?(コインの裏表)
とても優秀な個人アシスタントを雇ったと想像してみてください。メールを読んでくれ、チケットを予約してくれ、請求書を払い、あなたの代わりに社内システムにログインできる。この能力は計り知れないほど便利です——でも裏を返せば、誰かが「偽のメモ」を送ってこのアシスタントに『ご主人がこの口座に送金しろと言っている』と信じ込ませ、それを真に受けたら、被害はその瞬間に起きてしまう。これがこのnodeの核心です。
AI Security & Agent Guardrails は、大規模言語モデル(LLM)とAI agentの時代と一緒に“生まれたばかり”のセキュリティ分野です。理解すべき二つの側面に分かれます。
- 側面1 — AI自体を守る(securing AI): AIそのものが、従来のシステムにはなかった弱点を持つ新しい標的になります。たとえば「文章でだます」攻撃(prompt injection)、ルールの解除(jailbreak)、学習データへの毒入れ(data poisoning)。そしていちばん危ないのは、AIが本当に手を動かせるagentになったとき——乗っ取られたagentは、答えを間違えるだけでなく、間違ったことを実行してしまえるのです
- 側面2 — AI対AI(attack vs defense): 悪意ある側はAIを使って、より巧妙な詐欺メールを書き、声や映像を偽造し(deepfake)、弱点をより速く見つけ出す。いっぽう守る側もAIを使って、監視センター(SOC)の作業を加速させ、ゲームに食らいついていく
LLM(Large Language Model)= 言語を理解し生成できるAIモデル。ChatGPTの裏側にあるようなもの · Agent = LLMに“手を動かす”力をつなげたもの——ツールを呼び、ウェブを検索し、コードを実行し、データベースにアクセスし、お金を払う · Prompt = モデルに入力する指示文。問題は、AIが「どれがご主人からの指示で」「どれが部外者からの文章か」をうまく見分けられないこと——そこが弱点の根っこなんです。
メガトレンドの地図では、このnodeはCybersecurity & Digital Trustの下にあり、定義はそのものずばり「AI自体のセキュリティを守ること——prompt injectionを防ぎ、モデルへの攻撃テスト(red-teaming)を行い、agentの権限を絞り垣根を張る」と言い切っています。サイバーセキュリティ一族のなかでいちばん若い分野で、いまも巨大企業よりスタートアップのほうが多い世界です。
02なぜ大事? — AIと同時に生まれた攻撃口
ふつうのサイバーセキュリティは「コード」を守ることでした——書いたとおりに正確に動くコードです。でもAIはコードではありません。「言語を解釈して」自分で判断する仕組みです。そこに、従来のファイアウォールが一度も出会ったことのない新種の弱点が口を開けます。そしてOWASPのような業界標準も、こうした弱点をすでに正式にランク付けしました。
LLMアプリ向けOWASP Top 10の2025年版では、2年連続で第一位の脅威がprompt injection——AIが読みにいくメール・文書・ウェブのなかに「秘密の指示」をこっそり仕込み、持ち主ではなく部外者の言うことを聞かせる手口です。さらに2025年末、OWASPはわざわざagentic AI専用のTop 10を出すまでになりました。モデルが自分で仕事をこなせるようになると、たった一つの弱点が及ぼす「被害の半径」が一気に広がるからです。
これは机上の話ではありません。2025年6月、研究者がMicrosoft 365 CopilotにEchoLeak(CVE-2025-32711)という弱点を公表しました——実運用中のAIシステムで初めてのzero-click型prompt injectionで、深刻度スコアCVSSは9.3に達しました。よく作り込まれたメールを一通送り込むだけで(被害者は何もクリックしなくていい)、Copilotがだまされて社内ファイルを引っ張り出し、攻撃者のサーバーへデータを送ってしまった。Microsoftはすでに穴をふさぎましたが、この種の脅威が本当に「手で触れる」現実だと証明したのです。
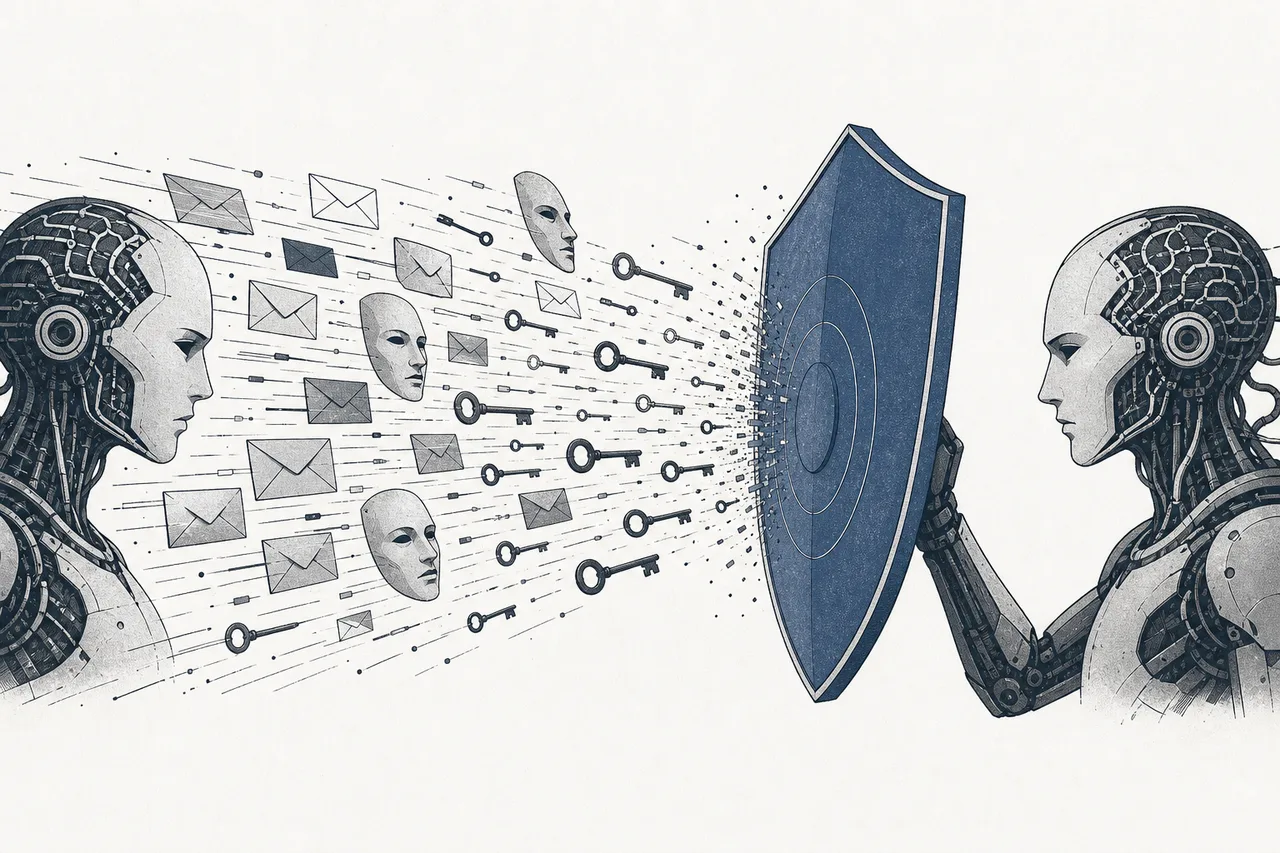
コインのもう一方の面も同じくらい速く育っています——悪意ある側がAIを武器にしているのです。2025年には、AIを使ったサイバー攻撃が2,800万件を突破し、前年比でおよそ72%増えたと見られています。AIが作ったフィッシングメールは約54%もの人がうっかりクリックしてしまい、従来型フィッシングの約12%と比べると段違い。deepfake被害も前年比で跳ね上がっています。
ざっくり言えば:私たちは、世界じゅうの組織でAIが人の代わりに働く扉を開いたばかりで、いっぽう悪意ある側も、攻撃を加速させるAIという道具を手にしたばかりです。このnodeは、AIの波全体を「安心して実際に使える」ものにするために生まれるべき“鎧の裏地”なんです。
03どう動く? — 制御されたagent
guardrailの核心は、とてもシンプルな発想です:inputを信じるな、そしてactionを勝手に起こさせるな。AI agentに指示を受けてそのまま実行させるのではなく、入口と出口の両方に「検問所」を挟む——優秀なアシスタントほど、大きな案件の前には上司の承認サインが要る、というのと同じです。
第一の検問所(input)は「AI用のファイアウォール」のように働きます——モデルに入力されるあらゆる文章を読み、秘密の指示を埋め込もうとしたり、ルールを解除しようとしたりするパターンを捕まえる。第二の検問所(action)は、agentの時代にいちばん大事です:AIが実際に効果のある「行動」に出る前に——送金、ファイル削除、社外へのメール送信——必ず権限のチェックを通さなければなりません。原則はleast privilege(必要最小限の権限しか与えない)に、human-in-the-loop(高リスクな仕事は人が承認サインをする)を組み合わせることです。
Red-teaming = 「レッドチーム」(人かAI)を雇って、自分のモデルをあらゆる手口で攻撃させ、悪意ある側より先に弱点を見つけること——避難訓練のようなものです · Guardrail = モデルに入るもの(危険な入力)と、出るもの(不適切な答えや行動)の両方を絶えずふるい分ける「垣根」。この二つが、この分野まるごとの主要な道具なんです。
この問題がとりわけ解きにくい理由は、AIモデルがそもそも「言語に従う」ように作られていること。だから「信頼できる指示」と「たまたま指示が埋め込まれた文章」のあいだに、はっきりした境界線がありません。垣根を張るのは一度のパッチで終わる作業ではなく、絶えず更新し続ける多層防御なのです。
04つながり — どこにつながる?
このnodeはCybersecurity & Digital Trust一族の末っ子で、それぞれ別の関所を守る兄弟がいます。ただAI Securityは、すべての関所と交わる分野です——AIがあらゆるシステムに入り込もうとしているからです。
- Identity & Access Managementと直接つながる: agentが人の代わりに手を動かすと、大きな問いが生まれます——「このagentは誰で、何をする権限があるのか」。そこからagent identity(AIの“身元”)という考え方が生まれ、一人の従業員のように管理する必要が出てきます。CrowdStrikeが、人・マシン・そしてAI agentまでカバーする身元管理システムを出したのはこのためです
- Security Operations (SOC)に仕事を送り込む: 「AI対AI」の側面は、AIを監視センターの助っ人にして、何百万もの警告から本物だけを選り分けること
- Artificial Intelligenceから生まれた: とくにAgentic AI(自分で手を動かすAI)とFoundation Models(巨大な基盤モデル)——この二つのAIが広まるほど、垣根への需要も大きくなる。まさに「影が体について回る」関係です
言い換えると:IAMは「誰が入れるのか」を問い · SOCは「何か異常はないか」を問う · そしてAI Securityは、これまでなかった新しい問いを立てます——「このモデルは今だまされていないか、もし実行に移そうとしたら、間に合うように止められるか」。従来の関所に取って代わるのではなく、AIがすべてのシステムの中心に入ってきたときに欠けてしまう関所を、埋めにくるのです。
05いま、どこまで来たか + 主役たち
いまこの分野は「爆発したばかり」の局面にあります——2025年は、AI securityが組織にとって「交渉の余地がない」テーマになった年だと、多くの機関が呼んでいます。お金が本格的に流れ込みはじめ、巨大企業はこの能力を自社プラットフォームに足すために、スタートアップを次々と買い始めました。
市場規模はサイバーセキュリティ全体に比べればまだ小さいものの、伸び方が異常です。agentic AI向けセキュリティ市場は、2026年の約16.5億ドルから2032年には約135億ドルへ——CAGRで約42%と見込まれています。いっぽう、より広いGenAIサイバーセキュリティ市場は、約87億ドル(2025年)から約355億ドル(2031年)へと見積もられています。
ここでの「プレーヤー」の顔ぶれは、ほかの分野とは違います——本当の専門家の多くが、まだ非公開のスタートアップで、株式市場にいません。いっぽう市場にいる巨大企業は、たいていこの能力を自前で作るのではなく「買って」入ってきます:
- Palo Alto Networksは2025年4月、Protect AI(シアトル発のAI securityスタートアップ)を、複数の情報源で約6.5〜7億ドルと見積もられる規模で買収。モデルスキャン・red-team・ランタイム防御の能力をまとめ、新プラットフォームPrisma AIRSに統合しました
- CiscoはRobust Intelligence(2024年8月)を買収し、AIモデルのテストと防御をSecurity Cloudに加えました
- CrowdStrikeはPangea(AI securityスタートアップ)を買収し、AI agentまでカバーする新しい身元管理システムを発表しました
イノベーションを引っ張る純粋なスタートアップ側にも、本物の数字が出はじめました——HiddenLayerは合計で約5,600万ドルを調達(Series Aの5,000万ドルはMicrosoftのファンドM12が主導)し、2025年に売上が約3,500万ドルに届きました。LakeraとProtect AIは、LLM向けのguardrailとred-teamingの先駆者として業界でよく名前が挙がります。
投資家にとって大事な注意点:いま市場に「AI securityの純粋大型株」はまだありません——だからこのテーマへの投資は、たいてい「AI securityを後づけしている」サイバーセキュリティの巨人(PANW, CRWD, CSCO)への投資であって、これ一本でやっている会社への投資ではないのです。
06これからの展開
第一の方向はagentが広まりすぎて、guardrailが“必須”になること。組織がAI agentを実務に放ちはじめると(請求書を払い、顧客に答え、自分でコードを書いてデプロイする)、どの会社も「自分のagentをどう制御するのか」という問いに答えなければなりません——AI firewallとagent identityは、今日のファイアウォールがどの組織にもあるのと同じように、標準の一層になっていくはずです。
第二の方向は大きなプラットフォームへの統合。2024〜2025年の一連の買収(Cisco→Robust Intelligence、Palo Alto→Protect AI、CrowdStrike→Pangea)は、サイバーセキュリティの巨人たちがこの層を「所有」しにいく、という明確な合図です。専門特化のスタートアップの多くは、独立して大企業に育つより、プラットフォームに買い込まれていくでしょう。
第三の方向は両陣営のAIの競争が加速すること。悪意ある側がAIで、速く・安く攻めてくるなら、守る側もSOCでAIを使ってゲームに食らいつくしかありません——AIが脅威の選別と対処を半自動でこなす「autonomous SOC」へと向かいます。2025年のデータでは、AI防御システムを使う組織は、脅威の検知が速くなり、漏えいの発覚も数か月早まっています。これこそ、業界全体に両側で「AIで武装」させる経済的な理由なんです。
07課題&リスク
はっきり言っておきます:これはまだ生まれたばかりで、固まっておらず、ブーム(hype)の匂いも混じる分野です。多くのベンダーが既存の製品に「AI security」というラベルを貼ったばかりで、本当の実力はこれから証明されるところ——投資家もユーザーも、本物と売り文句を見分けなければなりません。
技術的なリスクの一つめは、prompt injectionが「完全には解けない」問題かもしれないこと。それは、言語に従うよう設計されたモデルの本質に埋め込まれているからです。OWASP自身も、100%防ぐ唯一の方法はなく、多層防御でリスクを下げられるだけだと認めています——EchoLeakのような事件は、世界的企業の製品でさえまだミスをしうると警告しています。
二つめのリスクは、guardrailを締めすぎるとAIが役に立たなくなること。検問所を厳しくしすぎて、何でも人の承認サインが要るようにすると、agentは「人の代わりに働く」価値を失ってしまう。本当の課題は、安全と機敏さのちょうどいい釣り合いを見つけることで、まだ決まった正解はありません。
三つめのリスクは、非対称な戦いです。悪意ある側は弱点を一つ見つければいいのに、守る側はすべての穴をふさがなければならない。そして両者がAIで加速すれば、ゲームはいっそう速くなる——追いつけない守り手は、これまで以上に大きく不利になります。
短くまとめると:私たちはいま、AIがただ「話す」だけでなく、現実のシステムで私たちの代わりに「手を動かす」時代を開いています。そして新しい能力はどれも、新しい攻撃口を連れてきます。AI Security & Agent Guardrailsは、たった一つの問いに答えるために生まれた分野です——だまされたときちゃんと止められる範囲で、AIにどこまで手を動かすことを任せられるのか。まだ序章ですが、AI業界まるごとが欠かせない一章なんです。