メガトレンド · 人工知能
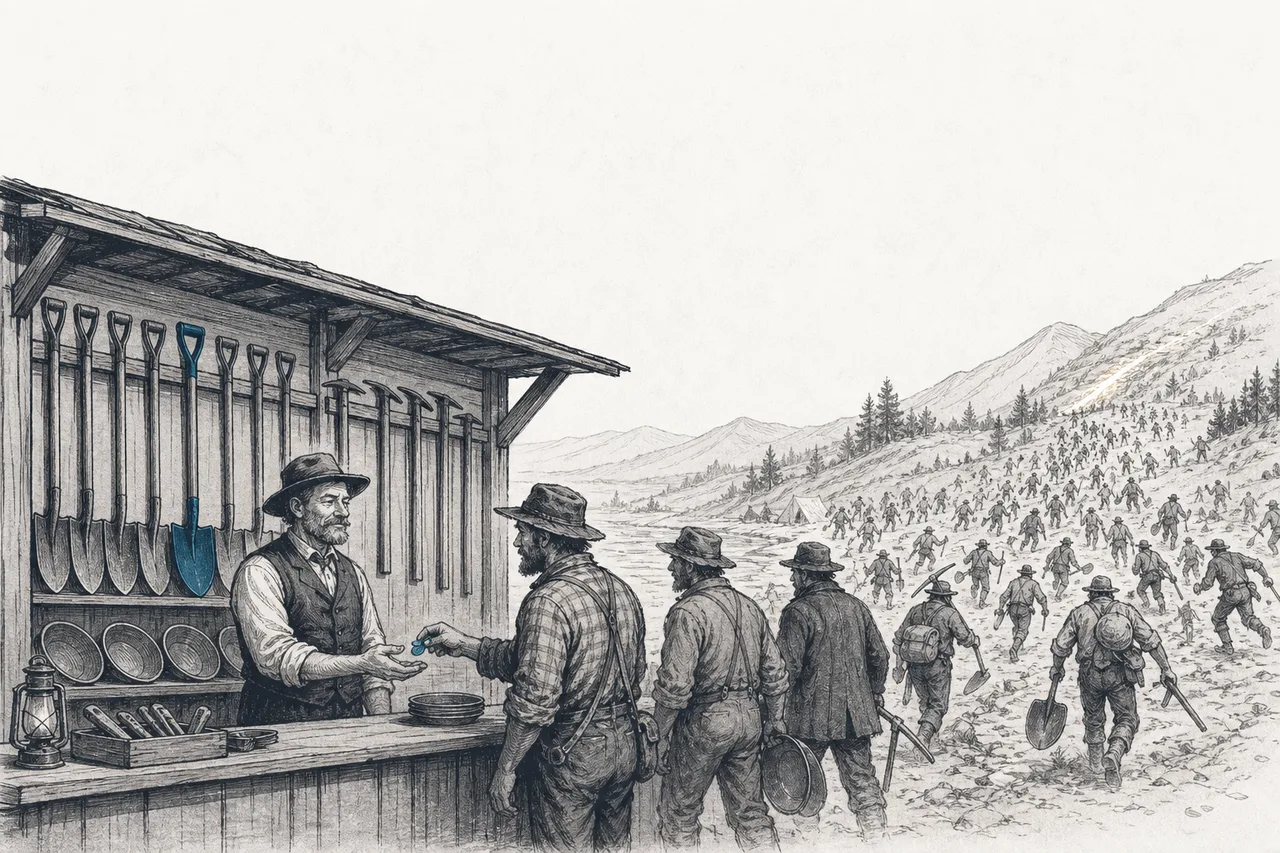
ゴールドラッシュで本当に儲けたのは、ツルハシを売った人だった
誰もが「どのAIモデルが勝つのか」に釘付けです——GPT、Gemini、Claude、それともLlama。でも、そのモデルたちの下には、もっと地味な「ソフトウェアの層」があります。データを整え、モデルを訓練し、本番で動かし、おかしくなっていないか見張る——これがAIゴールドラッシュの「ツルハシとスコップ」なんです。どのモデルが勝とうがお金を稼げるビジネスで、DatabricksやScale AIのような会社が、一般にはほとんど名前を知られないまま数兆円規模の巨人になっている場所でもあります。
01これは何?(AIの「ツルハシ」の層)
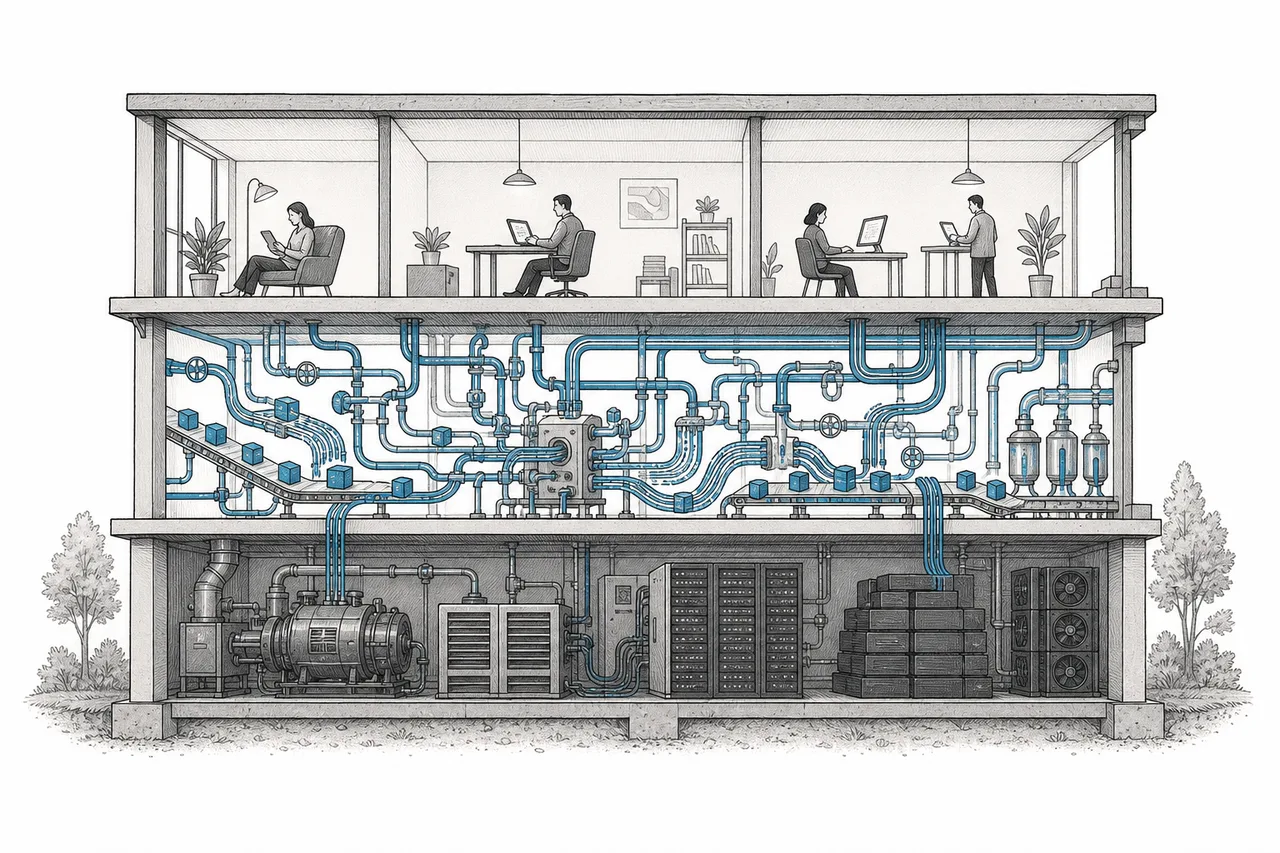
AIと聞くと、私たちはまず「モデル」を思い浮かべます——GPTやGeminiのような脳みその塊です。でもモデル単体は、工場の床に置かれただけのエンジンと同じ。まだ車を走らせることはできません。実際のビジネスで動かすには、その周りに膨大な仕組みが要ります——そしてその「周りの仕組み」こそが、このnodeなんです。
このnodeはメガトレンドArtificial Intelligenceの下にあるサブテーマです。定義は短いけれど的を射ています——「AIを訓練・実行・制御・監視するためのデータと運用の層、いわばツルハシとスコップ型のソフトウェア」。言い換えれば、モデルそのものではなく、モデルの下にあるすべて。大きく四つの塊に分けられます:
- データ(Data): モデルが学べるようにデータを整え、きれいにし、「ラベルを貼る」——Scale AIのような会社がこれを担い、加えてDatabricksやSnowflakeといった大規模なデータプラットフォームがある
- 検索のための保存(Retrieval): vector databaseと呼ばれる新しい種類のデータベース(例:Pinecone)。AIが「記憶を引き出して」要点に合う情報を見つけられるようにする——いま人気の手法RAGの心臓部だ
- デプロイ&配信(Deploy & Serve): 訓練し終えたモデルを「本番で動かし」、何百万人もの利用者が同時に、速く安く呼び出せるようにする
- 監視&評価(Observability & Eval): モデルが正しく答えているか、コストがかかりすぎていないか、おかしくなり始めていないかを見張る——Datadogのような会社がここに本格参入している
MLOps(Machine Learning Operations)= ソフトウェア業界のやり方(自動化・再現可能・検証可能)を、AIモデルの「製造と運用」に持ち込み、手作業ではなく仕組みとして回すための考え方とツール · LLMOpsは、それを大規模言語モデル(LLM)に特化させた版で、答えをでっち上げる(hallucination)や、トークン代が高いといった固有の問題を扱う
ひとことで言えば、Foundation Modelsが「エンジン」なら、このnodeは「組み立てライン・燃料系・管制室」——そのエンジンを実際の道路で走らせるための仕組みです。
02なぜ「ツルハシを売る」方が「金を掘る」より良いのか
カリフォルニアのゴールドラッシュから伝わる古い格言があります——「ゴールドラッシュでいちばん儲けたのは、掘り手ではなくツルハシを売った人だ」。掘り手の多くは手ぶらで帰ったけれど、誰もがツルハシは買わなければならなかった——これがこのnodeの投資テーゼそのものです。
いまのAIモデル争いでは、最後にGPT、Gemini、Claude、それともオープンソースのモデルが勝つのか、誰にもわかりません。だから特定のモデルに賭けるのはとても危険です。でもどのモデルが勝とうとも、どれもよくラベル付けされたデータを使い、どこかで動かさなければならず、誰かが見張る必要がある。だからこのツルハシ層は、勝者だけでなく「会場全体」からお金を集められるんです。
このツルハシ層の規模は、ほとんどあらゆる市場より速く伸びています。とくにMLOps市場は、2024年の約22億ドルから2030年には約166億ドルへ、年平均40%超で伸びると見られています。一方、AIインフラ全体(ハードウェア+ソフトウェア)の市場は、2026年にはすでに数千億ドル規模に達しています。
この市場が爆発している理由は、各社が痛い思いをして学んだ一つの事実にあります——会議室で見栄えのよいAIのデモを作るのは簡単だが、それを本番で安定して、安全に、お金を燃やさずに動かすのはとても難しい。「うまくいくデモ」と「実際に使えるシステム」の間の溝——そここそ、このツルハシ層が稼ぐ場所です。
03どう動くのか — MLOpsのサイクル
このnodeの心臓部は「MLOpsのサイクル」と呼ばれるものです——一度やれば終わりの直線ではなく、止まることなく回り続ける円です。AIモデルは普通のソフトウェアと違い、時間とともに劣化します(世界が変わり、新しいデータが入ってくる)。だから何度も訓練し直すために、ぐるりと戻ってくる必要があるんです。
一歩ずつたどってみましょう:(1) データが出発点——モデルの良し悪しは、与えるデータで決まる。ここでは集めて、きれいにし、「ラベルを貼る」(この画像は猫、この文は丁寧、など)。Scale AIが何百万人時もかけてやっている仕事だ · (2) モデルを訓練は、データを使ってモデルを教える、または「チューニング」する段階。どの設定がいちばん効くか、実験のたびに記録していく · (3) 本番で実行は、モデルを利用者が呼び出せるよう配信する段階。答える前に実データを引いて補強するRAGの手法も含まれる · (4) 監視は、モデルの応答が遅くなっていないか、高くついていないか、でたらめを言い始めていないかを見張る段階だ。
肝は図の中の色の濃い矢印——「監視」の段階が見つけたものは、次の一周のデータへと戻され、輪全体が回り続けます。これが、本番で動くAIを「一度きりで終わるプロジェクト」とは別物にしている点です。AIは育て続けなければならない「生きもの」——そしてこの輪のどの段階も、ツルハシ層の会社が売れる商品なんです。
RAG(Retrieval-Augmented Generation)= AIに答えさせる前に、関係する実際の文書を「検索」して貼り付けておく手法。でたらめな答えを減らし、その会社の最新データを参照できるようにする · Vector database = データを「意味の座標」として保存する新しい種類のデータベース(例:Pinecone)。単に語が一致するものではなく、意味が近いものを見つけられる——RAGを成り立たせる中心的な道具だ
04AIのエコシステムの中で、どことつながっているのか
このnodeはAIスタックの「中間層」に座っています——下の層から受け取り、上の層へ渡す存在です:
- Foundation Modelsに供給し、そこから受け取る: このツール群は、モデルを作る研究所(OpenAI、Anthropic、Google)が訓練とチューニングに使うもの。同時に、出てきたモデルも利用者に届くためにはこのツール層の上で動かなければならない——この二層は固く結びついている
- AI Applications & Copilotsの土台になる: 企業が作るすべてのAIアプリ(顧客対応アシスタント、ソフトウェアの中のcopilot)は、このデータ+ツールの層の上に立つ。vector databaseとMLOpsがなければ、そうしたアプリは作れない
- Agentic AIの背骨になる: 自分で何段階も動くAI(agent)は、自分で判断できるぶん、監視とevalがこれまで以上に重くなる——間違いが遠くまで波及するからだ
- Cloud & Digital Infrastructureに頼る: これらのツールは主にクラウド上で動き、しかも大手クラウドはこの層を自社サービスとして飲み込もうとしている——取引先であり競合でもある
- エネルギーと電力+重要原材料の需要に火をつける: モデルの訓練と実行は膨大な電力とチップを食う。だからこの層は、サプライチェーン全体のエネルギー需要を押し上げる起点になる
覚え方は簡単です:AIスタックを下から上へたどると——チップとクラウドがいちばん下、モデルが真ん中、アプリがいちばん上——このnodeは、すべての層をつなぐ「モルタルと配管」。データを流し、モデルを実際に動かせるようにします。だからこそ、地図全体の中で最も多くの他トレンドとつながるnodeの一つなんです。
05いま、どこまで来たのか
2026年は、このツルハシ層が「言葉」ではなく「実際のお金」で自らを証明した年です。データ層の二大リーダーを見てみましょう:Databricks(非公開企業、データ+AIプラットフォーム)は売上が年換算で54億ドル、65%増に達し、AI製品だけの売上も14億ドル(全体の約26%)に届いた。直近の資金調達では1,340億ドルという高い評価を受け、1,650〜1,750億ドルの新ラウンドを交渉中との報道もある。
上場企業の側では、Snowflake(SNOW)が2026会計年度の通期製品売上で47.2億ドルを計上し、9,100社超の顧客がAI機能(Cortex)を使い始めています——企業がchatbotで遊ぶ段階を越え、AIを自社データのすぐ隣で働かせ始めていることの表れです。
注目したいのは、この層の本当の主役の多くが、まだ株式市場にいない非公開企業だという点です——Databricks、Scale AI、Pineconeはどれも高い評価額の非公開企業で、一般の人が直接投資するのは難しい。だから私たちは、下のプレーヤーを生の時価総額ではなくMLOpsのサイクルにおける役割と、リーダーシップのシェアで並べています。誰がこのツルハシ層のどこを実際に握っているのかが見えるように。
06これからの展開
第一の方向はRAGとvector databaseが標準になることです。企業はAIにでたらめを言わせたくないし、自社内部のデータを参照させたい。RAG市場は2025年の約23億ドルから、次の10年で数百億ドル規模へ、年平均40%超で伸びると見られています——ツルハシ層の中でも最も速く伸びるカテゴリの一つです。
第二の方向は重心が「訓練」から「実行と監視」へ移ることです。初めは大きなモデルの訓練にお金が注がれましたが、AIが実際に広く使われ始めると、重心は毎日休みなく発生する「本番実行(inference)」と「監視」へ移っていきます——observabilityの会社DatadogがこれほどAIに沸いているのはこのためなんです。モデルの呼び出し一回一回が、計測され見張られるべき対象だからです。
第三の方向はAgentic AIのためのツールです。AIが自分で何段階も動き始める(チケットを予約する、コードを書く、調整する)と、「それが何をしたかを追跡する」「どれくらい信頼できるかをテストする」ことが、まるごと新しいツール層になります。まだはっきりした勝者がいない——いまから陣取りできる開かれた戦場です。
07課題とリスク
「ツルハシを売る人」の魅力には、それ特有のリスクがついてきます。そして最大のものが飲み込み(consolidation)です。
問題は、このツルハシ層が小さなツール系スタートアップであふれていることです。でも企業の顧客は、20社から20個のツールを買いたくありません。「これ一つで完結するプラットフォーム」が欲しいのです。結果として巨人たち——とくにAWS、Azure、GoogleのようなクラウドやAIクラウド事業者——が、小さなツールを買収したり機能を真似たりして、自社のサービスに取り込んでいます。
第二のリスクは浅い堀(thin moat)です。この層の一部のツールは、何をするものか分かれば真似されやすい。vector databaseがその例です——最初は最先端技術と見られていましたが、ほどなく既存のデータベース(PostgreSQL、MongoDB、Oracle)がこの機能を取り込みました。結果、先駆者たちは「顧客がすでに持っているデータベースに付いてくる無料の機能」と競う羽目になっています。
第三のリスクはAIブームへの依存です。この層の急成長は、世界中がAIに巨額を投じていることに支えられています。もしAI投資のサイクルが減速すれば——あるいは企業でのAIの見返りが期待外れに終われば——こうしたツールの需要も鈍ります。Scale AIで一部の顧客がMetaとの取引を受けて後ずさりした件も、リーダーでさえ固有の弱点(この場合は少数顧客への依存とデータ機密の問題)を抱えていることを警告しています。
ひとことでまとめると:ゴールドラッシュの伝説では、ツルハシを売った人こそが静かに、いちばん堅実に儲けました。AIのデータ+ツール+MLOpsの層も、同じ役回りを演じています——モデルそのものほど派手ではないけれど、誰が金を掘り当てようと、今回のゴールドラッシュがどう終わろうと、「実際のお金」が毎日流れ続ける場所なんです。