Megatrend · Robotics & Physical AI
หุ่นยนต์มีร่างกายมานานแล้ว — สิ่งที่ขาดคือ “สมอง”
เรามีแขนกล มอเตอร์ และมือหุ่นยนต์ที่แม่นยำมาหลายสิบปี แต่หุ่นยนต์ยังทำได้แค่งานที่ “เขียนโปรแกรมไว้เป๊ะๆ” ในกรงที่ล้อมไว้ พอเจอของวางผิดที่นิดเดียวก็ทำต่อไม่เป็น node นี้คือเรื่องของ “ซอฟต์แวร์สมอง” — โมเดล AI ที่รับภาพจากกล้องบวกคำสั่งภาษามนุษย์ แล้วสั่งกล้ามเนื้อให้ขยับเองได้ มันคือชิ้นส่วนที่เคยขาด และเป็นคอขวดที่กั้นหุ่นยนต์ไว้จาก “เครื่องจักรในโรงงาน” ไม่ให้กลายเป็น “คนงานที่ทำอะไรก็ได้” มาเกือบศตวรรษ
01มันคืออะไร — “สมอง” ของหุ่นยนต์
ลองนึกถึงหุ่นยนต์แขนกลในโรงงานรถยนต์ มันเชื่อมเหล็กจุดเดิมได้แม่นยำเป็นล้านครั้งโดยไม่พลาด แต่ถ้าคุณวางชิ้นงานเหลื่อมไปแค่ 2 เซนติเมตร มันก็เชื่อมลงไปในอากาศอย่างหน้าตาเฉย เพราะมันไม่ได้ “เห็น” หรือ “เข้าใจ” อะไรเลย มันแค่ทำตามพิกัดที่มนุษย์เขียนไว้ทุกมิลลิเมตร นี่คือหุ่นยนต์ตลอด 60 ปีที่ผ่านมา — เก่งเรื่องทำซ้ำ แต่โง่เรื่องโลกจริง
node นี้คือเรื่องของซอฟต์แวร์ที่มาแก้ตรงนี้พอดี — สิ่งที่วงการเรียกว่า “Physical AI” หรือ AI ที่มีร่างกาย หัวใจของมันคือโมเดลชนิดใหม่ที่ชื่อ VLA (Vision-Language-Action) พูดง่ายๆ คือโมเดลที่รับ ภาพจากกล้อง (Vision) บวก คำสั่งเป็นภาษามนุษย์ (Language) เช่น “เก็บจานในอ่างเข้าเครื่องล้าง” แล้วแปลงออกมาเป็น คำสั่งขยับกล้ามเนื้อ/มอเตอร์ (Action) ได้เองโดยตรง — ไม่ต้องมีใครมาเขียนพิกัดทีละจุด
VLA (Vision-Language-Action) = โมเดลที่ต่อยอดมาจากโมเดลภาษา/ภาพขนาดใหญ่ (อย่างที่อยู่เบื้องหลัง ChatGPT) แต่เพิ่ม “ขา” ที่สาม คือผลลัพธ์เป็น การกระทำทางกายภาพ · Robot foundation model (โมเดลฐานสำหรับหุ่นยนต์) = โมเดลตัวเดียวที่ฝึกกว้างๆ จนทำได้หลายงานหลายหุ่น แทนที่จะเขียนโปรแกรมแยกทีละงาน — เหมือน “สมองอเนกประสงค์” ที่เสียบใส่ร่างไหนก็ใช้ได้
ในแผนผังเมกะเทรนด์ node นี้เป็นสาขาย่อยของ Robotics & Physical AI และอยู่ในชั้น “แพลตฟอร์ม” นิยามของมันบอกตรงประเด็นว่าเป็น “โมเดลฐาน/VLA สำหรับหุ่นยนต์ การจำลอง (simulation) และแพลตฟอร์มประมวลผลบนตัวหุ่น” กล่าวอีกแบบ — ถ้า หุ่นยนต์ฮิวแมนนอยด์ กับ ชิ้นส่วนและมอเตอร์ คือ “ร่างกาย” node นี้ก็คือ “สมองและระบบประสาท” ที่ทำให้ร่างกายนั้นมีประโยชน์
02ทำไม “สมอง” ถึงปลดล็อกร่างกาย
มีความจริงที่ฟังดูแปลกแต่สำคัญมาก: ร่างกายของหุ่นยนต์ไม่เคยเป็นคอขวด เราสร้างมือกล มอเตอร์ และเซนเซอร์ที่เก่งกว่ามือมนุษย์ในบางด้านมาหลายสิบปีแล้ว สิ่งที่ติดหนึบมาตลอดคือ “แล้วจะสั่งมันให้ทำงานในโลกที่ไม่เป๊ะยังไง” โลกจริงรกรุงรัง ของวางไม่เป็นที่ แสงเปลี่ยน คนเดินผ่าน — การเขียนโปรแกรมรับมือทุกกรณีเป็นไปไม่ได้ นี่คือเหตุผลที่หุ่นยนต์ส่วนใหญ่ยังถูกขังอยู่ในกรงในโรงงาน
VLA เปลี่ยนสมการนี้ เพราะมันเรียน “สามัญสำนึกทางกายภาพ” แทนที่จะถูกสั่งทีละสเต็ป และเงินทุนก็สะท้อนความตื่นเต้นนี้ชัดมาก ปี 2025 สตาร์ทอัพหุ่นยนต์ระดมทุนได้ราว $13,800 ล้าน — แซงสถิติปี 2021 ที่เคยเป็นจุดพีค และถ้านับนิยามกว้าง (หุ่นยนต์ + physical AI) ตัวเลขแตะราว $27,600 ล้านจากดีลกว่า 1,000 ดีล เม็ดเงินส่วนใหญ่ไม่ได้ไหลไปที่ “ร่าง” แต่ไหลไปที่ “สมอง”
ทำไมเงินถึงเทมาขนาดนี้? เพราะเดิมพันคือ “แรงงานทางกายภาพ” — งานที่ต้องใช้มือทำในโลกจริง ทั้งหยิบจับ ประกอบ ขนของ ดูแล ซึ่ง คลื่น AI ที่ผ่านมา (agentic AI) ยังแตะไม่ถึงเพราะมันทำงานได้แค่บนหน้าจอ ถ้า “สมองหุ่นยนต์” ทำงานได้จริง มันจะเปิดประตูสู่ตลาดแรงงานทั้งโลก ไม่ใช่แค่งานความรู้ — และนั่นคือเหตุผลที่นักลงทุนยอมจ่ายแพงเพื่อจองที่นั่งล่วงหน้า
03มันทำงานยังไง — “วงวนการมีร่างกาย”
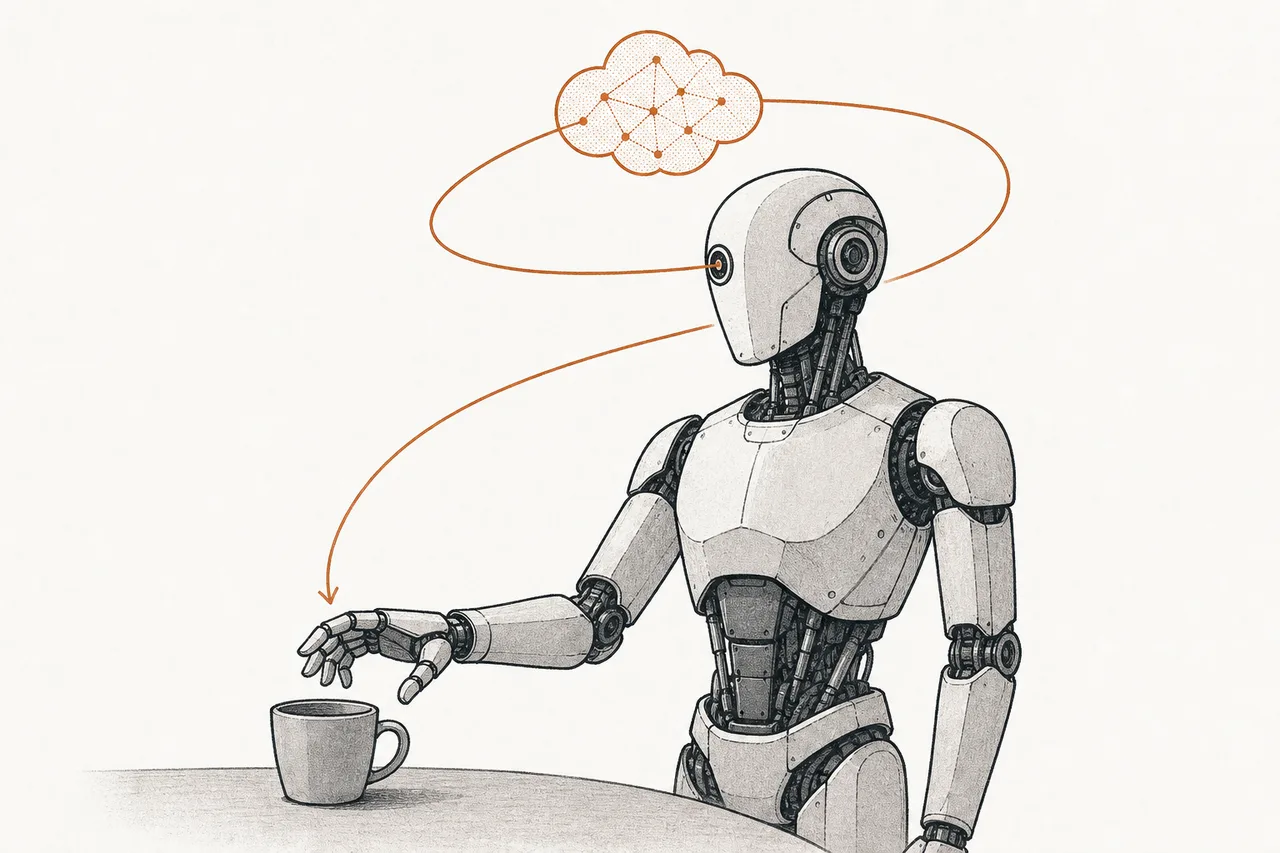
หัวใจของ Physical AI คือวงจรที่หมุนเร็วมากๆ ระหว่าง “รับรู้ → คิด → ลงมือ” แล้ววนกลับมาใหม่หลายสิบครั้งต่อวินาที — เพราะโลกจริงไม่หยุดนิ่ง ของลื่น มือพลาด แรงต้านเปลี่ยน หุ่นต้องปรับตัวตลอดเวลา ไม่ใช่วางแผนทีเดียวแล้วลุยรวด เราเรียกมันว่า “embodiment loop” หรือวงวนการมีร่างกาย
จุดที่ฉลาดที่สุด — และยากที่สุด — คือกล่องตรงกลาง (โมเดล VLA) มันต่อยอดมาจากโมเดลภาษา-ภาพขนาดใหญ่ที่ “เคยอ่านอินเทอร์เน็ตมาทั้งโลก” จึงมีสามัญสำนึกติดตัวมาก่อนแล้ว เช่นรู้ว่า “แก้วน้ำเต็มต้องถือตั้งตรง” หรือ “ของแตกง่ายต้องจับเบาๆ” โดยไม่ต้องสอน จากนั้นจึงค่อยฝึกเพิ่มด้วยข้อมูลการเคลื่อนไหวจริงของหุ่น ให้มัน “แปลงความเข้าใจเป็นการขยับ” ได้ — นี่คือสะพานที่เชื่อม “สมองที่รู้เรื่องโลก” เข้ากับ “มือที่ทำงานได้”
แต่ปัญหาคือ ข้อมูลการเคลื่อนไหวจริงของหุ่นยนต์นั้น หายากอย่างน่าตกใจ ทางออกหลักจึงเป็นกล่องประบนสุดในแผนภาพ — การให้หุ่น ฝึกในโลกจำลอง (simulation) นับล้านครั้งก่อน แล้วค่อยเอาทักษะนั้นข้ามมาทำในของจริง วิธีนี้เรียกว่า “sim-to-real” และมันสำคัญพอที่จะเป็นบทถัดไปทั้งบท
04ปัญหาที่ใหญ่ที่สุด: ข้อมูลขาดแคลน
นี่คือหัวใจที่อธิบายว่า “ทำไม AI พิมพ์กลอนได้เก่งกว่ามนุษย์ แต่หุ่นยนต์ยังพับผ้าไม่เป็น” คำตอบสั้นๆ คือ ข้อมูล โมเดลภาษาอย่าง ChatGPT ฝึกจากข้อความและภาพในอินเทอร์เน็ตที่ถ้าวัดเป็น “ประสบการณ์” แล้วเทียบเท่าราว 100,000 ปี ของเนื้อหา แต่ชุดข้อมูลการเคลื่อนไหวจริงของหุ่นยนต์ที่ใหญ่ที่สุดที่เคยมีรายงาน อยู่แค่ระดับ “1 ปี” เท่านั้น — ต่างกันแสนเท่า
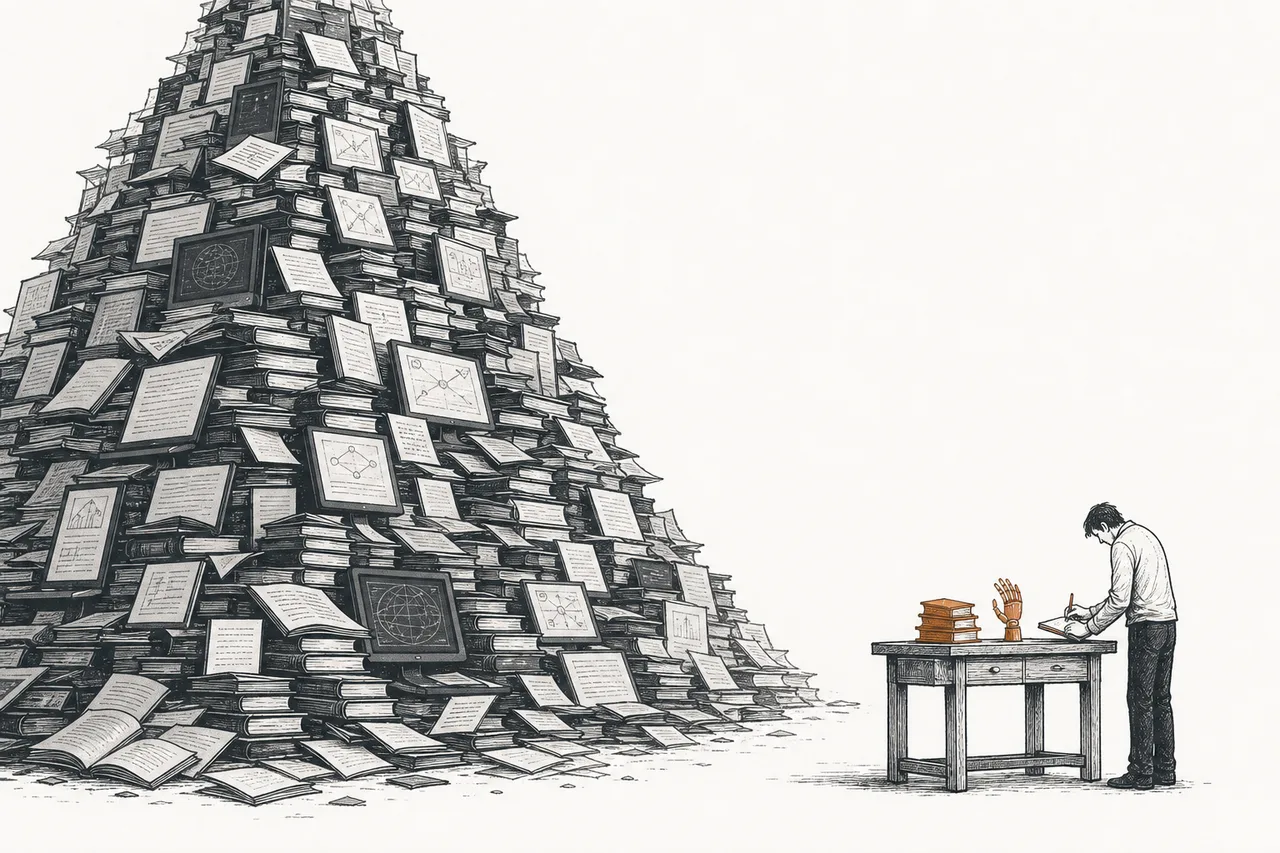
ทำไมถึงต่างกันมหาศาลขนาดนี้? เพราะข้อความ มีอยู่แล้ว ในเว็บให้ดูดมาฟรีๆ แต่ข้อมูลหุ่นยนต์ “สแครปจากอินเทอร์เน็ตไม่ได้” — ทุกครั้งที่อยากได้ข้อมูล “หยิบแก้ว 1 ครั้ง” คุณต้องมีหุ่นจริง สภาพแวดล้อมจริง และคนมานั่งบังคับหุ่น (teleoperation) ทำให้ดูทีละครั้ง มันช้า แพง และไม่สเกล นักวิจัยถึงเรียกมันว่า “ช่องว่างข้อมูล 100,000 ปี”
ทางออกที่ทั้งวงการเดิมพันคือ “โลกจำลอง (simulation)” — สร้างโลกเสมือนที่หุ่นยนต์ฝึกได้เป็นล้านครั้งในเวลาไม่กี่ชั่วโมง โดยไม่ต้องมีหุ่นจริงพัง ฝึกเสร็จแล้วค่อยเอา “สมอง” ที่เรียนมาข้ามไปใส่หุ่นจริง วิธีนี้ทำให้ข้อมูลที่ขาดแคลนถูกทดแทนด้วยข้อมูลสังเคราะห์ราคาถูกมหาศาล
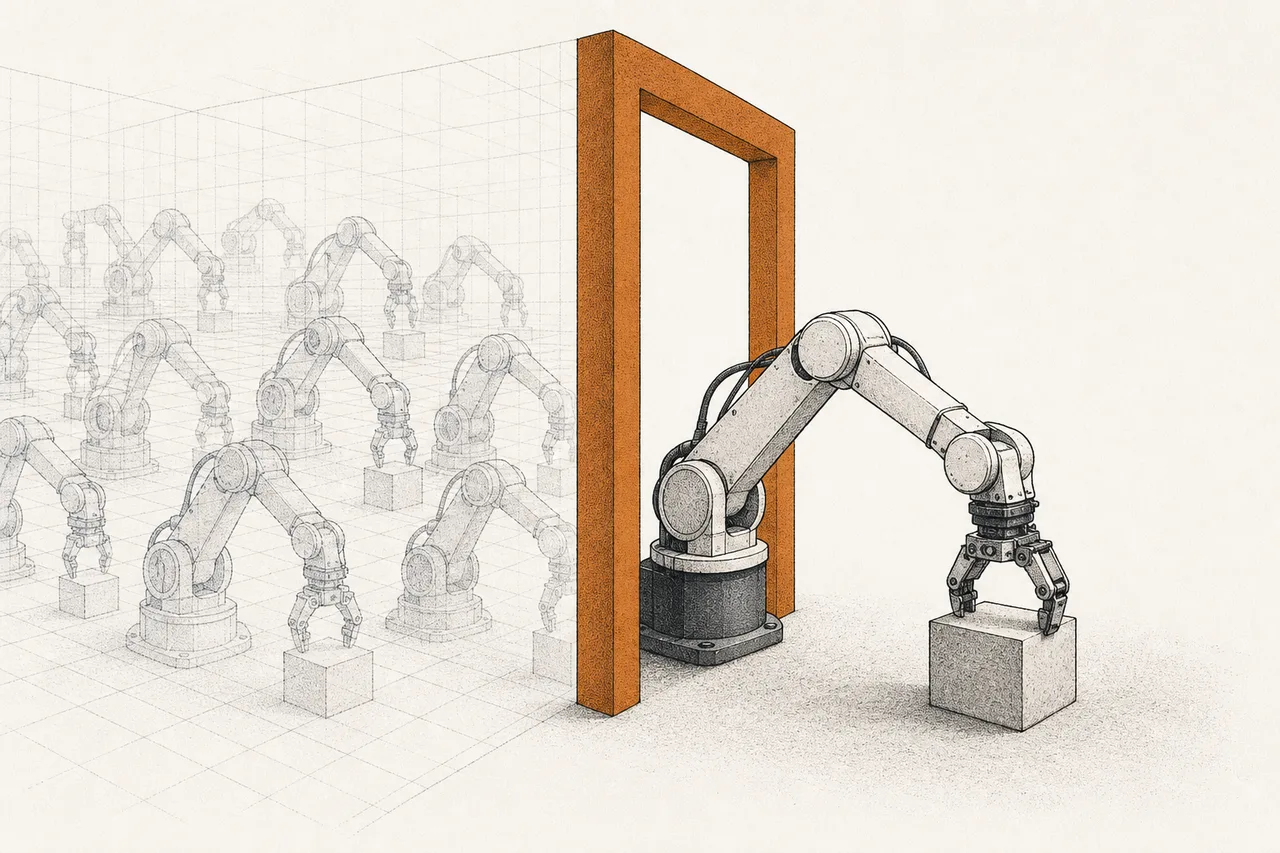
โลกจำลองไม่เคยเหมือนของจริงเป๊ะ — แรงเสียดทาน วัสดุที่บิดงอ ของที่ลื่น ล้วนจำลองยาก พอหุ่นที่เก่งในเกมออกมาเจอโลกจริง ทักษะมัก “หลุด” นี่คือ sim-to-real gap งานวิจัยปี 2025 ประเมินคร่าวๆ ว่า ข้อมูลจำลองราว 8 ตัวอย่าง ให้ผลเทียบเท่าข้อมูลจริง 1 ตัวอย่าง — จำลองช่วยได้มาก แต่ไม่ฟรี และ “ช่องว่างเรื่องฟิสิกส์การสัมผัส” ยังเป็นด่านที่ยากที่สุด
นี่คือเหตุผลที่ node นี้ ไม่ได้มีแค่ “โมเดล” แต่รวม “แพลตฟอร์มจำลอง” ไว้ในนิยามด้วย — เพราะใครคุมโรงงานผลิตข้อมูลจำลองที่สมจริงที่สุด ก็คุมวัตถุดิบที่หายากที่สุดของวงการ
05มันนั่งอยู่ตรงไหนของ Robotics
วิธีที่ง่ายที่สุดในการเข้าใจ node นี้ คือมองหุ่นยนต์เป็น “สิ่งมีชีวิต” แล้วถามว่าชิ้นส่วนไหนอยู่ตรงไหน:
- คือ “สมองและระบบประสาท” ของ Robotics & Physical AI: เทรนด์แม่คือหุ่นยนต์ทั้งระบบ node นี้คือชั้นซอฟต์แวร์ที่ทำให้ร่างนั้นคิดและตัดสินใจเองได้ ไม่ใช่แค่ทำตามสคริปต์
- สั่งการ “ร่างกาย” อย่าง หุ่นยนต์ฮิวแมนนอยด์ และ ชิ้นส่วน & มอเตอร์ (actuation): ฮาร์ดแวร์ที่ดีแค่ไหนก็ไร้ค่าถ้าไม่มีสมองสั่ง — และในทางกลับกัน สมองที่ฉลาดก็ทำอะไรไม่ได้ถ้าไม่มีมือที่แม่นพอ ทั้งสองต้องไปด้วยกัน
- ต่อยอดจาก AI และ Foundation Models (โมเดลฐาน): VLA ไม่ได้เกิดจากศูนย์ มันคือโมเดลฐานภาษา-ภาพที่ถูก “ต่อขา” ให้สั่งการได้ ความเก่งของ AI โดยรวมจึงเป็นเพดานที่จำกัดความเก่งของหุ่น
- กิน ชิป AI หนัก ทั้งตอนฝึกและตอนคิดบนตัวหุ่น: หุ่นต้องคิดแบบเรียลไทม์ขณะเคลื่อนไหว จึงต้องการชิปประมวลผลบนตัว (onboard inference) ที่แรงและกินไฟต่ำ
และเพราะ node นี้คือ “แขนขาในโลกจริง” ของ AI มันจึงเชื่อมออกไปไกลกว่าวงการหุ่นยนต์ — มันช่วยรับมือ สังคมสูงวัย (ขาดแรงงานดูแล) ได้โดยตรง และยังพึ่งพา วัตถุดิบสำคัญ อย่างมอเตอร์และแม่เหล็กในห่วงโซ่อุปทาน
06ตอนนี้ไปถึงไหนแล้ว + ใครคือผู้เล่นตัวจริง
ปี 2025–2026 คือช่วงที่ Physical AI กระโดดจากงานวิจัยสู่ “แพลตฟอร์มจริง” ตัวเร่งสำคัญคือ Nvidia ที่วางตัวเป็น “ผู้ขายจอบเสียม” ของวงการ — แทนที่จะสร้างหุ่นเอง มันสร้างแพลตฟอร์มครบชุดให้ทุกคนใช้ ในเดือนมีนาคม 2025 Nvidia เปิดตัว Isaac GR00T N1 ที่เคลมว่าเป็น “โมเดลฐานหุ่นยนต์ฮิวแมนนอยด์แบบเปิดตัวแรกของโลก” คู่กับ Omniverse + Cosmos สำหรับสร้างโลกจำลองและข้อมูลสังเคราะห์ และชิป Jetson Thor สำหรับคิดบนตัวหุ่น
ที่บอกว่ามันกลายเป็น “มาตรฐานกลาง” จริง คือผู้ผลิตหุ่นยนต์อุตสาหกรรมรายใหญ่อย่าง FANUC, ABB, KUKA และ Yaskawa — ซึ่งมีหุ่นยนต์ติดตั้งทั่วโลกรวมกันกว่า 2 ล้านตัว — หันมาใช้ไลบรารี Omniverse และเฟรมเวิร์กจำลองของ Nvidia เพื่อทดสอบสายการผลิตด้วย “ฝาแฝดดิจิทัล” ก่อนสร้างจริง รุ่นต่อๆ มา (GR00T N1.7 และที่พรีวิวไว้คือ GR00T N2) เคลมว่าทำงานในสภาพแวดล้อมใหม่สำเร็จมากกว่าโมเดล VLA ชั้นนำเดิมราว 2 เท่า
ขณะเดียวกันฝั่ง “ห้องแล็บโมเดลล้วน” ก็แข่งกันดุเดือด Google DeepMind ออก Gemini Robotics 1.5 ที่ “คิดก่อนทำ” และโอนทักษะข้ามหุ่นต่างชนิดได้โดยไม่ต้องฝึกใหม่ ส่วนสตาร์ทอัพก็ร้อนแรงเป็นพิเศษ — Physical Intelligence (โมเดล π) ถูกตีมูลค่า $5.6 พันล้านในเดือนพ.ย. 2025 และมีรายงานว่ากำลังคุยระดมทุนรอบใหม่ที่ดันมูลค่าทะลุ $11 พันล้าน ส่วน Skild AI ระดมทุน Series C $1.4 พันล้าน ดันมูลค่าขึ้น 3 เท่าเป็น $14 พันล้านในเวลา 7 เดือน โดยมี SoftBank, Nvidia และ Samsung ร่วมลง
หมายเหตุสำคัญสำหรับนักลงทุน: ผู้เล่นที่อยู่ “หัวหอก” ของชั้นโมเดลล้วน เกือบทั้งหมดยังเป็นบริษัทเอกชน ที่ไม่ได้อยู่ในตลาดหุ้น (Physical Intelligence, Skild AI, Figure ที่ทำโมเดล Helix) วิธีลงทุนในเทรนด์นี้ผ่านตลาดหุ้นจึงมักเป็นการลงทุนใน “ผู้ขายแพลตฟอร์มและชิป” (อย่าง Nvidia) หรือบริษัทใหญ่ที่มีทีมหุ่นยนต์เป็นส่วนหนึ่ง (อย่าง Google, Tesla, Baidu) มากกว่าจะซื้อ “ตัวจริงที่ทำโมเดลหุ่นยนต์ล้วนๆ” ได้ตรงๆ
07อนาคตข้างหน้า
ทิศทางแรกคือแนวคิด “world model” (โมเดลโลก) — แทนที่หุ่นจะแค่ตอบสนองเฉพาะหน้า ให้มันสร้าง “แบบจำลองในหัว” ว่าโลกทำงานยังไง แล้ว “จินตนาการล่วงหน้า” ว่าถ้าทำอย่างนี้จะเกิดอะไร เหมือนคนที่นึกภาพก่อนยกของหนัก โมเดลรุ่นใหม่อย่างที่ Nvidia พรีวิวไว้ (GR00T N2 บนสถาปัตยกรรม “world action model”) เดินไปทางนี้ — และมันคือกุญแจที่จะทำให้หุ่น “รับมือสถานการณ์ที่ไม่เคยเจอ” ได้
ทิศทางที่สองคือ “โรงงานข้อมูล” จะกลายเป็นสมรภูมิ เมื่อข้อมูลจริงคือของหายาก ใครผลิตข้อมูลสังเคราะห์คุณภาพสูงได้มากและถูกที่สุด (ผ่านโลกจำลอง + วิดีโอมนุษย์) ก็จะได้เปรียบเชิงโครงสร้าง — นี่คือเหตุผลที่แพลตฟอร์มจำลองอย่าง Omniverse/Cosmos อาจมีค่าพอๆ กับตัวโมเดลเอง
ทิศทางที่สามคือ การลงตัวระหว่าง “สมองบนคลาวด์” กับ “สมองบนตัวหุ่น” งานคิดหนักๆ (วางแผน) อาจอยู่บนคลาวด์ ส่วนงานที่ต้องเร็วระดับมิลลิวินาที (ทรงตัว หลบสิ่งกีดขวาง) ต้องคิดบนตัวหุ่นเอง การออกแบบให้สองชั้นนี้ทำงานร่วมกันลื่นไหล — และทำได้ในงบไฟและงบชิปที่จำกัดบนตัวหุ่น — คือโจทย์วิศวกรรมใหญ่ของรอบถัดไป
08ความท้าทาย & ความเสี่ยง
เบื้องหลังกระแสและเม็ดเงินมหาศาล Physical AI มีกำแพงที่ต้องพูดตรงๆ และกำแพงแรกคือสิ่งที่เราคุยไปแล้ว — ข้อมูลขาดแคลน ตราบใดที่การเก็บข้อมูลจริงยังต้องใช้คนบังคับหุ่นทีละครั้ง และโลกจำลองยัง “ไม่เหมือนจริงพอ” (sim-to-real gap) การไต่จาก “เดโมสวยๆ ในคลิป” ไปสู่ “ทำงานได้ทุกบ้านทุกโรงงาน” ก็จะช้ากว่าที่กระแสคาด
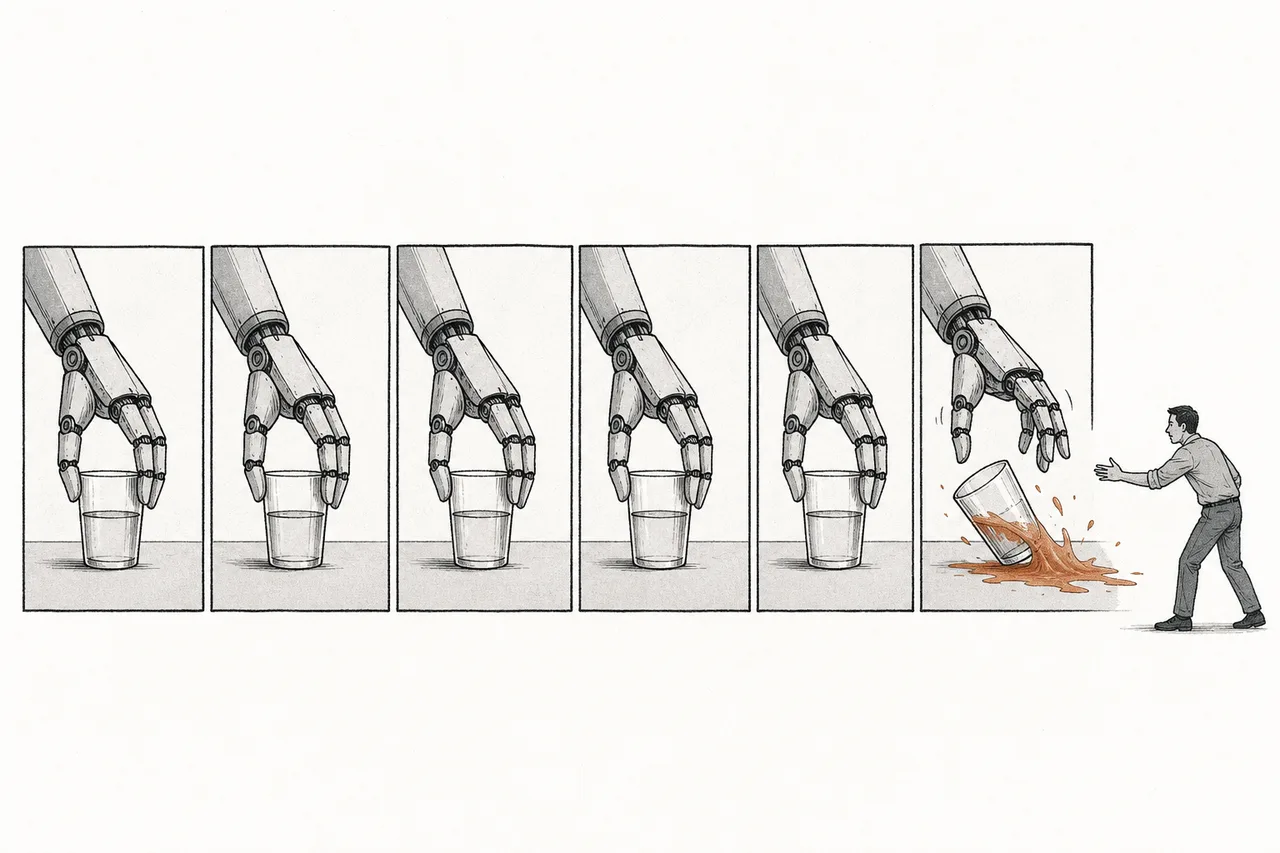
ความเสี่ยงข้อสองคือ “ความน่าเชื่อถือ” ในโลกซอฟต์แวร์ AI ที่ทำถูก 95% ก็ถือว่าเก่งมาก แต่ในโลกกายภาพ 95% หมายถึง “ทำของหล่นหรือพัง 1 ใน 20 ครั้ง” ซึ่งรับไม่ได้ในงานจริง เพราะการกระทำทางกายภาพ ย้อนคืนไม่ได้ — แก้วแตกแล้วแตกเลย คนเจ็บแล้วเจ็บจริง การไต่จาก “เก่ง” ไปสู่ “เชื่อถือได้ทุกครั้ง” คือช่วงที่ยากและกินเวลานานที่สุด
ความเสี่ยงข้อสามคือ “มูลค่าที่ลงทุนยากและราคาแพง” หัวหอกตัวจริงของชั้นโมเดลส่วนใหญ่ยังเป็นเอกชนที่มูลค่าพุ่งเร็วมาก (Skild AI ขึ้น 3 เท่าใน 7 เดือน, Physical Intelligence จาก $5.6B จ่อ $11B) — เป็นภาพคลาสสิกของเทรนด์ที่ “ความคาดหวังวิ่งนำของจริง” ถ้าความก้าวหน้าจริงช้ากว่าคำสัญญา การปรับฐานของมูลค่ากลุ่มนี้ก็อาจรุนแรง
สรุปสั้นๆ: หุ่นยนต์มีร่างกายที่พร้อมมานานแล้ว สิ่งที่เพิ่งมาถึงคือ “สมอง” ที่ทำให้มันเข้าใจโลกและลงมือเองได้ — และคอขวดที่แท้จริงไม่ใช่ฮาร์ดแวร์ แต่คือ ข้อมูลที่หายากและความน่าเชื่อถือที่ยังไม่ถึง ใครแก้สองข้อนี้ได้ก่อน — ไม่ว่าจะด้วยโลกจำลองที่สมจริงขึ้น หรือโมเดลที่เข้าใจฟิสิกส์ลึกขึ้น — คนนั้นจะเป็นผู้กำหนดว่าหุ่นยนต์จะก้าวออกจากกรงในโรงงานมาอยู่ในชีวิตเราได้เร็วแค่ไหน