メガトレンド · 人工知能
「考えてくれる」チップと、AI時代の蛇口をひとりで握る会社
ChatGPTのすべての回答、AIが描くすべての画像、訓練されるすべてのモデルは、ほんの数種類の特別なチップを通って動いています——そしてこの市場は、たった1社がほぼ完全に支配している。しかもその「堀」を作っているのは、チップそのものではなくソフトウェアなんです。この記事では、なぜ行列の掛け算が世界を変えたのか、GPUとカスタムチップ(ASIC)はどう違うのか、そしてなぜ巨大テック各社が王者から逃れるために自前のチップを設計し始めたのかを見ていきます。
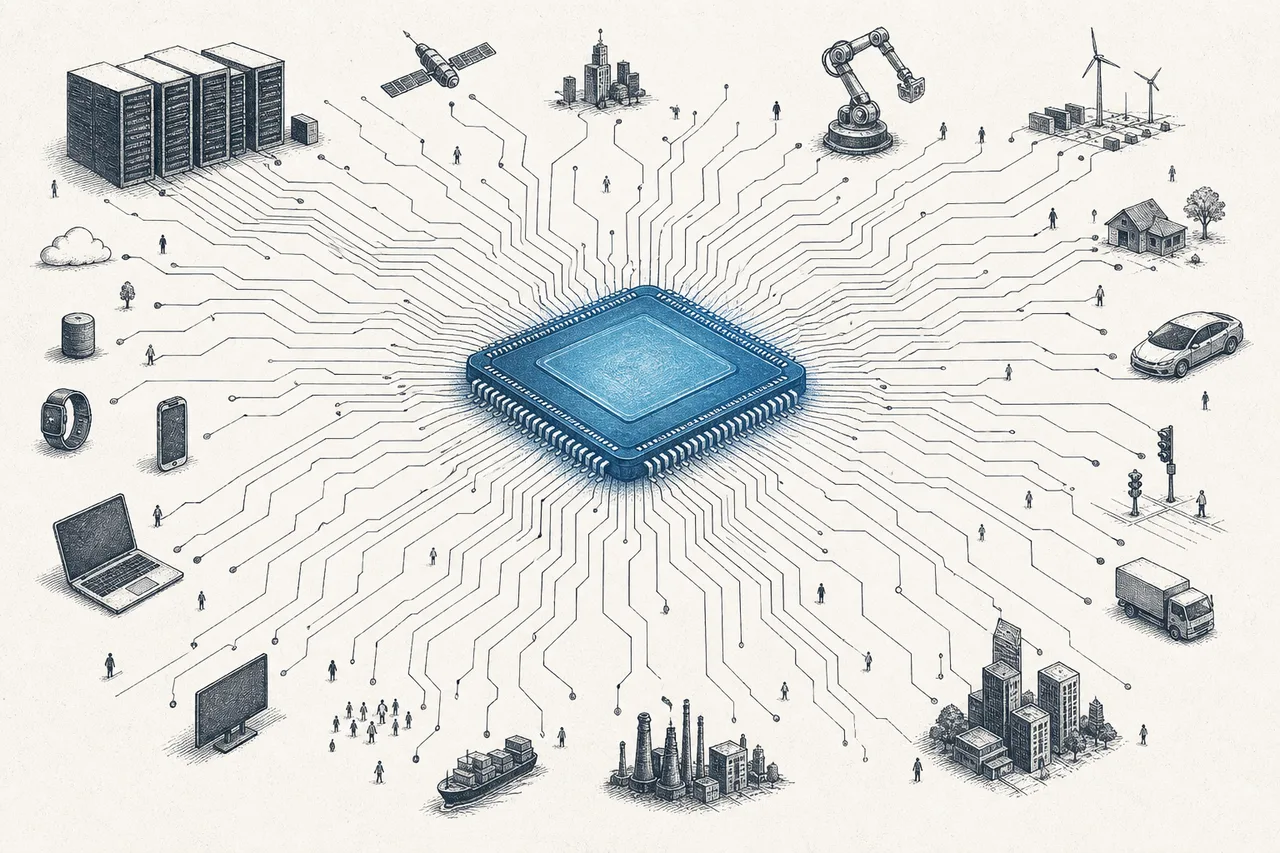
01これは何?(「考える」チップ)
ChatGPTに質問を打ち込んで数秒で答えが返ってくるとき、その裏では膨大な数のチップが、文字どおり何兆回も数字を計算しています。このnodeは、その計算をこなす「シリコン」の話——AIモデルを訓練(train)し、実行(inference)するために専用設計されたチップの話です。
「accelerator(アクセラレータ=加速装置)」という言葉がとても大事です。このグループのチップは、コンピューターの主役であるCPUを置き換えるものではなく、ある特定の仕事だけを何百倍も得意にこなす「特別な助っ人」だからです——その仕事が大きな行列の掛け算。これはあらゆるAIの心臓部にあたります(第3章でじっくり掘り下げます)。
メガトレンドの地図では、このnodeはArtificial Intelligenceの下にあるサブテーマで、その定義は「トレンド全体の中で最も供給が逼迫している(supply-constrained)層」とはっきり言い切っています——要するに、どんなに優れたAIのアイデアがあっても、チップがなければ何もできないんです。
CPU = 何でもこなす万能の頭脳。ただし一度に一つずつ · GPU(Graphics Processing Unit)= 小さなコアを数千個積んだチップで、たくさんの計算を同時にこなせる。もともとゲームの映像を描くために設計されたが、たまたまAIにぴったりだった · ASIC(Application-Specific Integrated Circuit)= ひとつの仕事だけのために設計された「専用注文」チップ。その仕事では速くて省電力だが、ほかのことはできない——GoogleのTPUやAmazonのTrainiumがASICです。
このnodeは思ったより広く、データセンター向けGPU(GPU & Merchant Accelerators)、巨大テックの専用チップ(Custom Silicon / ASIC)、モデルの実行に特化したチップ(Inference-Optimized Silicon)、特殊メモリHBM(HBM & AI Memory)、そしてモバイル機器向けのAIチップ(Edge & On-device AI Silicon)までを含みます——この記事は、それらを一本の糸でつないでいきます。
02なぜAI時代で最も逼迫した層なのか
第一の理由はお金の規模です。2026会計年度、NVIDIAの売上は2,159億ドルに達し、65%伸びました。データセンター向けチップ事業だけで2,000億ドルを超え——前年の1,152億ドルからの急増です。これは普通の会社の成長ではなく、世界中のAI投資を一社が本流として吸い上げている姿です。
第二の理由はこの市場が巨大に膨らんでいること。AIアクセラレータ市場全体は2024年でおよそ1,400億ドル、多くの調査機関は2030〜2033年までに4,000〜6,000億ドルへ、年平均約16〜25%で伸びると見ています。Bloomberg Intelligenceにいたっては、アクセラレータだけで2033年に6,000億ドルを超え、メモリ・ネットワーク・CPUを含むスタック全体なら約1.7兆ドルに達しうると見ています。
第三の理由は、「逼迫」という言葉が決して大げさではないこと。NVIDIAは新型チップBlackwell(B200)の生産枠を2026年半ばまでほぼ完売させ、Microsoft、Google、Amazon、Metaといった大口顧客に優先して割り当てています。ボトルネックは需要側ではなく生産能力側——とくにHBMをGPUにつなぐ先端パッケージング(CoWoS)の工程にあります。
03どう動くのか — 行列の掛け算と、なぜGPUなのか
この記事のすべてを理解するには、たった一つの事実を押さえればいい:AIのほとんどすべての裏側は「行列の掛け算(matrix multiplication)」——大きな数字の表を二つ持ってきて掛け合わせる、それを何十億回も繰り返すことです。何兆ものパラメータを持つ大規模言語モデルも、その正体は休みなく掛け合わせ続ける巨大な行列の山にすぎません。
ここからが面白いところ。行列の掛け算は「小さな断片に分けて、同時に計算できる」——結果の各マスは、互いを待たずに別々に計算できるんです。だから、コアは少ないが一つの仕事を高速にこなすCPUはまるで歯が立たず、いっぽう小さなコアを数千〜数万個も積んだGPUは、掛け算を小さな断片に分けて一気に並行で片づけられる——これがGPUの強さの理由です。
でもこれは第二の選択肢への扉も開きます:もし仕事が本当に行列の掛け算だけなら、その仕事だけを最高にこなすチップを設計してしまえばいいのでは?——これがASIC、つまり専用注文チップの発想です。GPUは多芸(柔軟さが強み)ですが、GoogleのTPUのようなASICは必要ないものをすべて削ぎ落とし、巨大な行列計算ユニットだけを残します。結果、設計どおりの仕事では電力も費用も計算あたり安く済む——その代わり、ほかのことはできず、開発も難しくなります。
AIチップがどれだけ速くても、「データを送り込む」のが間に合わなければ意味がありません。だからどのチップも、HBM(High Bandwidth Memory)という特殊なメモリに頼ります。垂直に積み重ねてチップのすぐ隣に置くメモリで、たとえばNVIDIAのBlackwellはHBM3E 192GB・帯域8 TB/sを使います。ここがこのnodeとHBM & AI Memoryが直接出会う点——そしてHBMのボトルネックは、そのままAIチップ業界全体のボトルネックなんです。
04訓練 vs 実行 — 移り変わりつつある戦場
AIチップは性格のまるで違う二つのモードで動きます。そしてこの違いが、業界全体の未来を左右しつつあります。
- Training(訓練): モデルを一度きり、大がかりに教え込む——膨大な電力を食い、数万個のGPUをつないで何か月も回す必要がある。複雑で柔軟性が要り、NVIDIAのソフトウェアと非常に強く結びついている
- Inference(実行): 訓練し終えたモデルを「動かして」実際の質問に答える——誰かが質問を打つたび、一日に何百万回も発生する。同じ処理を繰り返し予測もしやすいので、より安く済む専用チップに向いている
転機は、AIが広まるにつれて実利用(inference)の比重が訓練を上回り続けること。そしてここがNVIDIAの堀の、いちばんの弱点なんです。CUDAという堀は主に「訓練」のために築かれたもの。世界がinferenceへ傾くにつれてCUDAに頼る必要は薄れ——巨大テックのASICや、inferenceに特化したチップ(Inference-Optimized Silicon)が割り込む隙が生まれます。
CUDAは、開発者がGPUを操るためのNVIDIAのソフトウェア一式です。怖いのは、世界中のAIライブラリやフレームワークがほぼすべてCUDA向けに最適化され、何百万人もの開発者が一生かけてそれを身につけてきたこと。だから他社のチップへ乗り換えるのは高くつき時間もかかり、ほとんど割に合いません——これがNVIDIAの本当の「堀」で、同じくらい良いチップを持つ競合でさえ顧客を奪うのが難しい理由です。
経済の理屈はとても単純です:もしGoogle、Amazon、Microsoftの専用チップが、GPUのおよそ80%の性能でinferenceをこなせて、しかも総コスト(TCO)が約40%安いなら、これらの巨人には自社内のinference業務をNVIDIAから移す強い動機がある——そして、それが現実に起きています。
05エコシステムの中でのつながり
AIチップ層は単独で浮いているわけではなく、いくつもの大きなトレンドが交わる地点です:
- AIすべての土台: モデルも、アプリも、AIエージェント(agent)も、上の層にあるものはすべてこのチップ層の上に立つ——チップが欠ければトレンド全体がつまずく
- Semiconductorsと全方位で交わる: AIチップは半導体業界の最大の顧客だ。計算(Logic)、メモリ(Memory / HBM)、製造(Foundry)すべてにまたがり、最先端のAIチップはほぼTSMCが製造している
- Energy Transition & Powerから電力を吸い上げる: AIデータセンターは膨大な電力を食い、世界の電力需要の重要な牽引役になっている——このnodeは電力に直接「drives demand(需要を生む)」
- Critical Materialsに頼る: 高品質のシリコンウエハー、特殊化学品、希少材料は欠かせない原料だ
- 設計ソフト(EDA & IP)から始まる: どんなチップも生まれる前に、SynopsysやCadenceの設計ソフト(EDA)と、ArmのコアのようなIPブロックを通る——すべての陣営から通行料を取る最上流の層(EDA & Semiconductor IPを参照)
- データセンターの中だけの話ではない: すべてのAIチップがデータセンターで動くわけではない——スマホ・PC・自動車のNPUは、速度とプライバシーのために端末上(on-device)でinferenceを走らせる(Edge & On-device AI Siliconを参照)
- ほかのトレンドを解き放つ: AIチップはRobotics、Biotech、Cybersecurityを「enables(可能にする)」——他のトレンドが立つための土台なのだ
バリューチェーンの視点で見ると、このnodeは権力が最も集中している「ボトルネック」です。三つの難所を一手に束ねているから——チップ設計(NVIDIAが先導)、製造(最先端をTSMCが独占)、そしてHBMメモリ(作れるのはわずか3社)。挑もうとする者は、この三つの関所を同時に突破しなければなりません。
06いま、どこまで来たか + 主役たち
今の構図は「一強+挑戦者の大軍」です。NVIDIAは2024〜2025年もAIアクセラレータ市場の売上ベースで約80〜90%を握っています(2024年には約90%に達した)。ただアナリストは、2026年までに約75%へ徐々に下がると見ています——NVIDIAの成長が鈍るからではなく、パイ全体が一社では食べきれないほど速く膨らんでいるからです。
いちばん雄弁に物語る違いが利益率です。2025年10月締めの四半期、NVIDIAの粗利率はおよそ73%、いっぽう2番手のAMDは約50%でした。この差こそNVIDIAが取り立てる「CUDAの堀の通行料」——そして、どの巨大テックも自前でチップを設計してこの上前を避けたがる理由です。
専用チップ側の追い上げも本物の重みを帯びてきました:BroadcomとMarvellは巨大テックのASIC設計をほぼ一手に引き受け、この市場を二社合わせて約80〜95%押さえています。そして専用チップの受注は急増中です(誰が誰にいくら発注したかは、そのnodeの記事で深掘りします)。
07これからの展開
第一の方向は比重がinferenceへ移ること。AIがあらゆるアプリと機器に組み込まれるにつれ、モデルを「動かす」処理が「訓練」を上回って計算を食い続けます。ここは専用チップや特化チップがコストで有利な戦場——NVIDIAのシェアを(首位そのものではなく)少しずつ削っていく隙間です。
第二の方向は巨大テックがそろって自前チップを持つこと。Google、Amazon、Microsoft、Meta、OpenAIは、Broadcom/Marvellを通じてASICに巨費を投じています。NVIDIA依存を減らし、自社クラウドのコストを握るためです——「みんながNVIDIAから買う」構図から、「最大の顧客が同時に競合になる」構図へと変わっていきます。
第三の方向はAIチップが端(edge)へ降りていくこと。すべてのAIがデータセンターで動く必要はありません。スマホ、自動車、IoT機器が自前のAIチップを積み始めています(Edge & On-device AI Silicon)——速度、プライバシー、クラウド代の節約のために。QualcommやAppleといったモバイル勢が有利な、新しい市場が開きます。
第四の方向はボトルネックの引っ越し。今日のボトルネックはHBMとパッケージング(CoWoS)ですが、明日は電力と冷却へ移るかもしれません——AIデータセンターが電力を食いすぎて、電力網の上限にぶつかり始めているからです。次のボトルネックを先に解いた者が、有利を握ります。
08課題とリスク
AIチップ層の魅力には、それ特有のリスクがついてきます。
第一のリスクは極端な集中。莫大な価値がほんの数社に結びついています——設計のNVIDIA、製造のTSMC、そしてHBMを作れるわずか3社。どこか一点がつまずけば(災害、地政学、技術のいずれでも)チェーン全体が揺れます。しかも最先端の製造が台湾に集中しているため、地政学リスクは決して他人事ではありません。
第二のリスクはCUDAの堀が以前ほど広くないかもしれないこと。仕事が訓練であるうちはCUDAは強固ですが、世界がinferenceへ傾けばCUDA依存はゆるみます。もし巨大テックの専用チップが十分よく働き、しかもずっと低いコストでこなせるなら、王者の73%という利益率とシェアは圧迫されうる——半導体業界の教訓はこうです、「今日の王者も、技術の波を一つ外せば転落しうる」。
第三のリスクは循環と「バブル」の問い。今のAIチップ需要がこれほど強いのは、巨大テックが一斉に巨額の設備投資(capex)を注いでいるから。もしAIの見返りが想定より遅れたり投資が減速したりすれば、果てしなく見えた需要が一気に縮みかねません——その多くが、ふところの深い同じ数社の顧客に支えられているからです。
ひとことで言えば、AIアクセラレータは、人工知能の時代を本当にオン・オフできる「蛇口」です。今日はその蛇口を、チップそのものよりソフトウェアの力で一社が握っている。でも戦場は動いています——世界が「訓練」から「実利用」へ移り、最大の顧客たちが自前のチップを作り始めるなかで。この層を理解することは、なぜそれがAI経済まるごとの心臓であり、同時にボトルネックでもあるのかを理解することなんです。