Megatrend · Semiconductors
ขั้นตอนสุดท้ายที่กลายเป็นคอขวดของยุค AI
เป็นสิบๆ ปีที่งาน “ประกอบและทดสอบชิป” คือขั้นตอนสุดท้ายที่ไม่มีใครสนใจ — งานหลังบ้าน ราคาถูก ใครก็ทำได้ แต่จู่ๆ AI ก็ทำให้มันกลายเป็นคอขวดที่แท้จริงของทั้งโลก เพราะการจะสร้างชิป AI หนึ่งตัว ไม่ใช่แค่ผลิตชิปให้เล็กลงอีกต่อไป แต่คือการ “แพ็ก” ชิปหลายชิ้นกับหน่วยความจำ HBM เข้าด้วยกันให้เป็นก้อนเดียว — และวันนี้ NVIDIA จองคิวขั้นตอนนี้ของ TSMC เต็มยาวไปถึงปี 2027
01มันคืออะไร (OSAT กับ advanced packaging)
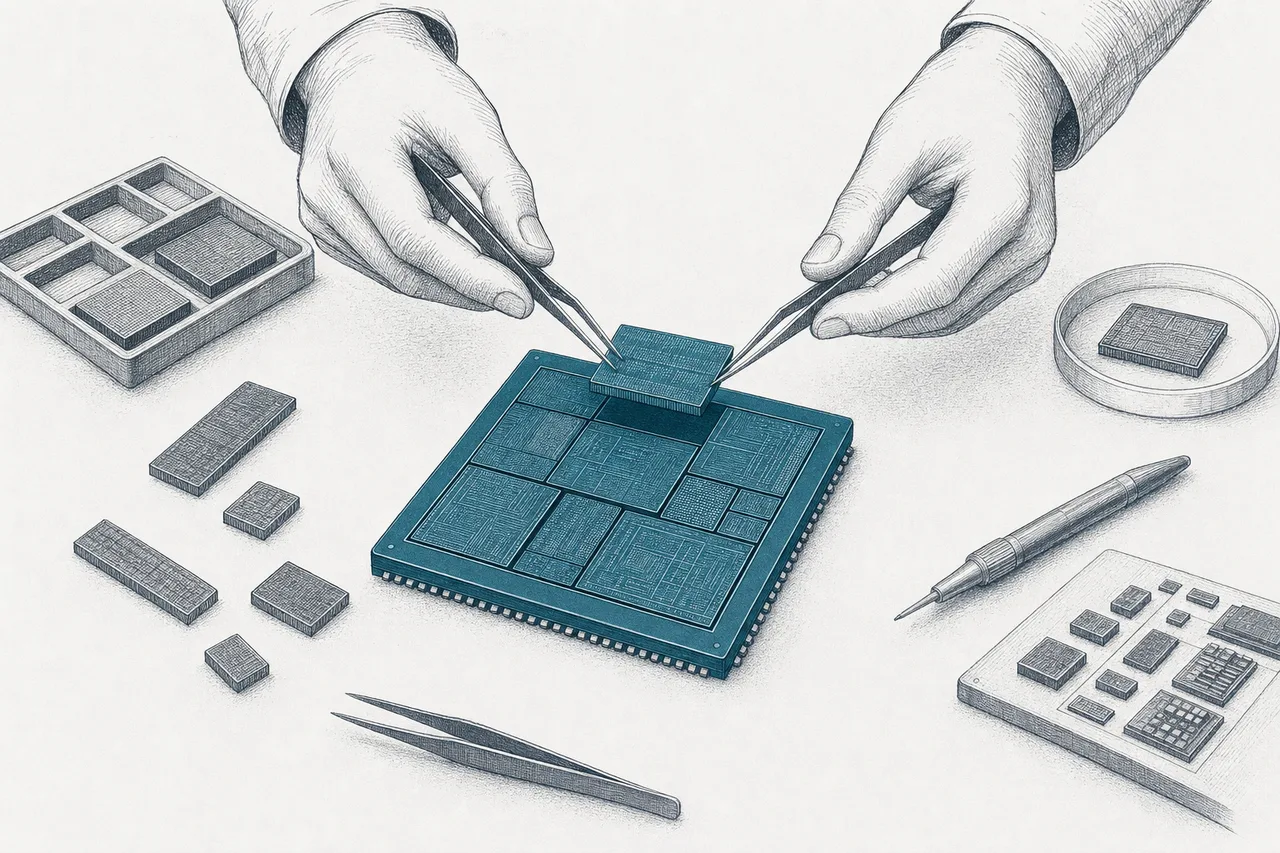
เวลาเราพูดถึงการ “ผลิตชิป” คนส่วนใหญ่นึกถึงโรงงานสุดล้ำที่พิมพ์วงจรลงบนแผ่นซิลิคอน — นั่นคืองานของ Foundry แต่ความจริงคือ พอแผ่นซิลิคอน (wafer) ออกมาจากโรงงาน มันยังใช้งานไม่ได้เลย มันเป็นแค่แผ่นกลมๆ ที่มีชิปดิบๆ เรียงกันอยู่เป็นร้อยเป็นพันตัว ต้องมีคนเอามา ตัดออกเป็นชิปทีละตัว ห่อหุ้มใส่ “แพ็กเกจ” ที่ต่อขาออกมาให้เสียบลงบอร์ดได้ แล้วทดสอบว่าตัวไหนดีตัวไหนเสีย ขั้นตอนหลังบ้านนี้แหละคือหัวใจของบทเรียนนี้
ในวงการเรียกบริษัทที่รับจ้างทำงานนี้ว่า OSAT (Outsourced Semiconductor Assembly and Test) — แปลตรงตัวคือ “รับจ้างประกอบและทดสอบชิป” มันคือแบบเดียวกับโมเดล foundry เป๊ะ แต่เป็นปลายทางอีกฝั่ง: บริษัทออกแบบชิปและ foundry ไม่อยากลงทุนทำเครื่องประกอบ-ทดสอบเอง ก็ส่งต่อให้ OSAT ทำให้ บริษัทอย่าง ASE ของไต้หวัน หรือ Amkor ของสหรัฐฯ คือผู้รับเหมาช่วงปลายสายการผลิตนี้
วงการชิปแบ่งงานเป็นสองฝั่ง · Front-end = การสร้างทรานซิสเตอร์ลงบนแผ่นเวเฟอร์ (งานของ foundry, ใช้เครื่อง EUV, ล้ำและแพงสุด) · Back-end = การเอาเวเฟอร์มาตัด ประกอบเป็นแพ็กเกจ และทดสอบ (งานของ OSAT) เป็นเวลานานที่ back-end ถูกมองว่าเป็น “ขั้นตอนน่าเบื่อราคาถูก” ต่อท้ายของจริง — แต่ AI กำลังพลิกความเชื่อนี้
แต่ความน่าสนใจอยู่ที่คำว่า “advanced” packaging สมัยก่อนการแพ็กชิปคือแค่เอาชิปตัวเดียวใส่กล่องพลาสติกแล้วต่อขาออกมา — งานง่ายๆ กำไรบางๆ แต่ advanced packaging คือการเอา ชิปหลายชิ้นมาประกอบเข้าด้วยกันในแพ็กเกจเดียว ให้มันคุยกันได้เร็วเหมือนเป็นชิปตัวเดียว ตัวเอกของยุคนี้คือเทคโนโลยีชื่อ CoWoS ของ TSMC ที่ใช้ประกอบชิป AI ของ NVIDIA เข้ากับหน่วยความจำ HBM — และมันคือคอขวดที่ทั้งโลกแย่งกันอยู่ตอนนี้
ในแผนผังเมกะเทรนด์ของเรา node นี้เป็นสาขาย่อยภายใต้ Semiconductors และมันคือ “ด่านสุดท้าย” ก่อนชิปจะออกไปอยู่ในเซิร์ฟเวอร์ AI จริงๆ — ด่านที่จู่ๆ ก็แคบที่สุดในทั้งสายการผลิต
02ทำไมขั้นตอนสุดท้ายถึงกลายเป็นคอขวด
เรื่องนี้เริ่มจากปัญหาทางฟิสิกส์ — Moore’s Law กำลังช้าลง เป็นสิบๆ ปีที่วงการชิปเก่งขึ้นด้วยการทำทรานซิสเตอร์ให้เล็กลงเรื่อยๆ อัดได้แน่นขึ้นบนชิปตัวเดียว แต่ตอนนี้มันเล็กลงไปอีกได้ยากและแพงขึ้นมหาศาล แถมยังมี “กำแพงขนาด” (reticle limit) — ขีดจำกัดทางกายภาพว่าเครื่องพิมพ์วงจรพิมพ์ชิปได้ใหญ่สุดแค่ไหน ชิป AI ที่ต้องการพลังมากๆ จึงชนเพดานนี้ ทำเป็นชิปก้อนเดียวไม่ได้แล้ว
ทางออกคือเปลี่ยนวิธีคิด: แทนที่จะทำชิปก้อนเดียวให้ใหญ่และล้ำขึ้น ก็ เอาชิปเล็กๆ หลายชิ้น (เรียกว่า chiplet) มาประกอบต่อกัน ให้ทำงานเหมือนเป็นชิปก้อนเดียว — งานนี้เกิดขึ้นในขั้นตอน packaging ทั้งหมด พูดอีกแบบคือ ความก้าวหน้าของชิปย้ายจาก “ฝั่ง front-end (ทำให้เล็กลง)” มาอยู่ “ฝั่ง back-end (ประกอบให้เก่งขึ้น)” นี่คือเหตุผลที่ขั้นตอนที่เคยน่าเบื่อกลายเป็นสนามรบใหม่
Chiplet = ชิปชิ้นเล็กที่ออกแบบมาให้ทำงานเฉพาะอย่าง (เช่น ชิ้นคำนวณ ชิ้นอินพุต-เอาต์พุต) แล้วเอาหลายชิ้นมาประกอบต่อกันในแพ็กเกจเดียวให้กลายเป็นระบบที่ทรงพลัง · ข้อดีคือผลิตง่ายกว่า (ชิ้นเล็ก yield ดีกว่า) ผสมเทคโนโลยีต่างยุคได้ และทะลุกำแพง reticle limit ได้ · ชิป AI รุ่นใหม่เกือบทั้งหมดเป็น chiplet — เช่น NVIDIA Blackwell (B200) คือชิปสองก้อนต่อกัน
และนี่คือตลาดที่ใหญ่และโตเร็ว ตลาด OSAT ทั่วโลกอยู่ที่ราว $46,000–47,000 ล้านในปี 2025 และคาดว่าจะโตไปแตะ ~$100,000 ล้านภายในปี 2035 (โตเฉลี่ย ~8% ต่อปี) แต่เครื่องยนต์ที่ร้อนแรงจริงๆ คือส่วน advanced packaging ซึ่งโตเร็วกว่ามาก — และส่วนที่ร้อนที่สุดคือกลุ่ม chiplet ที่คาดว่าจะโตจาก ~$52,000 ล้าน (2025) เป็น ~$157,000 ล้าน (2030) หรือโตเฉลี่ยถึง ~25% ต่อปี
03CoWoS ทำงานยังไง
ลองนึกถึงชิป AI หนึ่งตัวที่ขับเคลื่อน ChatGPT มันไม่ใช่ชิปก้อนเดียว แต่คือ ชิปประมวลผล (GPU) วางอยู่ตรงกลาง ล้อมรอบด้วยหน่วยความจำ HBM หลายก้อน ทั้งหมดต้องอยู่ติดกันมากที่สุด เพื่อให้ส่งข้อมูลถึงกันได้เร็วสุดขีด คำถามคือ — จะเอาชิปคนละชิ้นที่ทำมาคนละโรงงานมาวางติดกันให้คุยกันได้เป๊ะระดับนาโนเมตรยังไง?
คำตอบคือ CoWoS (Chip-on-Wafer-on-Substrate) เทคนิคของ TSMC หัวใจของมันคือแผ่นบางๆ ตรงกลางที่เรียกว่า interposer — แผ่นซิลิคอนที่ทำหน้าที่เป็น “สะพานความเร็วสูง” มีลายวงจรละเอียดยิบเชื่อม GPU กับ HBM ทุกก้อนเข้าด้วยกัน แทนที่จะเดินสายไฟยาวๆ บนแผงวงจรปกติ (ช้า) ทุกอย่างถูกวางบนสะพานซิลิคอนเดียวกัน (เร็วกว่ามหาศาล)
แล้วทำไมมันถึงทำยากจนเป็นคอขวด? เพราะ interposer ตัวมันเองก็คือชิ้นซิลิคอนที่ต้องสร้างในโรงงานระดับ foundry และการวางชิปหลายชิ้นลงบนมันให้ตรงเป๊ะทุกจุดเชื่อม (ที่มีนับหมื่นจุด) โดยห้ามมีจุดไหนพลาดเลย คืองานที่ละเอียดอ่อนสุดๆ ถ้าประกอบพลาดจุดเดียว ชิป AI ราคาหลายหมื่นดอลลาร์ทั้งก้อนก็เสีย — นี่ทำให้กำลังผลิตขยายได้ช้า และต้นทุนสูง
2.5D = วางชิปหลายชิ้น “เคียงข้างกัน” บน interposer (เช่น CoWoS — GPU กับ HBM อยู่ระนาบเดียวกัน) · 3D = “ซ้อน” ชิปทับกันในแนวตั้งแล้วเชื่อมทะลุด้วยรู TSV (เช่น SoIC ของ TSMC — เอาชิปประมวลผลซ้อนกันเลย) · 3D ให้ความหนาแน่นและความเร็วสูงกว่า แต่ทำยากกว่ามากเพราะต้องระบายความร้อนจากชิปที่ซ้อนกัน — เป็นทิศทางต่อไปของวงการ
04มันเชื่อมกับอะไรในระบบนิเวศ
node นี้คือ “จุดบรรจบ” ที่ทุกชิ้นส่วนของชิป AI มารวมกันเป็นก้อนเดียวจริงๆ มันจึงเชื่อมโยงแน่นกับทั้งพี่น้องในวงการชิปและเทรนด์ปลายทาง:
- ป้อน AI โดยตรงและร้อนแรงที่สุด: ชิป AI ทุกตัวต้องผ่านขั้นตอนนี้ — ไม่มี advanced packaging ก็ไม่มี GPU สมัยใหม่ การบูม AI ทั้งหมดวิ่งผ่านคอขวดนี้
- คู่หูกับ Memory (HBM): CoWoS มีอยู่ก็เพื่อประกอบ GPU กับ HBM เข้าด้วยกัน คอขวดของ HBM กับคอขวดของ packaging จึงพันกันแน่น — ของขาดตัวไหนก็ฉุดอีกตัว
- เส้นแบ่งกับ Foundry เริ่มเบลอ: เดิม foundry ผลิตเวเฟอร์ แล้วส่งให้ OSAT แพ็ก แต่ตอนนี้ TSMC ทำ CoWoS เองในบ้านและเก็บส่วนที่ล้ำสุด (interposer) ไว้ ทำให้ TSMC กลายเป็น OSAT ที่ใหญ่และทำกำไรที่สุดไปด้วย — OSAT ภายนอกได้แต่งาน “ล้น” ที่ TSMC ทำไม่ทัน
- นั่งบน Interconnect & substrate: ใต้ interposer ยังมี substrate ขั้นสูง (ABF substrate) ที่เป็นชิ้นส่วนสำคัญและเคยขาดตลาดมาก่อน
- เปิดทางให้ Cloud, รถยนต์ไฟฟ้า และหุ่นยนต์: ทุกเทรนด์ที่ต้องการชิปประสิทธิภาพสูง ล้วนพึ่งการแพ็กเกจขั้นสูงมากขึ้นเรื่อยๆ
05ตอนนี้ไปถึงไหนแล้ว (2025–2026)
เรื่องที่ครองข่าวทั้งปี 2025 คือ “CoWoS ขาดแคลน” ดีมานด์ชิป AI แรงเกินกว่าที่กำลังผลิต packaging จะตามทัน TSMC จึงเร่งขยายกำลังผลิต CoWoS แบบสุดตัว — จาก ~35,000 แผ่น/เดือนปลายปี 2024 เป็น ~75,000 แผ่น/เดือนในปี 2025 และตั้งเป้า 120,000–130,000 แผ่น/เดือนภายในสิ้นปี 2026 หรือเพิ่มเกือบ 4 เท่าในเวลาไม่ถึงสองปี แต่ที่น่าทึ่งคือ — แม้ขยายขนาดนี้ก็ยังไม่พอ
เหตุผลที่ยังไม่พอคือ NVIDIA จองเหมาเกือบหมด มีรายงานว่า NVIDIA จองกำลังผลิต CoWoS ของ TSMC ไปแล้ว มากกว่า 50% ของปี 2026 (บางสำนักว่าเกิน 60% เมื่อรวมปี 2025–2026) คิดเป็นราว 800,000–850,000 แผ่นสำหรับปี 2026 เพียงรายเดียว ทำให้คู่แข่งอย่าง AMD และ Broadcom ต้องแย่งกำลังผลิตที่เหลือ และระยะเวลารอคิว (lead time) ของ CoWoS ยืดออกไปเกิน 18 เดือน
และเพราะ TSMC ทำไม่ทัน งานส่วนเกินจึงไหลลงมาที่ OSAT ภายนอก ทำให้ปี 2025 เป็นปีทองของกลุ่มนี้ด้วย ในกรอบ “Foundry 2.0” ของ Counterpoint กลุ่ม OSAT โตราว 10% ในปี 2025 โดย ASE ก้าวขึ้นเป็นผู้เล่นใหญ่อันดับสองรองจาก TSMC และ Amkor ก็เซ็นสัญญาจองกำลังผลิตกับ TSMC ระยะ 10 ปีที่โรงงาน Arizona (ต.ค. 2025) เพื่อรับงานแพ็กเกจในสหรัฐฯ
ส่วนภาพรวมการแข่งขัน ลำดับยังชัดเจน: ASE คือเจ้าตลาด OSAT ภายนอกแบบทิ้งห่าง ตามด้วย Amkor และกลุ่มจีนที่กำลังมาแรงจากแรงหนุนของรัฐ:
06อนาคตข้างหน้า
ทิศทางแรกชัดเจน: มูลค่ากำลังย้ายจาก front-end มา back-end เมื่อการทำทรานซิสเตอร์ให้เล็กลงเริ่มถึงเพดาน ความก้าวหน้าของชิปต่อจากนี้จะมาจาก “วิธีประกอบ” มากขึ้นเรื่อยๆ TSMC, Samsung และ Intel ต่างทุ่มเงินหลายหมื่นล้านขยายกำลังผลิต packaging ไปจนถึงปี 2027 — เป็นครั้งแรกในประวัติศาสตร์ที่ขั้นตอน “หลังบ้าน” กลายเป็นสนามลงทุนหลัก
ทิศทางที่สองคือ การขยับจาก 2.5D ไปสู่ 3D CoWoS วันนี้คือการวางชิปเคียงข้างกัน (2.5D) แต่ก้าวต่อไปคือการ “ซ้อน” ชิปประมวลผลทับกันในแนวตั้ง (3D เช่น SoIC ของ TSMC) เพื่ออัดพลังให้มากขึ้นในพื้นที่เท่าเดิม — ทำยากกว่ามากเพราะต้องระบายความร้อนจากชิปที่ซ้อนกัน แต่นี่คือทิศทางที่ NVIDIA และ AMD กำลังมุ่งไป
ทิศทางที่สามคือ มาตรฐานกลางสำหรับ chiplet (UCIe) ถ้า chiplet จากหลายบริษัทคุยกันด้วยมาตรฐานเดียวได้ (เหมือน USB ของชิป) ตลาดจะเปิดกว้างขึ้นมาก ใครๆ ก็ผสม chiplet จากหลายเจ้ามาประกอบเป็นชิปของตัวเองได้ — ซึ่งจะยิ่งดันดีมานด์การแพ็กเกจขึ้นไปอีก และอาจกระจายอำนาจออกจากผู้เล่นรายใหญ่ไม่กี่ราย
07ความท้าทายและความเสี่ยง
เสน่ห์ของ advanced packaging มาพร้อมความเสี่ยงเฉพาะตัวที่ต้องเข้าใจ
ความเสี่ยงข้อแรกคือ การพึ่ง AI และลูกค้าน้อยรายอย่างสุดขั้ว ความรุ่งเรืองของ CoWoS วันนี้ผูกกับดีมานด์ชิป AI และลูกค้ารายเดียวเป็นหลัก (NVIDIA จองเกินครึ่ง) ถ้าการลงทุน AI ชะลอลง หรือสถาปัตยกรรมชิปเปลี่ยนไป กำลังผลิตที่เร่งขยายเกือบ 4 เท่าก็อาจกลายเป็นของล้นทันที — นี่คือธรรมชาติวัฏจักรที่ฝังอยู่ในวงการชิป
ความเสี่ยงข้อสองคือ มูลค่าส่วนใหญ่ถูกดูดขึ้นไปหา TSMC แม้ทั้ง node จะบูม แต่ขั้นตอนที่ทำกำไรสูงสุด (interposer, chip-on-wafer) TSMC เก็บไว้ทำเองในบ้าน ปล่อยแต่งานล้นและส่วนที่กำไรบางกว่า (ประกอบ substrate, ทดสอบ) ให้ OSAT ภายนอก ดังนั้น “OSAT บูม” ไม่ได้แปลว่าทุกผู้เล่นได้กำไรงามเท่ากัน — ต้องแยกให้ขาดว่าใครอยู่ส่วนล้ำสุดของห่วงโซ่
ความเสี่ยงข้อสามคือ การกระจุกตัวเชิงภูมิรัฐศาสตร์ เหมือนกับ foundry การแพ็กเกจระดับบนเกือบทั้งหมดอยู่ในไต้หวัน ความพยายามดึงกลับสหรัฐฯ (Amkor + TSMC ที่ Arizona) ยังเพิ่งเริ่ม ช้าและแพง ขณะเดียวกันจีนก็เร่งสร้าง OSAT ของตัวเอง (JCET, Tongfu) เพื่อพึ่งพาตัวเอง — ทำให้ขั้นตอนที่เคยถูกมองว่า “ไม่สำคัญ” กลายเป็นอีกหนึ่งสมรภูมิภูมิรัฐศาสตร์
ความเสี่ยงข้อสี่คือ ต้นทุนที่สูงขึ้นเรื่อยๆ advanced packaging แบบ 2.5D มีต้นทุนสูงกว่าการแพ็กแบบเดิมราว 20–30% และผู้ผลิตกำลังขึ้นราคา (ASE +5–20%, แพ็กเกจหน่วยความจำสูงถึง +30% ในปี 2026) ต้นทุนนี้สุดท้ายไหลไปอยู่ในราคาชิป AI และอุปกรณ์ — เป็นแรงกดดันเงินเฟ้อในห่วงโซ่เทคโนโลยีทั้งสาย
สรุปสั้นๆ: advanced packaging คือบทเรียนว่าในเทคโนโลยี ขั้นตอนที่เคยถูกมองข้ามที่สุด อาจกลายเป็นจุดที่สำคัญที่สุดเมื่อกฎของเกมเปลี่ยน เมื่อ Moore’s Law ช้าลง “วิธีประกอบ” ก็สำคัญพอๆ กับ “วิธีผลิต” — และการเข้าใจว่าทำไมชิป AI ตัวหนึ่งถึงต้องรอคิวแพ็กเกจนานเป็นปี คือเข้าใจว่าทำไมขั้นตอนหลังบ้านที่ไม่มีใครเคยสนใจ ถึงกลายเป็นคอขวดที่กำหนดความเร็วของยุค AI ทั้งใบ