Megatrend · Cloud & Digital Infrastructure
ที่ที่ข้อมูลของบริษัทไปอยู่ — และกลายเป็น “คูเมือง” ของยุค AI
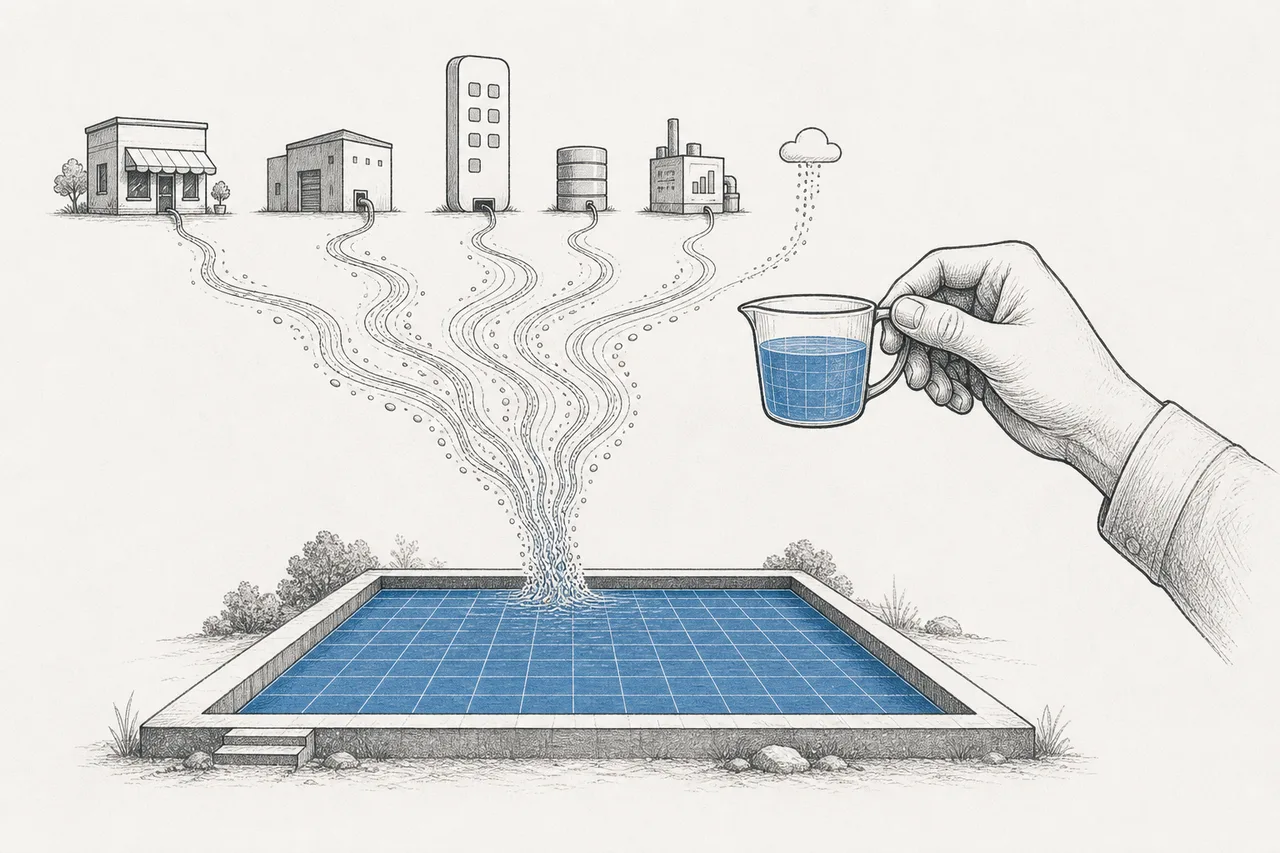
ทุกบริษัทมีข้อมูลกองมหึมา — ยอดขาย ลูกค้า สต็อก ทุก click บนเว็บ แต่ข้อมูลดิบมันเหมือนวัตถุดิบในโกดังที่ยังจัดไม่เป็นระเบียบ ใช้อะไรไม่ได้ “Data Platform” คือที่ที่ข้อมูลทั้งหมดมารวมกัน ถูกจัดระเบียบ แล้วถามคำถามได้เร็วๆ เพื่อเอาไปตัดสินใจ และตอนนี้มันสำคัญขึ้นเป็นสิบเท่า เพราะ AI จะฉลาดได้ต้องกินข้อมูลของบริษัทคุณ — ข้อมูลที่คู่แข่งไม่มี จึงกลายเป็นสมรภูมิที่ Snowflake กับ Databricks ฟัดกันด้วยมูลค่าหลักแสนล้านดอลลาร์
01มันคืออะไร (โกดังข้อมูลของบริษัท)
ลองนึกถึงบริษัทหนึ่งที่มีข้อมูลกระจัดกระจายอยู่เต็มไปหมด — ยอดขายอยู่ในระบบหนึ่ง ข้อมูลลูกค้าอยู่อีกระบบ สต็อกอยู่อีกที่ ทุก click บนแอปอยู่อีกที่ ข้อมูลแบบนี้เก็บไว้เฉยๆ ก็เหมือนวัตถุดิบกองอยู่ในโกดังที่ไม่มีชั้นวาง หยิบมาใช้ไม่ได้ Data Platform คือ “โกดังที่จัดระเบียบแล้ว” ที่รวมข้อมูลทั้งหมดมาไว้ที่เดียว แล้วถามคำถามได้ในไม่กี่วินาที — เช่น “ลูกค้าภาคเหนือซื้อสินค้าอะไรมากสุดในไตรมาสที่แล้ว?”
node นี้เป็นสาขาย่อยภายใต้เมกะเทรนด์ Cloud & Digital Infrastructure มันรวมเทคโนโลยีหลายชนิดที่ทำงานเรื่อง “ที่เก็บและที่ถามข้อมูล” ไว้ด้วยกัน หลักๆ มีอยู่สามตระกูล:
- Data Warehouse (โกดังข้อมูลแบบจัดระเบียบ): เก็บข้อมูลที่จัดเป็นตารางเรียบร้อย (structured) เพื่อทำรายงานและวิเคราะห์ — เหมือนตู้เอกสารที่ติดป้ายทุกลิ้นชัก หาเร็ว แต่ของต้องจัดให้เข้าที่ก่อน หัวใจของฝั่งนี้คือ Snowflake
- Data Lake / Lakehouse (ทะเลสาบข้อมูล): ทุ่มเก็บข้อมูล “ดิบ” ทุกชนิด — ทั้งตาราง รูป ข้อความ log — แบบราคาถูกๆ ก่อน แล้วค่อยจัดทีหลัง ส่วน “Lakehouse” คือเวอร์ชันที่ผสมข้อดีของทะเลสาบ (ถูก ยืดหยุ่น) กับโกดัง (ถามเร็ว เชื่อถือได้) เข้าด้วยกัน — สนามของ Databricks
- Operational / NoSQL Database (ฐานข้อมูลที่ขับเคลื่อนแอป): ฐานข้อมูลที่อยู่ “หลังแอป” คอยรับ-ส่งข้อมูลแบบเรียลไทม์ทุกครั้งที่คุณกดปุ่ม เช่น MongoDB — ต่างจากสองตระกูลบนที่เน้น “วิเคราะห์” ตระกูลนี้เน้น “ใช้งานสด”
โลกฐานข้อมูลแบ่งงานเป็นสองแบบ · OLTP (operational) = งาน “สด” ทีละรายการ เช่นบันทึกออเดอร์ตอนคุณกดซื้อ — ต้องเร็วและถูกต้องเป๊ะ (MongoDB, Postgres) · OLAP (analytical) = งาน “วิเคราะห์” กวาดข้อมูลเป็นล้านแถวเพื่อหาภาพรวม เช่นสรุปยอดขายทั้งปี (Snowflake, Databricks) นี่คือเหตุผลที่บริษัทต้องมีหลายระบบ ไม่ใช่อันเดียวจบ
02ทำไมถึงสำคัญ — มันคือรากฐานใต้ทั้ง BI และ AI
เป็นสิบๆ ปีที่ Data Platform ถูกมองว่าเป็นเรื่อง “หลังบ้าน” น่าเบื่อ — แค่ที่เก็บข้อมูลไว้ทำรายงาน (เรื่องที่เรียกว่า BI / Business Intelligence: เปลี่ยนข้อมูลดิบให้เป็นกราฟและตัวเลขที่ผู้บริหารดูแล้วตัดสินใจได้) แต่แล้ว AI ก็เปลี่ยนเกมทั้งใบ เพราะมีความจริงข้อหนึ่งที่ทุกบริษัทเพิ่งตื่นมาเข้าใจ:
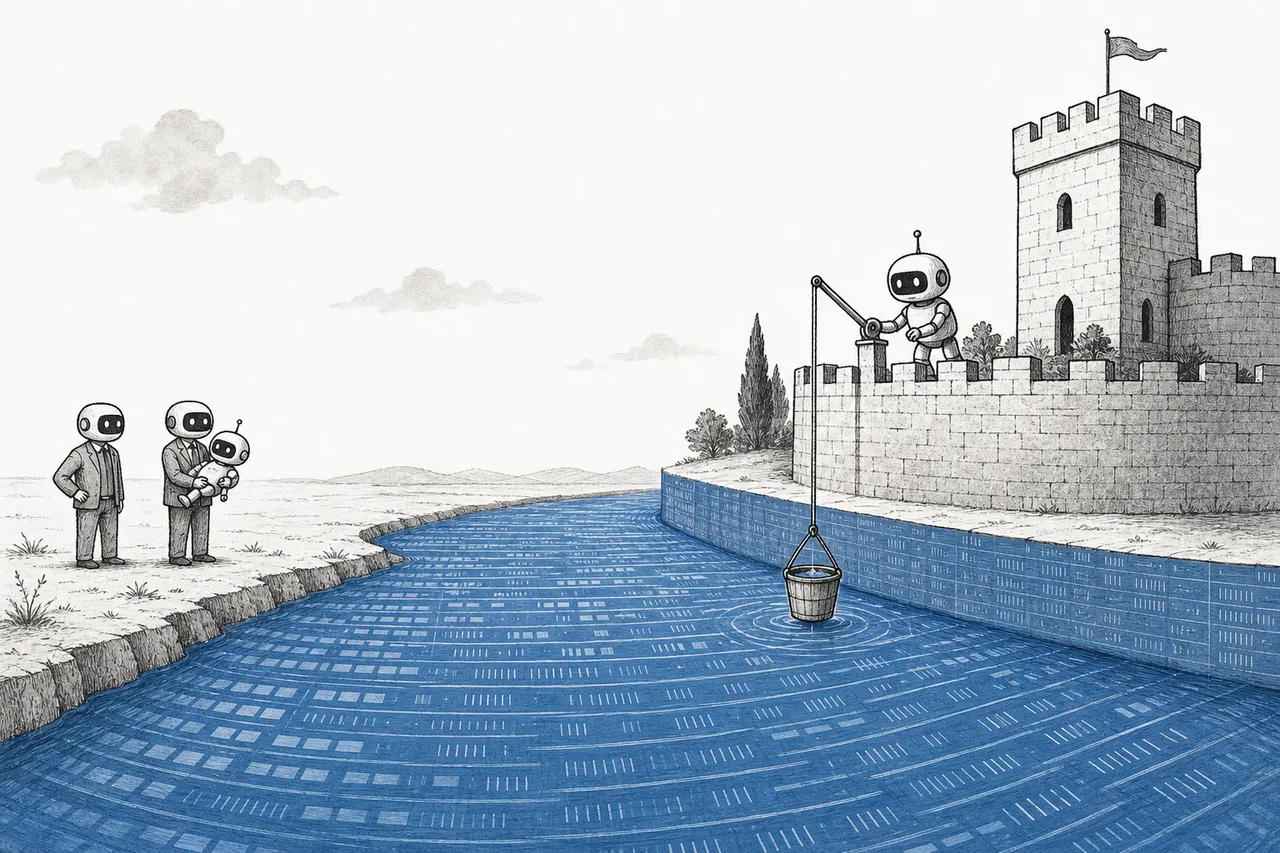
นี่คือเหตุผลที่ Data Platform กลายเป็น “คูเมือง (moat)” ของยุค AI ถ้าจะให้ AI ตอบคำถามเกี่ยวกับ ธุรกิจของคุณ ได้จริง — ไม่ใช่ความรู้ทั่วไป — มันต้องเข้าถึงข้อมูลของคุณอย่างเป็นระเบียบ และข้อมูลนั้นอยู่ที่ Data Platform ดังนั้นใครคุมแพลตฟอร์มข้อมูลของลูกค้า ก็เท่ากับยืนอยู่ตรงประตูทางเข้าของยุค AI ทั้งหมด นี่จึงเป็นสนามที่เงินไหลเข้ามหาศาล
และเงินที่ไหลเข้านี้ส่วนใหญ่ถูกผลักด้วย AI โดยตรง — Gartner ประเมินว่าตลาด “ข้อมูลสำหรับ AI” โดยเฉพาะจะ โตเกินเท่าตัวจาก $3.1B เป็น $6.4B ภายในปี 2027 ขณะที่งบ IT รวมทั้งโลกปี 2026 ทะลุ $6.15 ล้านล้านดอลลาร์ โดยมี AI เป็นตัวขับหลัก เมื่อบริษัทอยากใช้ AI ก็ต้องลงทุนกับ “ที่เก็บข้อมูลให้ AI กิน” ก่อนเสมอ
03มันทำงานยังไง — ท่อข้อมูล + ความลับชื่อ “แยก storage กับ compute”
หัวใจของ Data Platform สมัยใหม่คือ “ท่อข้อมูล (data pipeline)” ที่มีสี่ขั้นตอน ลองนึกตามเป็นโรงงานแปรรูป: ข้อมูลดิบเข้ามา → ถูกเก็บ → ถูกจัดระเบียบ → แล้วถูกถามคำถาม
แต่ความลับที่ทำให้แพลตฟอร์มยุคนี้ปฏิวัติวงการคือไอเดียง่ายๆ ชื่อ “แยกชั้นเก็บข้อมูล (storage) ออกจากชั้นคำนวณ (compute)” ในยุคเก่า ที่เก็บข้อมูลกับเครื่องที่ใช้ประมวลผลถูกมัดติดกัน อยากถามคำถามใหญ่ขึ้นก็ต้องซื้อเครื่องใหญ่ขึ้นทั้งก้อน แพงและไม่ยืดหยุ่น
Snowflake เป็นเจ้าแรกที่ “แยกสองชั้นนี้ออกจากกัน” ในระบบคลาวด์ ทำให้คุณเก็บข้อมูลไว้ถูกๆ ที่ชั้นล่าง แล้ว “เปิดเครื่องคิดเลข” ขึ้นมาเฉพาะตอนจะถามคำถาม — ถามเสร็จก็ปิด ไม่เสียเงิน และถ้าคำถามใหญ่มากก็เปิดเครื่องหลายตัวพร้อมกัน เหมือนเปิดน้ำเปิดไฟตามใช้จริง ไอเดียนี้พ่วงมากับโมเดลคิดเงินที่เรียกว่า consumption pricing — จ่ายตามที่ใช้จริง (ไม่ใช่ค่าสมาชิกรายเดือนตายตัว) ซึ่งเป็นทั้งจุดแข็งและจุดอ่อนของธุรกิจนี้ (เดี๋ยวเล่าในบทความเสี่ยง)
Lakehouse = สถาปัตยกรรมที่รวมทะเลสาบข้อมูล (เก็บดิบ ถูก ยืดหยุ่น) กับโกดัง (ถามเร็ว เชื่อถือได้) ไว้ในที่เดียว · ทำได้เพราะ open table format อย่าง Apache Iceberg และ Delta Lake — มาตรฐานเปิดที่เพิ่ม “ความเป็นระเบียบ” (ธุรกรรมเชื่อถือได้ ย้อนเวลาได้) ให้กับไฟล์ดิบราคาถูกในคลาวด์ ผลคือข้อมูลก้อนเดียวให้หลาย engine มาอ่านได้ ไม่ต้องก็อปซ้ำ — นี่คือเหตุผลที่ฝั่งโกดัง (Snowflake) กับฝั่งทะเลสาบ (Databricks) ค่อยๆ กลายเป็นเหมือนกันขึ้นเรื่อยๆ
04มันอยู่ตรงไหนใน Cloud
Data Platform เป็นหนึ่งใน “ชั้น” ของเมกะเทรนด์ Cloud & Digital Infrastructure ถ้านึกภาพคลาวด์เป็นตึก แต่ละชั้นทำหน้าที่ต่างกัน:
- นั่งบน Hyperscale Cloud (IaaS/PaaS): Snowflake กับ Databricks ไม่ได้สร้างศูนย์ข้อมูลเอง — พวกเขา “เช่า” เครื่องและพื้นที่เก็บข้อมูลจาก AWS, Azure, Google Cloud อีกที แล้วสร้างความฉลาดวางทับ นี่คือชั้นที่อยู่ ใต้ เรา
- ป้อน Artificial Intelligence เป็นเชื้อเพลิง: นี่คือความสัมพันธ์ที่สำคัญที่สุด — AI ฉลาดได้เพราะกินข้อมูลที่จัดระเบียบจาก Data Platform โดยเฉพาะงานเตรียมและฝึกข้อมูลที่เชื่อมตรงไปยัง AI Tooling & MLOps และในที่สุดก็ไปเลี้ยง Foundation Models ให้ตอบเรื่องของธุรกิจคุณได้
- คู่กับ Cybersecurity & Digital Trust: เมื่อข้อมูลทั้งบริษัทมากองที่เดียว มันก็กลายเป็นเป้าใหญ่ที่สุด — การกำกับดูแล (governance) ว่าใครเข้าถึงข้อมูลอะไรได้ จึงเป็นส่วนหนึ่งของแพลตฟอร์มข้อมูลที่ขาดไม่ได้
จุดที่ต่างจากเพื่อนบ้านในชั้นเดียวกัน: Observability & DevOps เฝ้าดูว่า “ระบบยังทำงานดีไหม” ส่วนเราเก็บ “ข้อมูลธุรกิจ” เพื่อตอบคำถามเชิงกลยุทธ์ และต่างจาก Enterprise Data Storage Systems ที่ขาย “ฮาร์ดแวร์ที่เก็บข้อมูล” — เราขาย “ซอฟต์แวร์ที่ทำให้ข้อมูลถูกถามได้”
05ตอนนี้ไปถึงไหน — สงคราม Snowflake vs Databricks
เรื่องราวใหญ่ที่สุดของ node นี้ในปี 2026 คือศึกระหว่างสองยักษ์ที่เริ่มจากคนละมุม แต่ตอนนี้ชนกันกลางสนาม
Snowflake (SNOW) มาจากฝั่ง “โกดัง” — เริ่มจากการเป็นคลังข้อมูลบนคลาวด์ที่ใช้ง่ายที่สุด ปีงบ 2026 ทำรายได้ผลิตภัณฑ์ $4.47B โต 29% และมีตัวเลขที่นักลงทุนซอฟต์แวร์รักมากชื่อ net revenue retention 125% — แปลว่าลูกค้าเก่าโดยเฉลี่ยใช้จ่ายเพิ่มขึ้น 25% ทุกปีโดยไม่ต้องหาลูกค้าใหม่ มูลค่าบริษัทราว $85B (กลางปี 2026)
Databricks มาจากฝั่ง “ทะเลสาบ” และเป็นคู่ปรับตัวจริง — แต่ ยังไม่ได้เข้าตลาดหุ้น มันโตเร็วกว่าด้วยซ้ำ: รายได้ต่อปีแตะ $5.4B โต 65% ต้นปี 2026 โดยมีส่วนที่เป็น AI โดยตรงราว $1.4B (~26% ของรายได้) และระดมทุนรอบล่าสุดที่มูลค่า $134B ปลายปี 2025 — สูงกว่ามูลค่าตลาดของ Snowflake เสียอีก ทั้งที่ยังเป็นบริษัทเอกชน
ทำไมสองค่ายนี้ถึงชนกันได้ ทั้งที่เริ่มคนละจุด? เพราะต่างฝ่ายต่างบุกเข้าไปในจุดแข็งของอีกฝ่าย Snowflake เพิ่มความสามารถจัดการข้อมูลดิบและ AI (รองรับ open format อย่าง Iceberg เต็มตัว) ส่วน Databricks ก็พัฒนาให้ถามคำถามแบบโกดังได้เร็วขึ้น — สุดท้ายทั้งคู่กลายเป็น “lakehouse + AI platform” ที่หน้าตาคล้ายกันขึ้นเรื่อยๆ และแย่งลูกค้ารายเดียวกัน
แต่สนามนี้ไม่ได้มีแค่สองค่าย ยังมีผู้เล่นเฉพาะทางที่แข็งแกร่งในมุมของตัวเอง — และยักษ์คลาวด์ที่ลงมาเล่นเองด้วย
นอกจากนี้ยังมีดาวรุ่งสายโอเพนซอร์สที่กำลังกัดกินตลาดจากด้านล่าง — ClickHouse (วิเคราะห์เร็วจัด รายได้ ~$160M โตกว่า 250% ระดมทุนที่มูลค่า $15B ต้นปี 2026) และ DuckDB (เครื่องวิเคราะห์จิ๋วที่รันในเครื่องตัวเอง ดาวน์โหลด ~37 ล้านครั้ง/เดือน) ทั้งคู่สะท้อนว่าสนามนี้ยังเปิดให้ผู้ท้าชิงเทคโนโลยีใหม่เข้ามาเสมอ
06อนาคตข้างหน้า
ทิศทางแรกคือ “ข้อมูลกลายเป็นที่ AI ทำงานจริง” ไม่ใช่แค่ที่เก็บอีกต่อไป ทั้ง Snowflake และ Databricks เปิดตัวเครื่องมือให้สร้าง “AI agent” ที่ทำงานบนข้อมูลของลูกค้าได้โดยตรง — ถามเป็นภาษาคนแล้วได้คำตอบจากข้อมูลบริษัท แนวคิด “แพลตฟอร์มข้อมูล = แพลตฟอร์ม AI” จะยิ่งชัดขึ้น และนี่คือเหตุผลที่ทั้งคู่ยอมทุ่มซื้อบริษัท AI เข้าพอร์ต
ทิศทางที่สองคือ ชัยชนะของ “มาตรฐานเปิด” (open table format) Apache Iceberg กำลังกลายเป็นมาตรฐานกลางที่ทุกค่ายต้องรองรับ ผลคือลูกค้าจะ “ผูกติด” กับเจ้าใดเจ้าหนึ่งน้อยลง เพราะข้อมูลก้อนเดียวเปิดให้หลาย engine มาอ่านได้ — ดีต่อลูกค้า แต่บีบให้ผู้ขายต้องแข่งกันที่ “ความฉลาด” มากกว่าการกักข้อมูลไว้
ทิศทางที่สามคือ การรวมศูนย์ (consolidation) บริษัทเบื่อกับการมีเครื่องมือข้อมูลกระจัดกระจาย 10 อย่าง — Microsoft Fabric เดิมพันกับเทรนด์นี้ตรงๆ โดยชูว่ารวมทุกอย่างไว้ที่เดียวช่วยลดงบข้อมูลได้ 30–45% เทรนด์นี้เป็นทั้งโอกาส (แพลตฟอร์มที่ครบจบในตัวจะชนะ) และภัยคุกคาม (ยักษ์คลาวด์ที่มีทุกชั้นอยู่แล้วได้เปรียบ)
07ความท้าทายและความเสี่ยง
เสน่ห์ของธุรกิจนี้มาพร้อมความเสี่ยงที่ฝังอยู่ในโมเดลธุรกิจของมันเอง
ความเสี่ยงข้อแรกคือ ดาบสองคมของ consumption pricing การคิดเงินตามที่ใช้จริงทำให้รายได้พุ่งแรงตอนลูกค้าใช้เยอะ — แต่ก็แปลว่ารายได้ “เหวี่ยง” ตามการใช้งานของลูกค้าด้วย เวลาเศรษฐกิจชะลอ ลูกค้าก็รัดเข็มขัด “ปรับลดการ query” เพื่อประหยัด ทำให้รายได้ของผู้ขายผันผวนคาดเดายากกว่าโมเดลค่าสมาชิกตายตัว นี่เป็นเหตุผลหนึ่งที่หุ้นกลุ่มนี้สวิงแรงเวลาตลาดกังวลเรื่องการใช้จ่าย
ความเสี่ยงข้อสองคือ การแข่งขันจากยักษ์คลาวด์เจ้าของบ้าน Snowflake และ Databricks ต่างเช่าเครื่องจาก AWS/Azure/Google — แต่ทั้งสามเจ้านี้ก็มีผลิตภัณฑ์ข้อมูลของตัวเอง (เช่น Microsoft Fabric, Google BigQuery) ที่ขายพ่วงกับคลาวด์ได้เลย การแข่งกับ “เจ้าของแพลตฟอร์มที่ตัวเองยืนอยู่บนนั้น” คือความเสี่ยงเชิงโครงสร้างที่หนีไม่พ้น
ความเสี่ยงข้อสามคือ มาตรฐานเปิดลดอำนาจกักลูกค้า เมื่อ open table format ทำให้ย้ายข้อมูลข้ามค่ายได้ง่ายขึ้น “คูเมือง” ที่เคยมาจากการ lock ข้อมูลไว้ก็ตื้นลง ผู้ขายต้องแข่งกันที่ฟีเจอร์และราคามากขึ้น ซึ่งกดดันมาร์จิ้นในระยะยาว บวกกับดาวรุ่งโอเพนซอร์ส (ClickHouse, DuckDB) ที่ไล่กัดตลาดเฉพาะทางจากด้านล่าง
สรุปสั้นๆ: Data Platform เคยเป็นเรื่องหลังบ้านน่าเบื่อ แต่กลายเป็นหนึ่งในสนามที่สำคัญที่สุดของยุค AI เพราะความจริงข้อเดียว — โมเดล AI ใครๆ ก็ซื้อได้ แต่ข้อมูลของบริษัทคุณคู่แข่งไม่มี ดังนั้นใครคุม “ที่ที่ข้อมูลไปอยู่” ก็คุมคูเมืองที่ลึกที่สุดของยุคนี้ และนั่นคือเหตุผลที่ Snowflake กับ Databricks ฟัดกันด้วยเดิมพันหลักแสนล้านดอลลาร์