メガトレンド · Cloud & Digital Infrastructure
会社のデータが「行き着く場所」——そしてAI時代の“堀”になる
どの会社にも膨大なデータが眠っています——売上、顧客、在庫、ウェブ上のすべてのclick。でも生のデータは、まだ整理されていない倉庫の原材料のようなもので、そのままでは何にも使えません。「Data Platform」とは、そのすべてのデータが一か所に集まり、整理され、すぐに問いを投げて意思決定に使える場所のこと。そしていま、その重要度は10倍に跳ね上がっています。AIが賢くなるには、あなたの会社のデータ——競合が持っていないデータ——を食べる必要があるからです。だからこそここは、Snowflake と Databricks が数千億ドル規模で激突する主戦場になりました。
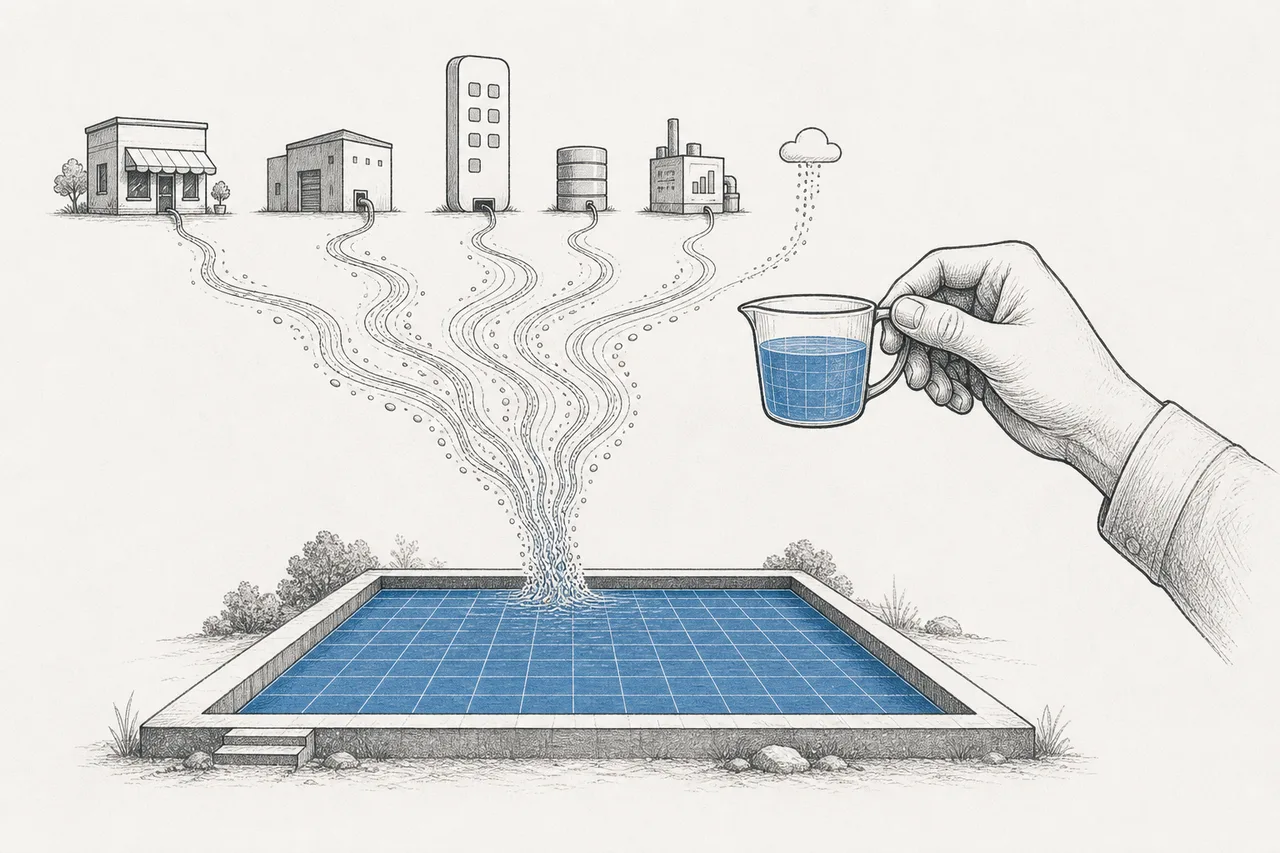
01これは何?(会社のデータ倉庫)
あるひとつの会社を思い浮かべてください。データがあちこちに散らばっています——売上はあるシステムに、顧客情報は別のシステムに、在庫はまた別の場所に、アプリ上のすべてのclickはさらに別の場所に。こういうデータは、ただ置いてあるだけだと、棚のない倉庫に積み上がった原材料と同じで、取り出して使えません。Data Platform とは「整理された倉庫」のこと。すべてのデータを一か所に集め、数秒で問いを投げられます——たとえば「先期、北部地域の顧客がいちばん多く買った商品は?」のように。
この node は、メガトレンド Cloud & Digital Infrastructure の下にあるサブテーマです。「データを置く場所」と「データに問う場所」をめぐる複数の技術をひとまとめにしたもので、大きく三つの系統があります:
- Data Warehouse(整理されたデータ倉庫): きれいに表へ整えたデータ(structured)を保管し、レポートや分析に使う——引き出し一つひとつにラベルを貼った書類棚のように、探すのは速いが、先にきちんと片づけておく必要がある。この系統の主役が Snowflake
- Data Lake / Lakehouse(データの湖): あらゆる「生」のデータ——表も画像もテキストも log も——をまず安く溜め込み、整理は後回しにする。「Lakehouse」は、湖の長所(安い・柔軟)と倉庫の長所(速く問える・信頼できる)を一つに混ぜたバージョンで、Databricks の主戦場
- Operational / NoSQL Database(アプリを動かすデータベース): アプリの「裏」にいて、ボタンを押すたびにリアルタイムでデータをやり取りするデータベース。たとえば MongoDB——「分析」に寄った上の二系統とは違い、この系統は「いま使う」ことに振っている
データベースの世界は、仕事を二つに分けています · OLTP(operational)= 一件ずつの「いま」の処理。たとえば買うボタンを押した瞬間に注文を記録する——速くて正確であることが命(MongoDB、Postgres)· OLAP(analytical)= 数百万行を一気になめて全体像を出す「分析」の処理。たとえば年間の売上を集計する(Snowflake、Databricks)。これが、会社が一つで済ませず複数のシステムを持つ理由です。
02なぜ重要か——BIとAI、その両方の土台だから
何十年ものあいだ、Data Platform は「裏方」の退屈な存在と見られてきました——レポートを作るためにデータを置いておくだけの場所(これを BI / Business Intelligence と呼びます:生のデータを、経営者が見て判断できるグラフや数字に変える仕事)。ところがAIが、ゲームを丸ごと変えました。どの会社もいま、ようやく目を覚まして気づいた事実があるのです:
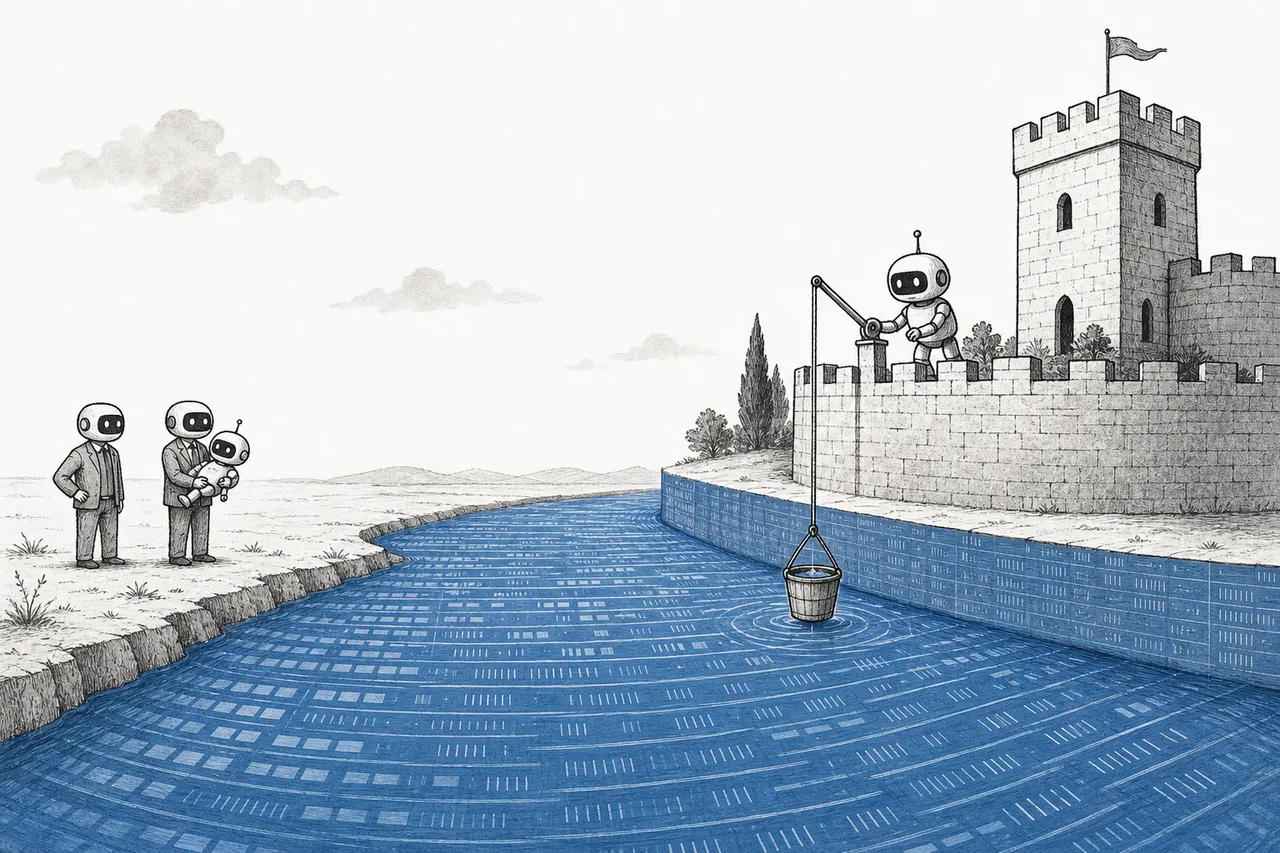
これが、Data Platform がAI時代の「堀(moat)」になった理由です。AIにあなたのビジネスについての問い——一般知識ではなく——にちゃんと答えさせたいなら、AIはあなたのデータへ整然とアクセスできなければならない。そしてそのデータは Data Platform にあります。だから、顧客のデータプラットフォームを握る者は、AI時代まるごとの入り口に立っているのと同じ。ここに莫大なお金が流れ込むのは、そのためなんです。
そして流れ込むお金の多くは、AIが直接押し上げているもの——Gartner は「AI向けデータ」市場だけで 2027年までに $3.1B から $6.4B へと倍増する と見ています。一方、2026年の世界IT支出はAIを主役に $6.15兆ドルを突破。会社がAIを使おうとすれば、いつでもまず「AIに食べさせるデータの置き場」へ投資することになるのです。
03どう動くのか——データの“パイプ”と、「storage と compute を分ける」という秘密
現代の Data Platform の核は、四つの工程からなる「データの“パイプ”(data pipeline)」です。加工工場をイメージしてください:生のデータが入ってくる → 溜める → 整理する → 問いを投げる。
でも、いまのプラットフォームを“革命的”にしている秘密は、とてもシンプルなアイデアです——「データを溜める層(storage)を、計算する層(compute)から切り離す」。昔は、データの置き場と処理するマシンが固く結びついていました。大きな問いを投げたければ、丸ごと大きなマシンを買うしかない——高くつくし、柔軟でもありません。
Snowflake は、この二つの層をクラウド上で「分けた」最初の会社です。おかげで、データは下の層に安く溜めておき、問いを投げるときだけ「計算機の電源を入れる」——終わったら切れば、お金はかからない。大きな問いなら計算機を何台も同時に立ち上げればいい、まるで使う分だけ水道や電気を開け閉めするように。このアイデアには、consumption pricing——使った分だけ払うという課金モデル(毎月定額の会費ではない)がセットでついてきます。これがこの事業の強みでもあり、弱みでもあるんです(リスクの章でまた触れます)。
Lakehouse = データの湖(生で安く柔軟に溜める)と倉庫(速く問える・信頼できる)を一か所にまとめた構成 · これが可能なのは open table format、たとえば Apache Iceberg や Delta Lake のおかげ——クラウド上の安い生ファイルに「整然さ」(信頼できるトランザクション、時間を巻き戻せる機能)を足す、オープンな標準です。結果として、一つのデータを複数の engine が読みに来られ、コピーを重ねずに済む——これが、倉庫側(Snowflake)と湖側(Databricks)がだんだん似てきている理由なんです。
04Cloud のどこに位置するのか
Data Platform は、メガトレンド Cloud & Digital Infrastructure の「層」のひとつです。クラウドをビルだと思うと、各階で役割が違います:
- Hyperscale Cloud(IaaS/PaaS) の上に乗る: Snowflake も Databricks も自前のデータセンターは作らない——マシンとデータの置き場を AWS、Azure、Google Cloud から「借りて」、その上に賢さを重ねる。これは私たちの 下 にある層
- Artificial Intelligence に燃料を供給する: これがいちばん大事な関係——AIが賢くなれるのは、Data Platform から整理されたデータを食べるから。とくにデータの準備と訓練の工程は AI Tooling & MLOps に直結し、最終的には Foundation Models を養って、あなたのビジネスのことを答えられるようにする
- Cybersecurity & Digital Trust と対になる: 全社のデータが一か所に集まれば、それは最大の標的にもなる——誰がどのデータにアクセスできるかを管理すること(governance)は、データプラットフォームに欠かせない一部です
同じ層の隣人との違い:Observability & DevOps は「システムがちゃんと動いているか」を見張る一方、私たちは戦略的な問いに答えるために「ビジネスのデータ」を溜める。また Enterprise Data Storage Systems が「データを保管するハードウェア」を売るのに対し、私たちは「データを問えるようにするソフトウェア」を売っています。
05いま、どこまで来たのか——Snowflake vs Databricks の戦争
この node の2026年いちばん大きな物語は、別々の角から始まった二大巨人が、いまや戦場の真ん中で激突している話です。
Snowflake(SNOW) は「倉庫」側の出身——いちばん使いやすいクラウド上のデータ倉庫として始まりました。2026会計年度の製品売上は $4.47B で29%増、そしてソフトウェア投資家が大好きな指標 net revenue retention 125% を持っています——既存顧客が平均して毎年25%ずつ支出を増やしている、新規を取らなくても、という意味です。時価総額は約 $85B(2026年半ば)。
Databricks は「湖」側の出身で、本物の好敵手——ただし まだ上場していません。むしろ伸びはこちらの方が速い:年間売上は2026年初に $5.4B で65%増 に達し、そのうちAI直結が約 $1.4B(売上の約26%)。直近の資金調達は $134B の評価額(2025年末)——非公開企業のままなのに、Snowflake の時価総額をも上回っています。
なぜこの二陣営は、別の地点から始まったのに激突するのか? 互いが相手の強みへ攻め込んでいるからです。Snowflake は生データとAIを扱う力を足し(open format の Iceberg を本格対応)、Databricks は倉庫のように速く問える力を磨いた——結果、両者は見た目のよく似た「lakehouse + AI platform」になり、同じ顧客を取り合っています。
でも、この戦場には二陣営しかいないわけではありません。自分の角で強い専門特化のプレーヤーや、自ら降りてきたクラウドの巨人もいます。
さらに、下から市場を食い始めているオープンソースの新星もいます——ClickHouse(分析が超高速。売上 ~$160M で250%超の成長、2026年初に $15B の評価額で資金調達)と DuckDB(自分のマシン上で動く極小の分析エンジン。月間ダウンロード ~3,700万回)。どちらも、この戦場が常に新技術の挑戦者へ開かれていることを物語ります。
06これからの展開
第一の方向は 「データが、AIが実際に働く場所になる」 こと——もう単なる置き場ではありません。Snowflake も Databricks も、顧客のデータの上で直接動く「AI agent」を作れるツールを発表しました——人の言葉で問えば、会社のデータから答えが返ってくる。「データプラットフォーム=AIプラットフォーム」という考えはますますはっきりするでしょう。だからこそ両者は、AI企業を惜しみなく買収してポートフォリオに入れているのです。
第二の方向は 「オープンな標準(open table format)」の勝利。Apache Iceberg は、どの陣営も対応せざるを得ない共通標準になりつつあります。結果、一つのデータを複数の engine が読めるようになり、顧客が特定の一社へ「ロックイン」されにくくなる——顧客には良いが、売り手はデータを囲い込むのではなく「賢さ」で競うよう追い込まれます。
第三の方向は 集約(consolidation)。会社はバラバラなデータツールを10個も抱えることにうんざりしています——Microsoft Fabric はこのトレンドにそのまま賭け、すべてを一か所にまとめればデータ予算を30〜45%削れると訴えます。このトレンドはチャンス(全部入りのプラットフォームが勝つ)であると同時に、脅威(全層をすでに持つクラウドの巨人が有利)でもあります。
07課題とリスク
この事業の魅力には、ビジネスモデルそのものに埋め込まれたリスクがついてきます。
第一のリスクは consumption pricing の諸刃の剣。使った分だけ課金するので、顧客がたくさん使えば売上は跳ね上がる——でも、それは顧客の使い方しだいで売上が「振れる」という意味でもあります。景気が鈍ると顧客はベルトを締め、節約のために「query を減らす」。すると売上は、定額の会費モデルより読みにくく変動します。市場が支出を不安視するとこのグループの株が大きくスイングするのは、これが一因です。
第二のリスクは 大家であるクラウドの巨人との競争。Snowflake も Databricks も AWS/Azure/Google からマシンを借りている——でも、その三社自身も自前のデータ製品(たとえば Microsoft Fabric、Google BigQuery)を持ち、クラウドにセットで売れてしまう。「自分が立っているプラットフォームの持ち主」と競うのは、逃れられない構造的リスクです。
第三のリスクは オープンな標準が顧客の囲い込み力を弱めること。open table format でデータを陣営間で移しやすくなると、データを lock することで生まれていた「堀」が浅くなる。売り手は機能と価格でより激しく競わざるを得ず、長期的にはマージンを圧迫します。そこに、専門特化の市場を下から食うオープンソースの新星(ClickHouse、DuckDB)も加わります。
ひとことで:Data Platform はかつて退屈な裏方の話でした。でもいまは、AI時代でもっとも重要な戦場のひとつです。理由はたった一つ——AIモデルは誰でも買えるが、あなたの会社のデータは競合が持っていない。だから「データが行き着く場所」を握る者が、この時代でいちばん深い堀を握るのです。それが、Snowflake と Databricks が数千億ドルを賭けて激突している理由です。