メガトレンド · Robotics & Physical AI
ロボットの体はとっくにあった——足りなかったのは「脳」
ロボットアーム、モーター、精密な手——これらは何十年も前から私たちの手にありました。でもロボットは、囲いの中で「ぴったり書き込まれたプログラム」どおりの作業しかできず、置き場所が少しずれただけでもう続けられない。このnodeは、その「脳のソフトウェア」の話です——カメラの映像と人間の言葉の指示を受け取り、自分で筋肉(モーター)を動かせるAIモデル。ずっと欠けていたピースであり、ロボットを「工場の機械」から「何でもこなす作業員」へと変わらせない、ほぼ一世紀ものあいだ立ちはだかってきたボトルネックです。
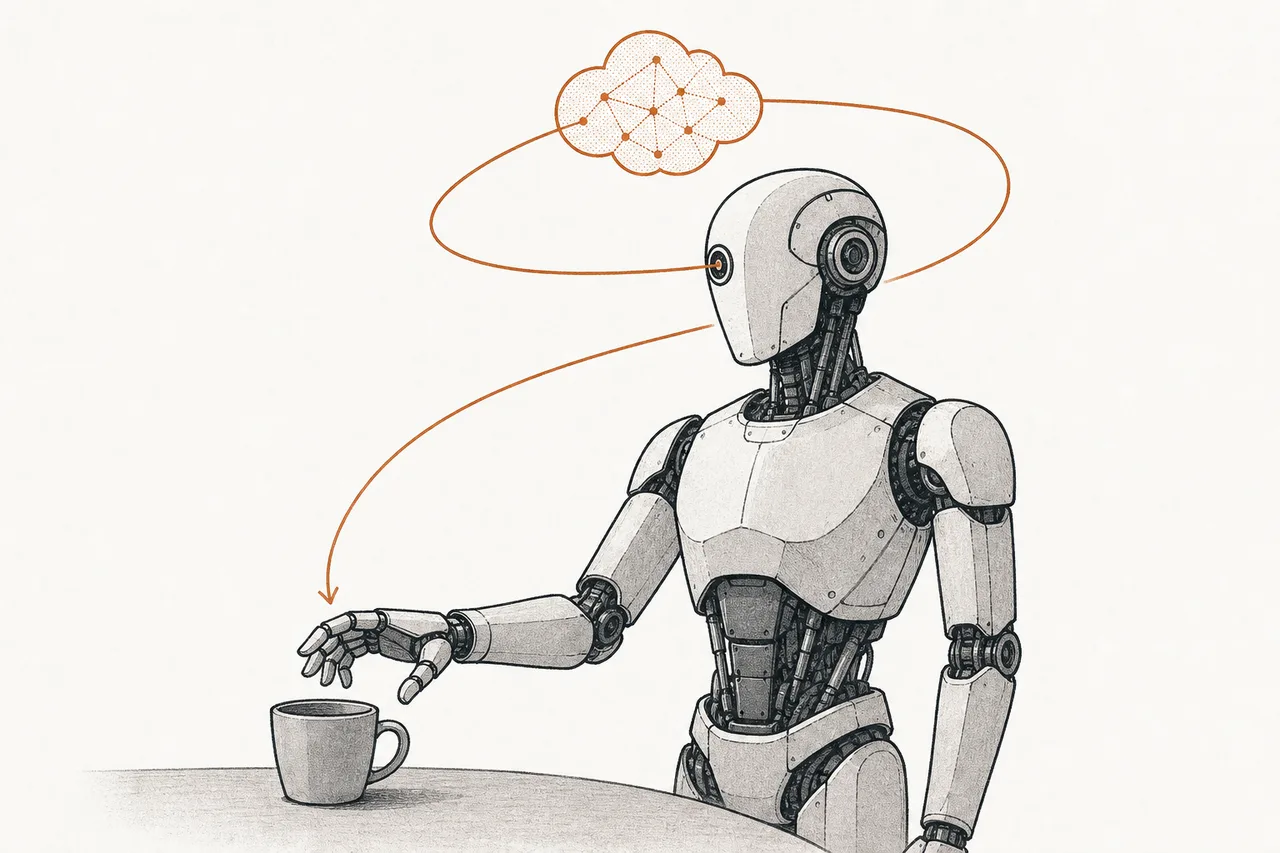
01これは何? — ロボットの「脳」
自動車工場のロボットアームを思い浮かべてください。同じ一点を百万回でもミスなく溶接できる。でも、加工物をたった2センチずらして置くと、平然と何もない空中に溶接してしまう。何かを「見て」いるわけでも「理解して」いるわけでもなく、人間がミリ単位で書いた座標どおりに動いているだけだからです。これが過去60年のロボット——繰り返しは得意でも、現実の世界にはまるで無力でした。
このnodeは、まさにそこを解くソフトウェアの話です——業界が 「Physical AI」、つまり体を持ったAI と呼ぶもの。その心臓部にあるのが VLA(Vision-Language-Action) という新しいタイプのモデルです。かみくだいて言えば、カメラの映像(Vision)と「シンクの皿を食洗機に入れて」のような 人間の言葉の指示(Language)を受け取り、それを直接 筋肉やモーターを動かす指令(Action)へと変換するモデル——誰かが一点ずつ座標を書く必要はありません。
VLA(Vision-Language-Action) = ChatGPTの裏にあるような大規模な言語・画像モデルを土台に、三本目の「足」を足したもの——つまり出力が 物理的な動作 になる · Robot foundation model(ロボット向け基盤モデル) = 作業ごとに別々のプログラムを書く代わりに、幅広く訓練することで多くの作業・多くのロボットをこなせる一つのモデル——どんな体に差しても使える「万能の脳」のようなもの。
メガトレンドの地図では、このnodeは Robotics & Physical AI のサブテーマで、「プラットフォーム」層に位置します。その定義は「ロボット向けの基盤モデル/VLA、シミュレーション、そして機体上の処理プラットフォーム」とずばり言い切っています。言い換えると——ヒューマノイド や 部品とモーター が「体」なら、このnodeはその体を役立つものにする「脳と神経系」なんです。
02なぜ「脳」が体を解き放つのか
ちょっと意外だけど、とても大事な事実があります:ロボットの体は、一度もボトルネックではなかった。私たちは何十年も前から、ある面では人間の手より器用なロボットハンド、モーター、センサーを作ってきました。ずっと引っかかっていたのは「では、それをきっちりしていない世界の中でどう動かすか」です。現実の世界は雑然としていて、物は決まった場所にないし、光は変わり、人が通り過ぎる——すべての場合をプログラムで書き尽くすのは不可能。だからほとんどのロボットは、いまも工場の囲いの中に閉じ込められているのです。
VLAはこの方程式を変えます。一手ずつ命令されるのではなく、「物理的な常識」を学ぶからです。そしてその熱気は、資金の動きにもはっきり表れています。2025年、ロボットのスタートアップが集めた資金は約 138億ドル——ピークだった2021年の記録を上回りました。広い定義(ロボット+physical AI)で数えれば、その額は1,000件超のディールで約 276億ドル に達します。その大半が流れ込んだのは「体」ではなく「脳」のほうでした。
なぜここまでお金が集まるのか? 賭けの対象が 「物理的な労働」 だからです——つかむ、組み立てる、運ぶ、介護する、と現実の世界で手を使う仕事。これまでの AIの波(agentic AI) は画面の中でしか動けず、ここにはまだ届いていませんでした。もし「ロボットの脳」が本当に働けば、知識労働だけでなく世界中の労働市場への扉が開く——だからこそ投資家は、先に席を押さえるために高い値段を払うのです。
03どう動くのか — 「体を持つことのループ」
Physical AIの心臓部にあるのは、「知覚 → 思考 → 行動」をぐるぐると、1秒間に何十回も回し続けるループです——現実の世界は止まってくれないから。物はすべるし、手は外すし、抵抗は変わる。ロボットは一度計画して突っ走るのではなく、絶えず調整し続けなければなりません。これを 「embodiment loop」、つまり体を持つことのループ と呼びます。
いちばん賢く——そしていちばん難しい——のが、真ん中の箱(VLAモデル)です。これは「インターネットを世界中ぶん読んできた」ような大規模な言語・画像モデルを土台にしているので、教える前から常識を備えています。たとえば「満杯のコップは立てて持つ」「割れやすい物はそっとつかむ」を、わざわざ教えなくても知っている。そのうえで、ロボットの実際の動きのデータでさらに訓練し、「理解を動きに変換する」力を身につけさせる——これが「世界を知る脳」と「働ける手」をつなぐ橋なんです。
ところが問題は、ロボットの実際の動きのデータが 驚くほど手に入りにくい こと。だから主な解決策が、図のいちばん上の箱になります——ロボットに シミュレーションの世界で訓練(simulation) を何百万回もさせてから、その技を現実へ持ち越す。この方法を 「sim-to-real」 と呼び、これは丸ごと次の章にする価値があるほど重要です。
04いちばん大きな問題:データ不足
これは「なぜAIは詩を人間より上手に書けるのに、ロボットはまだ服をたためないのか」を説明する核心です。短い答えは データ。ChatGPTのような言語モデルは、ネット上のテキストや画像から訓練されますが、それを「経験」に換算すると約 10万年分 の中身に相当します。いっぽう、これまで報告されている最大のロボット実動作データセットでさえ、せいぜい 「1年」 ぶん——その差は10万倍です。
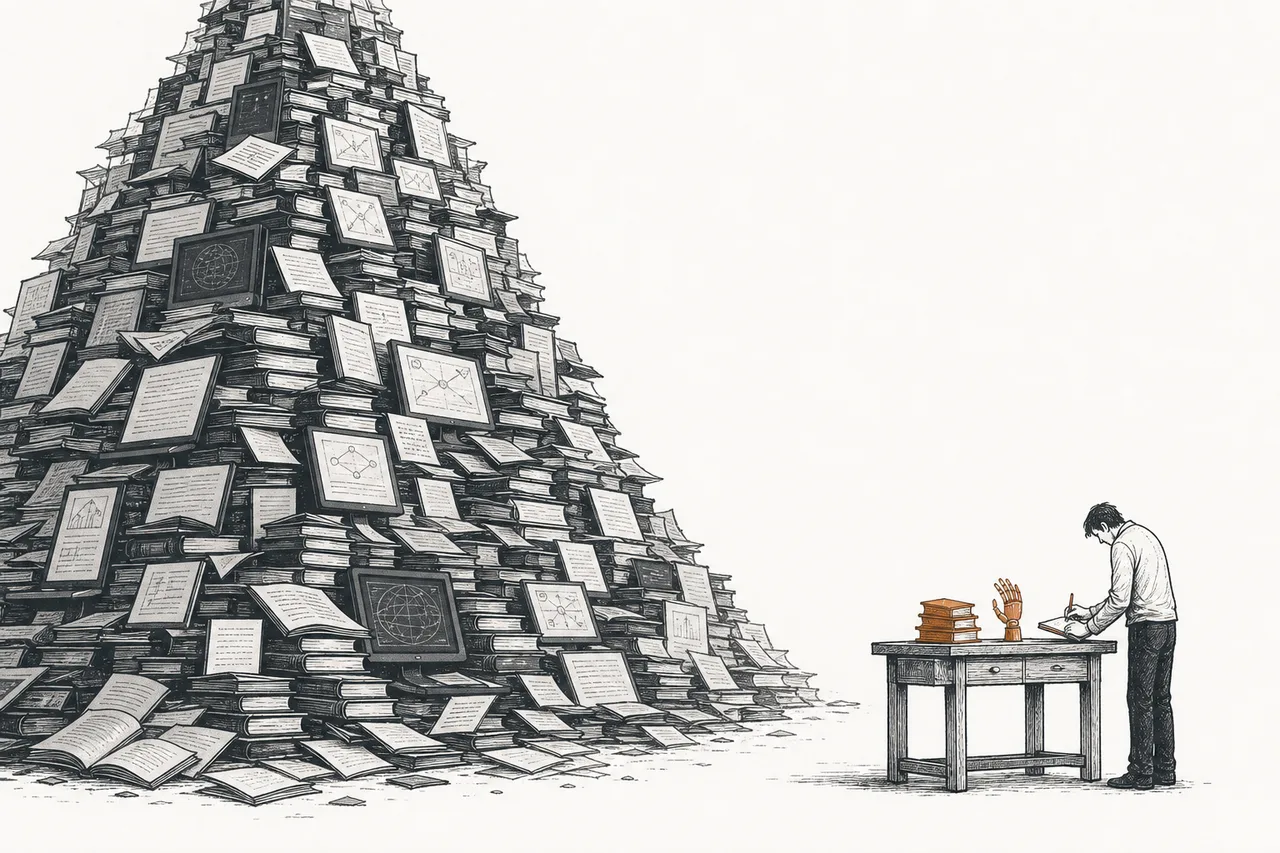
なぜこれほど桁違いの差になるのか? テキストはネット上に すでに存在 し、タダで吸い上げられます。でもロボットのデータは 「ネットからスクレイプできない」——「コップを1回つかむ」データが欲しいたびに、本物のロボットと本物の環境を用意し、人が横についてロボットを操作(teleoperation)して一回ずつ見せなければならない。遅く、高く、スケールしない。だから研究者はこれを「10万年のデータギャップ」と呼ぶのです。
業界全体が賭ける解決策が 「シミュレーションの世界(simulation)」 です——本物のロボットを壊すことなく、数時間で何百万回も訓練できる仮想世界を作る。訓練を終えたら、学んだ「脳」を本物のロボットへ移す。こうして、足りない実データを、桁違いに安い合成データで埋め合わせるのです。
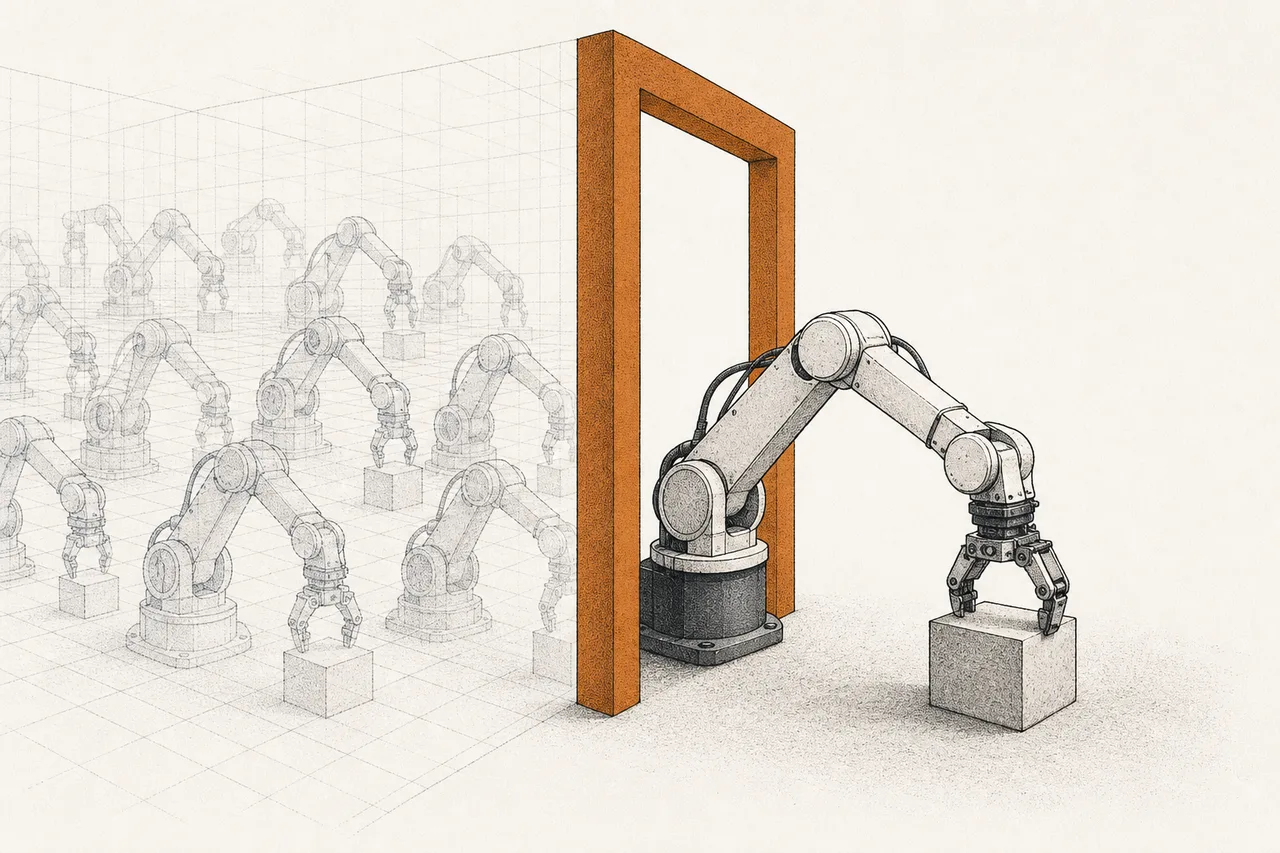
シミュレーションの世界が本物とぴったり同じになることはありません——摩擦、たわむ素材、すべる物は、どれも再現が難しい。ゲームの中では上手だったロボットが現実に出ると、技がしばしば「外れる」。これが sim-to-real gap です。2025年の研究はおおまかに、シミュレーションのデータ約8サンプルが、実データ1サンプルぶんに相当する と見積もっています——シミュレーションは大きな助けですが、タダではなく、「接触の物理」のギャップはいまも最も難しい関門です。
だからこそ このnode は「モデル」だけでなく「シミュレーションのプラットフォーム」までを定義に含めています——いちばんリアルな合成データの工場を握る者が、この業界でいちばん希少な原料を握ることになるからです。
05Roboticsのどこに位置するのか
このnodeをいちばん簡単に理解するには、ロボットを一つの「生き物」と見て、どの部品がどこにあたるかを尋ねてみるといい:
- Robotics & Physical AIの「脳と神経系」: 親テーマはロボットというシステム全体。このnodeは、その体がスクリプトに従うだけでなく、自分で考えて判断できるようにするソフトウェアの層です
- ヒューマノイド や 部品&モーター(actuation) という「体」に命令する: どんなに優れたハードウェアも、命じる脳がなければ無価値——逆に、賢い脳も、十分に精密な手がなければ何もできない。両方がそろって初めて働く
- AI と Foundation Models(基盤モデル) の上に立つ: VLAはゼロから生まれたのではなく、言語・画像の基盤モデルに「足を生やして」命令できるようにしたもの。だからAI全体の実力が、そのままロボットの実力の天井になる
- AIチップ を、訓練でも機体上の思考でも大量に食う: ロボットは動きながらリアルタイムで考えねばならず、機体上で動く(onboard inference)強力かつ低消費電力のチップを必要とする
そしてこのnodeはAIの「現実世界の手足」であるがゆえに、ロボット業界の外へも広く手を伸ばします——高齢化社会(介護の人手不足)に直接効きますし、サプライチェーンではモーターや磁石といった 重要な原材料 にも頼っています。
06いま、どこまで来たか + 主役は誰か
2025〜2026年は、Physical AIが研究から「本物のプラットフォーム」へ飛び移った時期です。大きな起爆剤が Nvidia——自らロボットを作る代わりに、誰もが使える一式のプラットフォームを揃えて、この業界の「つるはし売り」に回りました。2025年3月、Nvidiaは「世界初のオープンなヒューマノイド基盤モデル」と謳う Isaac GR00T N1 を発表。シミュレーションの世界と合成データを作る Omniverse + Cosmos、そして機体上で考えるためのチップ Jetson Thor とセットで打ち出しました。
それが本当に「共通の標準」になりつつある証拠が、FANUC、ABB、KUKA、Yaskawa といった大手の産業用ロボットメーカー——世界中で合わせて 200万台超 を設置——が、OmniverseのライブラリとNvidiaのシミュレーション基盤を採り入れ、実機を作る前に「デジタルツイン」で生産ラインを試すようになったことです。後続のモデル(GR00T N1.7、そしてプレビューされたGR00T N2)は、新しい環境での成功率が従来の最先端VLAモデルの約2倍だと謳っています。
いっぽう「モデル専業のラボ」側も激しく競い合っています。Google DeepMind は Gemini Robotics 1.5 を出し、「やる前に考え」、訓練し直さずに別種のロボットへ技を移せる。スタートアップはとりわけ熱く——Physical Intelligence(πモデル)は2025年11月に56億ドルと評価され、新ラウンドで評価額が 110億ドル を超えるという協議が報じられています。Skild AI はシリーズCで14億ドルを集め、評価額を7か月で3倍の 140億ドル に押し上げました。出資にはSoftBank、Nvidia、Samsungが名を連ねています。
投資家にとって大事な注意点:モデル専業の層で「先頭」を走るプレーヤーは、ほぼすべてが株式市場にいない非公開企業 です(Physical Intelligence、Skild AI、Helixモデルを手がけるFigure)。だからこのトレンドへ株式市場から投資する道は、「ロボットのモデルそのものを作る本命」を直接買うというより、「プラットフォームとチップの売り手」(Nvidiaのような)や、ロボットチームを抱える大企業(Google、Tesla、Baiduのような)を通すことが多くなります。
07これからの展開
第一の方向は 「world model」(世界モデル) という考え方です——ロボットがその場しのぎで反応するのではなく、「世界はどう動くか」の模型を頭の中に作り、「こうしたら何が起きるか」を前もって想像する。重い物を持ち上げる前に絵を思い浮かべる人のように。NvidiaがプレビューしたGR00T N2(「world action model」アーキテクチャ)のような新世代はこの道を進んでいます——そしてこれこそ、ロボットが「一度も見たことのない状況」に対処できるようになる鍵です。
第二の方向は 「データ工場」が主戦場になる こと。実データが希少なら、高品質の合成データを最も多く最も安く作れる者が(シミュレーションの世界+人間の動画を通じて)構造的な優位を握ります——だからこそOmniverse/Cosmosのようなシミュレーションのプラットフォームは、モデルそのものと同じくらいの価値を持ちうるのです。
第三の方向は 「クラウド上の脳」と「機体上の脳」の落としどころ です。重い思考(計画)はクラウドに置き、ミリ秒単位の速さが要る仕事(バランスを取る、障害物をよける)は機体上で考えなければならない。この二つの層を、機体上の限られた電力とチップの予算の中で、なめらかに協調させる設計こそ、次のラウンドの大きな工学的課題です。
08課題 & リスク
巨大な熱気と資金の裏で、Physical AIには率直に語るべき壁があります。最初の壁は、もう話したとおり——データ不足。実データの収集が、いまだに人がロボットを一回ずつ操作することを要し、シミュレーションの世界がまだ「十分にリアルでない」(sim-to-real gap)かぎり、「きれいなデモ動画」から「どの家でもどの工場でも働く」への道のりは、熱気が思うより遅くなります。
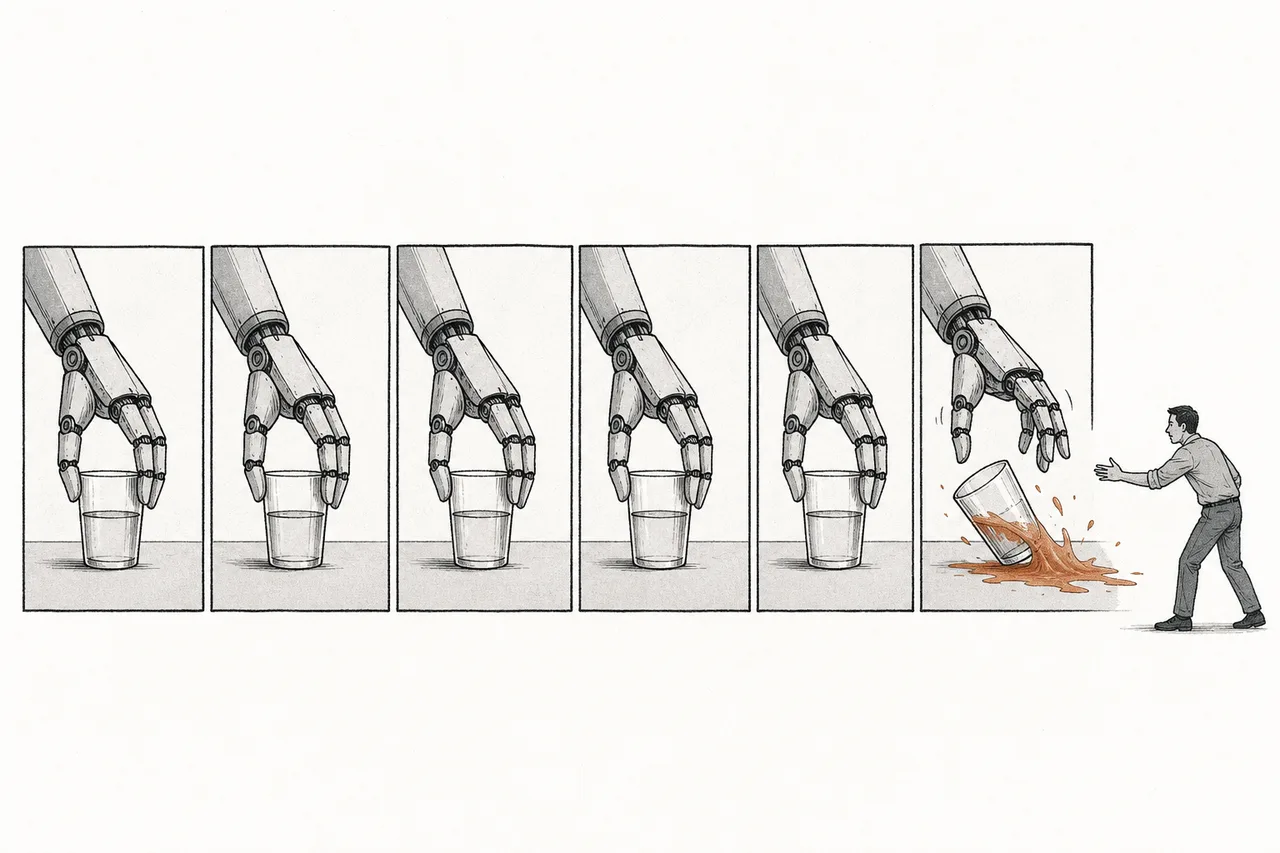
第二のリスクは 「信頼性」 です。AIのソフトウェアの世界では95%正しければ十分すごい。でも物理の世界で95%は「20回に1回、物を落とすか壊す」ということで、現実の仕事では許されません。物理的な行為は 取り返しがつかない から——コップは割れたきり、人のけがは本物のけが。「上手」から「毎回信頼できる」へ登るこの区間こそ、いちばん難しく、いちばん時間がかかります。
第三のリスクは 「投資しにくく、しかも高い評価額」 です。モデル層の本命の多くは、いまも評価額が猛烈に上がる非公開企業(Skild AIは7か月で3倍、Physical Intelligenceは56億ドルから110億ドルへ)——「期待が現実を先走る」トレンドの典型です。もし本当の進歩が約束より遅ければ、この一群の評価額の調整は激しくなりうる。
ひとことで言えば:ロボットの体はとっくに揃っていて、最近ようやく来たのが、世界を理解して自分で動けるようにする「脳」です——そして本当のボトルネックはハードウェアではなく、手に入りにくいデータと、まだ届かない信頼性。この二つを先に解いた者が——よりリアルなシミュレーションの世界で解くにせよ、物理をより深く理解するモデルで解くにせよ——ロボットが工場の囲いを出て私たちの暮らしに入ってくる速さを決めることになります。