Megatrend · Artificial Intelligence
การ์ด AI ที่แพงที่สุดในโลก ก็ยังต้องนั่งรอ “แรม” ป้อนข้อมูล
เราชอบคิดว่าหัวใจของ AI คือ GPU ที่ประมวลผลเร็วสุดขั้ว แต่ความจริงที่วงการรู้กันดีคือ — GPU เก่งเกินไปจนหน่วยความจำตามไม่ทัน ชิปคำนวณได้เร็วขึ้น 80 เท่าใน 10 ปี แต่ความเร็วในการป้อนข้อมูลโตแค่ 17 เท่า ผลคือแกนประมวลผลมูลค่าหลายแสนบาทมักนั่ง “ว่างงาน” รอข้อมูล นี่คือ กำแพงหน่วยความจำ (the memory wall) และพระเอกที่มาทลายมันคือ HBM — แรมความเร็วสูงที่เอา DRAM มาซ้อนเป็นตึกแล้วแปะติดข้าง GPU ของจริง บทเรียนนี้พาไปดูว่าทำไมของชิ้นนี้ถึง “ขายหมดล่วงหน้าหลายปี” และทำไมทั้งโลกพึ่งผู้ผลิตแค่ 3 ราย
01มันคืออะไร
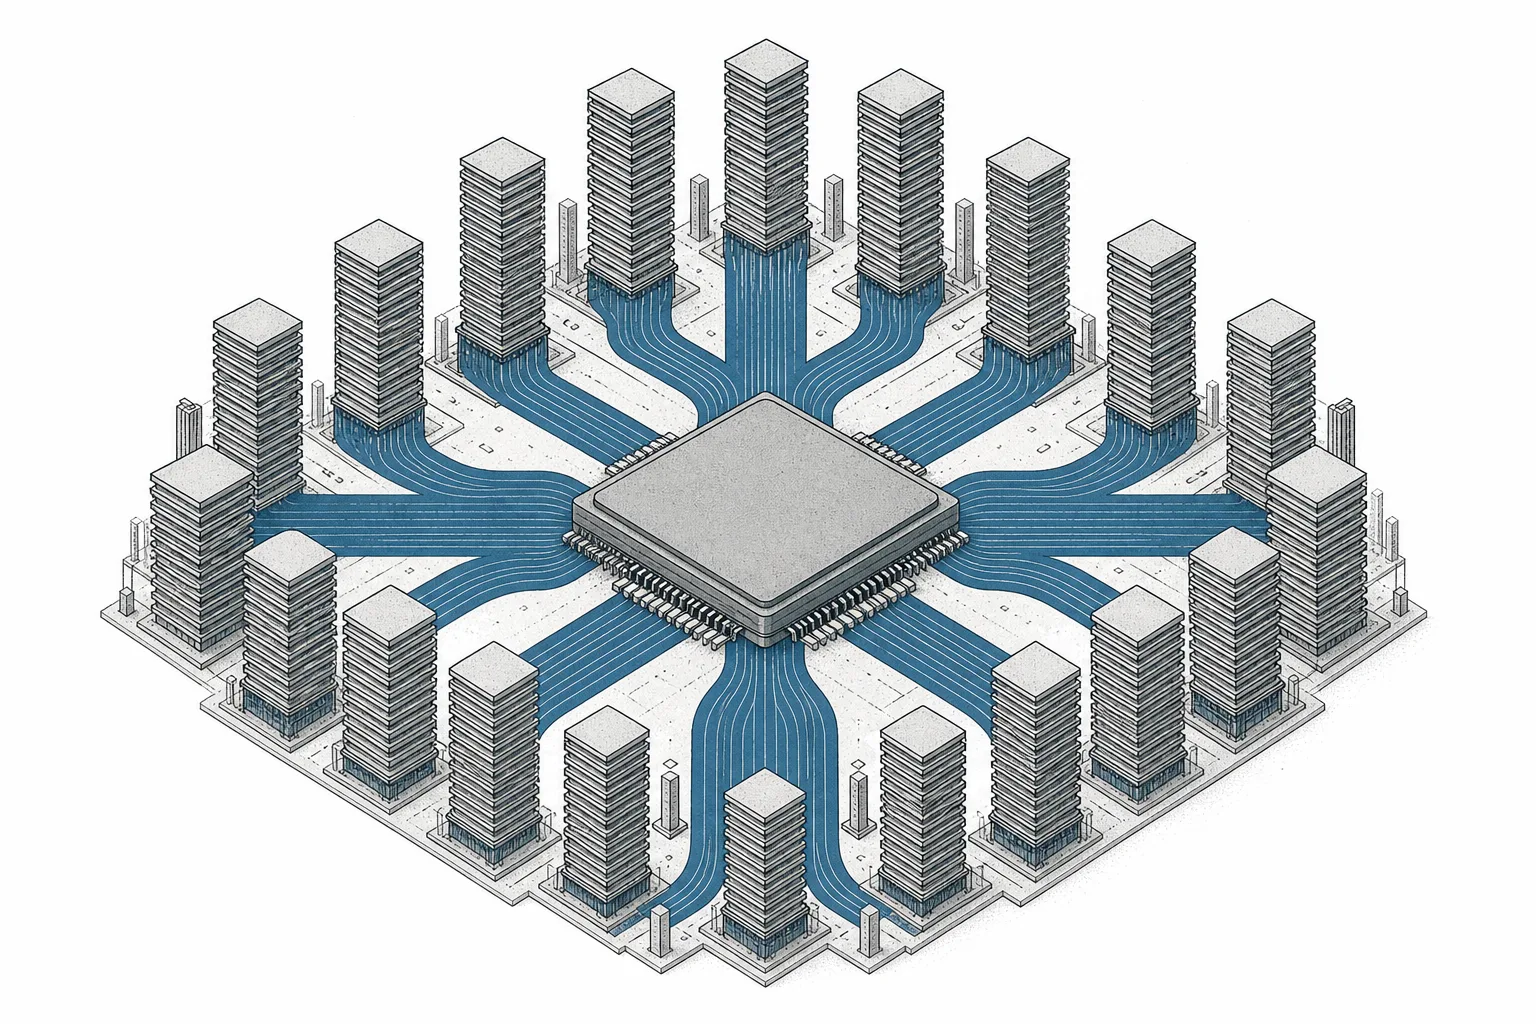
เวลาเราพูดถึงพลังของ AI เรามักนึกถึง GPU ที่คำนวณเร็วสุดขีด แต่ลองคิดดูดีๆ — ชิปที่คิดเร็วแค่ไหนก็ไม่มีประโยชน์ ถ้า “ข้อมูล” ที่จะให้มันคิดมาถึงไม่ทัน เหมือนเชฟฝีมือเทพที่ทำอาหารได้เร็วมาก แต่ถ้าคนยกวัตถุดิบมาให้ช้า เชฟก็ต้องยืนรอ HBM (High-Bandwidth Memory) เกิดมาเพื่อแก้ปัญหานี้โดยตรง — มันคือ หน่วยความจำความเร็วสูงพิเศษ ที่เอา DRAM หลายชั้นมาซ้อนกันเป็นตึกแล้วแปะติดอยู่ข้าง GPU เพื่อยกวัตถุดิบ (ข้อมูล) ให้แกนประมวลผลเร็วที่สุดเท่าที่เป็นไปได้
หัวใจของมันมีแค่สองคำ: “ซ้อน” กับ “กว้าง” แทนที่จะวางชิป DRAM เรียงแบนๆ บนเมนบอร์ดเหมือนแรมคอมพิวเตอร์ทั่วไป HBM เอาแผ่น DRAM มาซ้อนทับกัน 8–16 ชั้นเป็นเสาตึก แล้วเจาะรูเชื่อมไฟฟ้าทะลุทุกชั้น จากนั้นวางเสานี้ไว้ติดกับ GPU เลย เชื่อมกันด้วย “ทางด่วน” ที่กว้างมหาศาล ผลคือข้อมูลวิ่งจากแรมเข้าสู่ชิปได้เร็วกว่าแรมธรรมดาหลายสิบเท่า
ในแผนผังเมกะเทรนด์ node นี้เป็นสาขาย่อย (leaf) ภายใต้ AI Compute & Accelerator Silicon ในเทรนด์ใหญ่ Artificial Intelligence มันยืนเคียงข้างพี่น้องอย่าง GPU & Merchant Accelerators (ตัวที่คิด) และ Advanced Packaging & Test (OSAT) (คนที่ประกอบ GPU กับ HBM เข้าด้วยกัน) — ถ้า GPU คือสมอง HBM ก็คือ ความจำระยะสั้นที่อยู่ติดสมอง ที่ทำให้สมองคิดได้โดยไม่ต้องหยุดรอ
Bandwidth (แบนด์วิดท์) = ปริมาณข้อมูลที่ส่งได้ต่อวินาที — วัดเป็น GB/s หรือ TB/s ยิ่งมากยิ่งป้อนข้อมูลได้เร็ว · DRAM = ชิปหน่วยความจำหลักที่ใช้เก็บข้อมูลระหว่างทำงาน (แรมในคอมก็คือ DRAM) · HBM = เอา DRAM หลายแผ่นมาซ้อนเป็นตึกแล้วต่อด้วยบัสกว้างพิเศษ เพื่อให้ได้แบนด์วิดท์สูงสุดในพื้นที่เล็กที่สุด — มันคือ DRAM ชนิดหนึ่ง แต่จัดเรียงมาเพื่อความเร็วโดยเฉพาะ
02ทำไมถึงสำคัญ — กำแพงหน่วยความจำ
มีปรากฏการณ์หนึ่งที่หลอกหลอนวงการชิปมาหลายปี เรียกว่า “กำแพงหน่วยความจำ” (the memory wall) เรื่องของเรื่องคือ — พลังประมวลผลของ GPU โตเร็วกว่าความเร็วของหน่วยความจำมาก ตัวเลขที่มักถูกอ้างคือ ระหว่างปี 2012–2022 พลังคำนวณ (FLOPS) ของ GPU Nvidia เพิ่มขึ้นราว 80 เท่า แต่แบนด์วิดท์หน่วยความจำเพิ่มขึ้นแค่ราว 17 เท่า ช่องว่างนี้ถ่างกว้างขึ้นทุกปี จนหน่วยความจำกลายเป็น “คอขวด” อันดับหนึ่ง — แกนประมวลผลที่แพงที่สุดในการ์ดมักนั่งรอข้อมูลแทนที่จะคิด
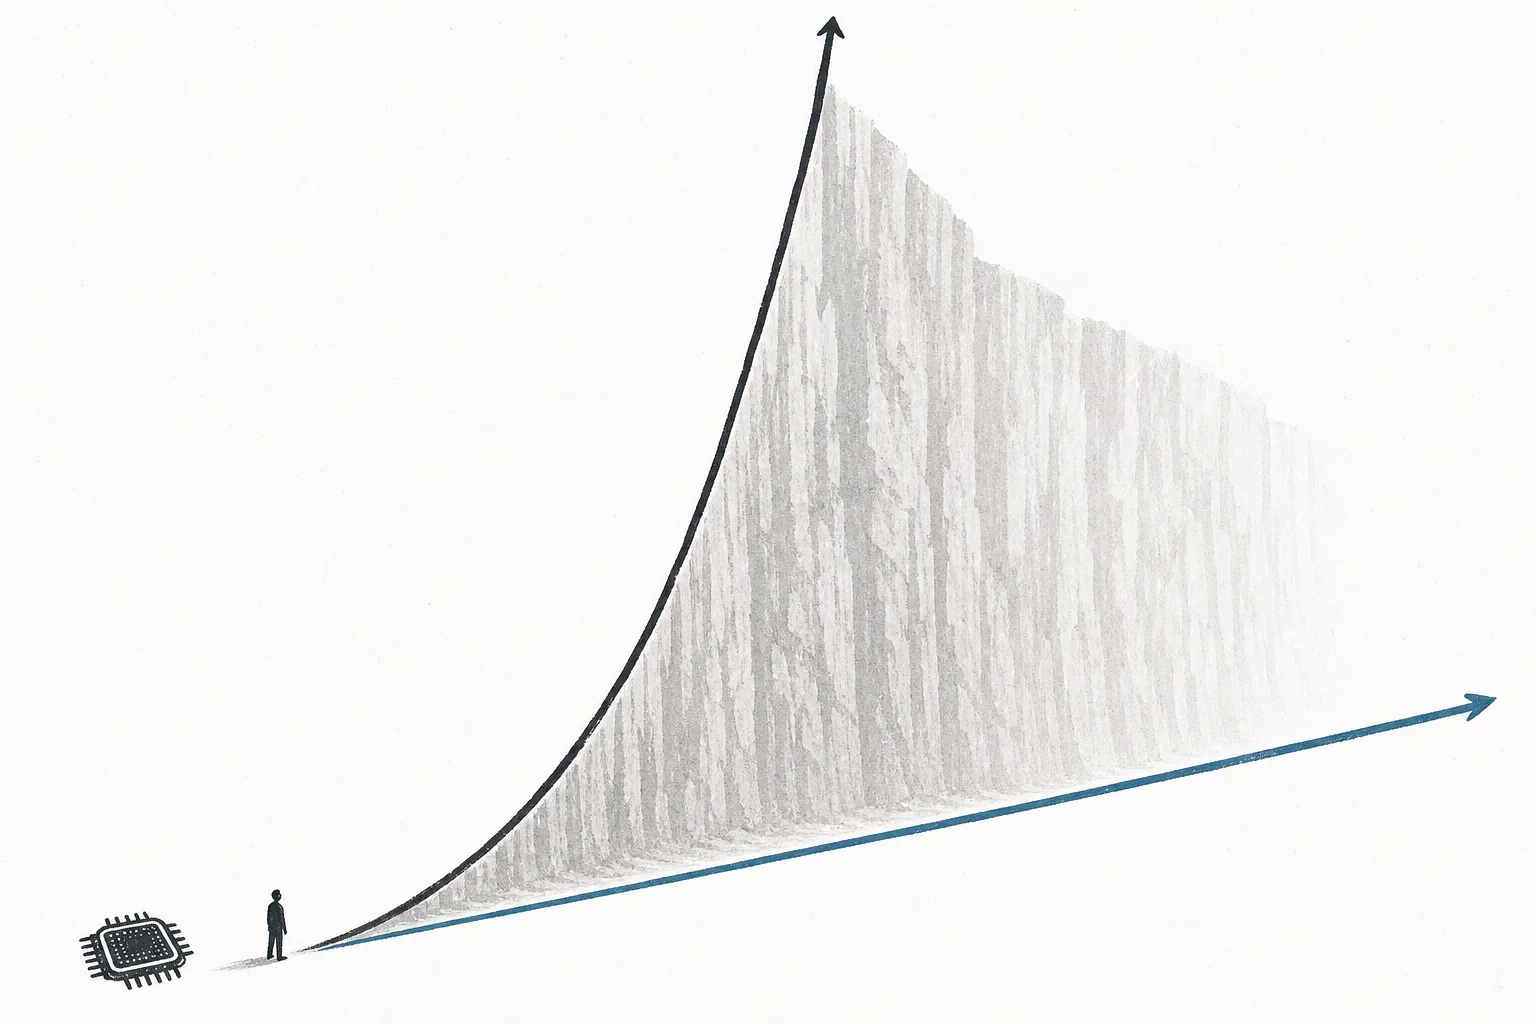
เรื่องนี้ยิ่งรุนแรงในงาน AI สมัยใหม่ โดยเฉพาะ การรันโมเดลภาษาขนาดใหญ่ (LLM) เพราะทุกครั้งที่โมเดลตอบคำถาม มันต้องอ่านค่าพารามิเตอร์นับแสนล้านตัวจากหน่วยความจำ งานแบบนี้ “กิน” แบนด์วิดท์มากกว่ากินพลังคำนวณ — ความเร็วในการตอบของ ChatGPT จึงถูกกำหนดโดย ความเร็วของแรม มากกว่าความเร็วของแกนคิด HBM คือสิ่งเดียวที่ป้อนข้อมูลได้ทันความหิวของ GPU จึงไม่ใช่ของเสริม แต่เป็นชิ้นส่วนที่ขาดไม่ได้
ขนาดของตลาดสะท้อนความสำคัญนี้ชัดเจน จากที่เคยเป็นแค่หน่วยความจำเฉพาะทางมูลค่าหลักพันล้าน ตลาด HBM พุ่งขึ้นเป็นราว $35,000 ล้าน ในปี 2025 และหลายสำนักประเมินว่าจะแตะระดับ $100,000 ล้านภายในปี 2028 — เติบโตเฉลี่ยราว 40% ต่อปี เป็นหนึ่งในตลาดชิปที่โตเร็วที่สุดในประวัติศาสตร์
03มันทำงานยังไง (ซ้อน DRAM เป็นตึก)
กลเม็ดของ HBM คือ เปลี่ยนทิศทางจาก “เรียงแนวราบ” เป็น “ซ้อนแนวตั้ง” แรมในคอมพิวเตอร์ทั่วไปเสียบเรียงกันบนเมนบอร์ด แล้วคุยกับชิปผ่านสายแคบๆ (DDR5 กว้าง 64 บิตต่อช่อง) แต่ HBM ทำสามอย่างที่ต่างออกไป — ซ้อนแผ่น DRAM เป็นตึก, เจาะรูเชื่อมทะลุทุกชั้น, แล้ววางตึกนั้นไว้ติด GPU บนแผ่นฐานเดียวกัน ลองไล่ดูทีละก้าว
ความลับอยู่ที่ “กว้าง” ไม่ใช่ “เร็วต่อเส้น” แทนที่จะดันให้ข้อมูลแต่ละเส้นวิ่งเร็วสุดๆ (ซึ่งร้อนและกินไฟ) HBM เปิดทางวิ่งให้กว้างมหาศาลแทน — เสาหนึ่งมีบัสกว้าง 1,024 บิต (HBM3) ไปจนถึง 2,048 บิต (HBM4) เทียบกับ DDR5 ที่กว้างแค่ 64 บิตต่อช่อง เหมือนเปลี่ยนจากถนนเลนเดียวเป็นทางด่วน 16–32 เลน รถวิ่งความเร็วพอประมาณ แต่ผ่านได้ทีละมหาศาล ผลคือ HBM3E เสาเดียวส่งข้อมูลได้ราว 1.2 TB ต่อวินาที และการ์ด AI ระดับสูงมักวาง HBM 8 เสา รวมแบนด์วิดท์ได้หลายเท่าตัว
TSV (Through-Silicon Via) = รูเล็กจิ๋วที่เจาะทะลุแผ่น DRAM ทุกชั้นแล้วชุบโลหะ เพื่อให้สัญญาณวิ่งขึ้น-ลงระหว่างชั้นได้โดยตรง — เป็นเหตุผลที่ซ้อนชั้นแล้วยังเร็วอยู่ · Interposer = แผ่นฐานซิลิคอนที่ GPU กับเสา HBM นั่งอยู่ด้วยกัน ทำหน้าที่เป็น “ทางด่วน” เดินสายหลายพันเส้นเชื่อมสองฝั่งในระยะใกล้มาก — ขั้นตอนการประกอบทั้งหมดนี้คืองานของ Advanced Packaging & Test (OSAT)
04มันอยู่ตรงไหนในระบบนิเวศ AI
HBM ไม่ได้ทำงานลำพัง มันเป็นชิ้นส่วนหนึ่งที่ต้องประกอบรวมกับเพื่อนบ้านในห่วงโซ่ชิป AI อย่างแยกกันไม่ออก ลองดูว่ามันเชื่อมกับใครบ้าง
- คู่กับ GPU & Merchant Accelerators เสมอ: HBM เกิดมาเพื่อป้อน GPU การ์ด AI อย่าง Nvidia Blackwell B200 มาพร้อม HBM3E 192GB ให้แบนด์วิดท์ 8 TB/s — ขายเป็นแพ็กเกจเดียวกัน ถ้าไม่มี HBM ที่ดีพอ GPU ที่แรงที่สุดก็ทำงานได้ไม่เต็มที่
- ต้องพึ่ง Advanced Packaging & Test (OSAT) ในการประกอบ: การเอาเสา HBM มาวางติด GPU บน interposer ต้องใช้เทคนิคแพ็กเกจขั้นสูง (เช่น CoWoS ของ TSMC) ซึ่งเองก็เป็นคอขวดอีกชั้น — บางช่วงของก็พอ แต่ที่ประกอบไม่ทัน
- เป็นหน่วยความจำสาขาหนึ่งของ Memory ใน Semiconductors: HBM คือ DRAM ชนิดพรีเมียม การที่ผู้ผลิตเทกำลังผลิตไปทำ HBM (ซึ่งกิน wafer ต่อ GB มากกว่า DDR5 ราว 3 เท่า) ส่งผลสะเทือนถึงราคาแรมทั้งตลาด — ดีมานด์ AI จึงดันราคาแรมพีซีและเซิร์ฟเวอร์ขึ้นไปด้วย
- ขับเคลื่อนดีมานด์ของ Energy Transition & Power Demand และพึ่ง Critical Materials & Supply Chain: ดาต้าเซ็นเตอร์ AI ที่อัด HBM กินไฟมหาศาล และการผลิต HBM ต้องใช้วัสดุและเครื่องมือเฉพาะทางจำนวนมาก
05ตอนนี้ไปถึงไหนแล้ว (2025–2026)
เรื่องที่ทำให้ HBM เป็นข่าวตลอดคือ มันขายหมดล่วงหน้าหลายปี ไม่ใช่คำพูดเกินจริง — กลางปี 2025 ผู้บริหารการเงินของ SK Hynix ระบุชัดว่าบริษัท “ขายกำลังผลิต HBM ทั้งหมดของปี 2026 หมดเกลี้ยงแล้ว” ฝั่ง Micron ก็ยืนยันว่ากำลังผลิตปี 2025 และ 2026 ถูกจองเต็มเช่นกัน เมื่อของหายากขนาดนี้ ราคาก็พุ่ง — Samsung และ SK Hynix ขึ้นราคา HBM3E สำหรับปี 2026 ราว 20% ขณะที่ราคา DRAM เซิร์ฟเวอร์ทั่วไปก็ถูกดันขึ้นตามไปด้วย
แต่ภาพที่ช็อกกว่าคือ การกระจุกตัว — HBM เกือบทั้งโลกมาจากผู้ผลิตแค่ 3 ราย และในจำนวนนั้นรายเดียวคุมตลาดส่วนใหญ่ SK Hynix ครองส่วนแบ่ง HBM ราว 60% ในปี 2025 และคว้าออเดอร์ HBM4 ของ Nvidia ไปได้ราว 70% ตามมาด้วย Micron และ Samsung ที่สลับกันเป็นเบอร์สองในแต่ละไตรมาส
ทำไมรายใหม่ถึงเข้ามายาก? เพราะ HBM ผลิตยากกว่าแรมธรรมดามาก การซ้อนแผ่น DRAM 12 ชั้นโดยขัดแต่ละแผ่นให้บางเฉียบ (ราว 10–20 ไมครอน) แล้วเจาะรู TSV เชื่อมให้ตรงทุกชั้นโดยไม่บิดงอ เป็นงานที่ยีลด์ (สัดส่วนของดี) ต่ำและพลาดง่าย แต่ละ GB ของ HBM กิน wafer มากกว่า DDR5 ราว 3 เท่า — ความรู้และประสบการณ์ที่สั่งสมมากลายเป็นกำแพงสูงที่ Samsung เองยังเคยพลาดรอบ HBM3E จนถูกแซง
แรงหนุนหลักคือดีมานด์ AI ที่ไม่มีทีท่าจะหยุด การที่ Nvidia, AMD และยักษ์เทคที่ออกแบบชิปเอง (Custom Silicon / ASIC) ทุกรายต้องใช้ HBM ทำให้ผู้ผลิตทั้งสามรายมีรายได้และกำไรทำสถิติใหม่ต่อเนื่อง — HBM กลายเป็น “เหมืองทอง” ที่พลิกธุรกิจหน่วยความจำจากของโภคภัณฑ์ราคาผันผวน ให้เป็นสินค้าพรีเมียมที่ลูกค้าต้องจองคิว
06อนาคต — HBM4 และฐานที่ฉลาดขึ้น
ทิศทางแรกคือการขยับสู่ HBM4 ซึ่ง JEDEC รับรองมาตรฐานเมื่อเมษายน 2025 และเริ่มส่งมอบจริงปลายปี 2025 ถึงต้นปี 2026 จุดเปลี่ยนใหญ่คือบัสกว้างขึ้นเป็นสองเท่า (2,048 บิตต่อเสา) ทำให้แบนด์วิดท์ต่อเสาแตะราว 2 TB/s และซ้อนได้ถึง 16 ชั้น (เสาละ 48GB) ลูกค้ารายแรกคือการ์ด Nvidia Rubin ที่จะวาง HBM4 ถึง 8 เสา รวมหน่วยความจำ 288GB และแบนด์วิดท์รวมราว 22 TB/s ต่อการ์ด
ทิศทางที่สองน่าสนใจกว่า — HBM กำลังเลิกเป็นสินค้าโภคภัณฑ์ แล้วกลายเป็นของสั่งทำ (custom HBM) หัวใจอยู่ที่ “ฐานของเสา” (base die) ชั้นล่างสุดของเสา HBM แต่เดิมเป็นแค่ตัวเชื่อมเฉยๆ แต่ใน HBM4 มันถูกยกระดับให้เป็น ชิปลอจิกจริงๆ ที่ผลิตด้วยเทคโนโลยีขั้นสูงของ TSMC (ระดับ 12nm ไปจนถึง 3nm) ทำให้ผู้ออกแบบชิปสามารถ “ฝัง” วงจรควบคุมหน่วยความจำลงในฐานของเสาได้ — เท่ากับหน่วยความจำถูกออกแบบมาเพื่อ GPU ตัวนั้นโดยเฉพาะ ไม่ใช่ของสำเร็จรูปที่ซื้อมาเสียบ
นี่เป็นการเปลี่ยนนิยามของธุรกิจหน่วยความจำเลย — จากเดิมที่ขายของเหมือนกันแข่งกันที่ราคา กลายเป็นการ “ออกแบบร่วมกับลูกค้า” ซึ่งทำให้ผู้ผลิต HBM ผูกติดกับลูกค้าใหญ่อย่าง Nvidia แน่นขึ้น มีอำนาจต่อรองและกำไรต่อชิ้นสูงขึ้น — และยิ่งดึงให้ผู้เล่นหน้าใหม่เข้ามาแข่งยากขึ้นไปอีก
07ความท้าทายและความเสี่ยง
ความเสี่ยงข้อแรกคือ การกระจุกตัวที่สุดขั้ว ทั้งฝั่งคนขายและคนซื้อ ฝั่งคนขายมีแค่ 3 ราย และรายเดียวคุมเกินครึ่ง ฝั่งคนซื้อก็กระจุกหนัก — Nvidia รายเดียวกินดีมานด์ HBM ส่วนใหญ่ของโลก เมื่อทั้งห่วงโซ่พึ่งบริษัทไม่กี่ราย ถ้ารายใดสะดุด (ยีลด์ตก โรงงานมีปัญหา หรือลูกค้ารายใหญ่ชะลอแผน) แรงสะเทือนจะกระจายทั้งอุตสาหกรรม AI ทันที
ความเสี่ยงข้อสองคือ วัฏจักรของหน่วยความจำ ธุรกิจ DRAM ขึ้นชื่อเรื่องขึ้น-ลงเป็นคลื่นแรง เวลาดีมานด์พุ่ง ราคาทะยานและทุกรายเร่งขยายกำลังผลิต แต่พอกำลังผลิตล้นตลาดพร้อมกัน ราคาก็ดิ่ง ตอนนี้ HBM ดูเหมือน “เหมืองทอง” ที่ขายหมดล่วงหน้า แต่ถ้าทั้งสามรายขยายกำลังผลิตแรงเกินไป หรือดีมานด์ AI ชะลอลงแม้แค่ชั่วคราว วงจรขาลงก็อาจกลับมา — กำไรที่ทำสถิติวันนี้ไม่ได้การันตีว่าจะคงอยู่ตลอด
ความเสี่ยงข้อสามคือ ความยากเชิงเทคนิคที่ทวีขึ้น ยิ่งซ้อนสูง (12 ชั้นไป 16 ชั้น) ความร้อนสะสมในเสายิ่งเป็นปัญหา ขณะที่ความสูงรวมของเสาถูกจำกัดด้วยมาตรฐาน (ราว 720–775 ไมครอน) แปลว่าต้องขัดแต่ละแผ่นให้บางลงอีกโดยไม่ให้บิดงอหรือร้าว ทุกเจเนอเรชันใหม่คือการดันขีดจำกัดฟิสิกส์ — รายที่ทำยีลด์ได้ก่อนจะได้เปรียบมหาศาล รายที่พลาดอาจเสียลูกค้าใหญ่ไปทั้งรอบ อย่างที่เคยเกิดขึ้นมาแล้ว
สรุปสั้นๆ: HBM คือแรมที่เอา DRAM มาซ้อนเป็นตึกแล้วแปะข้าง GPU เพื่อทลาย “กำแพงหน่วยความจำ” — เป็นชิ้นส่วนที่ขายหมดล่วงหน้าหลายปี ทำกำไรงาม กำแพงสูง แต่กระจุกตัวและผันผวนตามวัฏจักร ทุกครั้งที่ AI ฉลาดและหิวข้อมูลขึ้น บทบาทของ “คนป้อนข้อมูลให้สมอง” ก็ยิ่งสำคัญขึ้นเท่านั้น