メガトレンド · Artificial Intelligence
世界でいちばん高価なAIカードでも、「メモリ」がデータを運んでくるのをじっと待つしかない
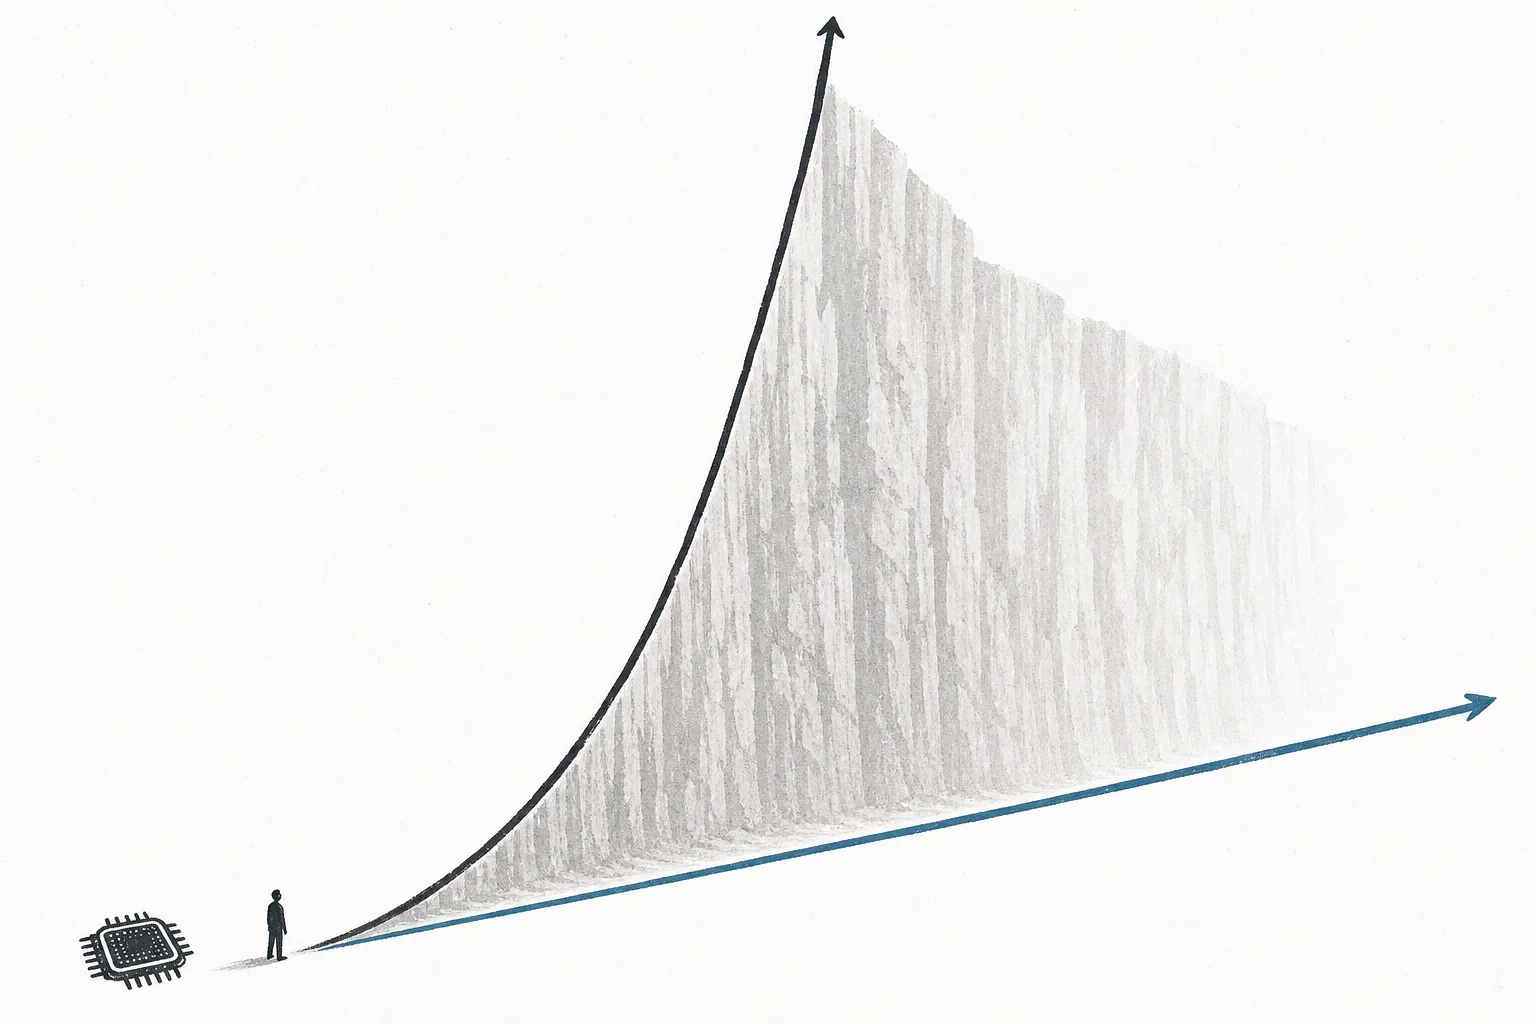
AIの心臓はものすごく速く計算するGPUだ——私たちはつい、そう思いがちです。でも業界ではよく知られた事実があって——GPUが速くなりすぎて、メモリのほうが追いつけないんです。チップは10年で計算が80倍速くなったのに、データを送り込む速さは17倍しか伸びていない。結果として、数十万円もする計算コアが、データを待ったまま「手すき」になっていることが多いのです。これがメモリの壁(the memory wall)。そしてこれを打ち破る主役が HBM——DRAM をビルのように積み上げて、GPU のすぐ横に貼りつけた超高速メモリです。このレッスンでは、なぜこの部品が「何年も先まで完売」しているのか、そしてなぜ世界中がたった3社の製造元に頼っているのかを見ていきます。
01これは何?
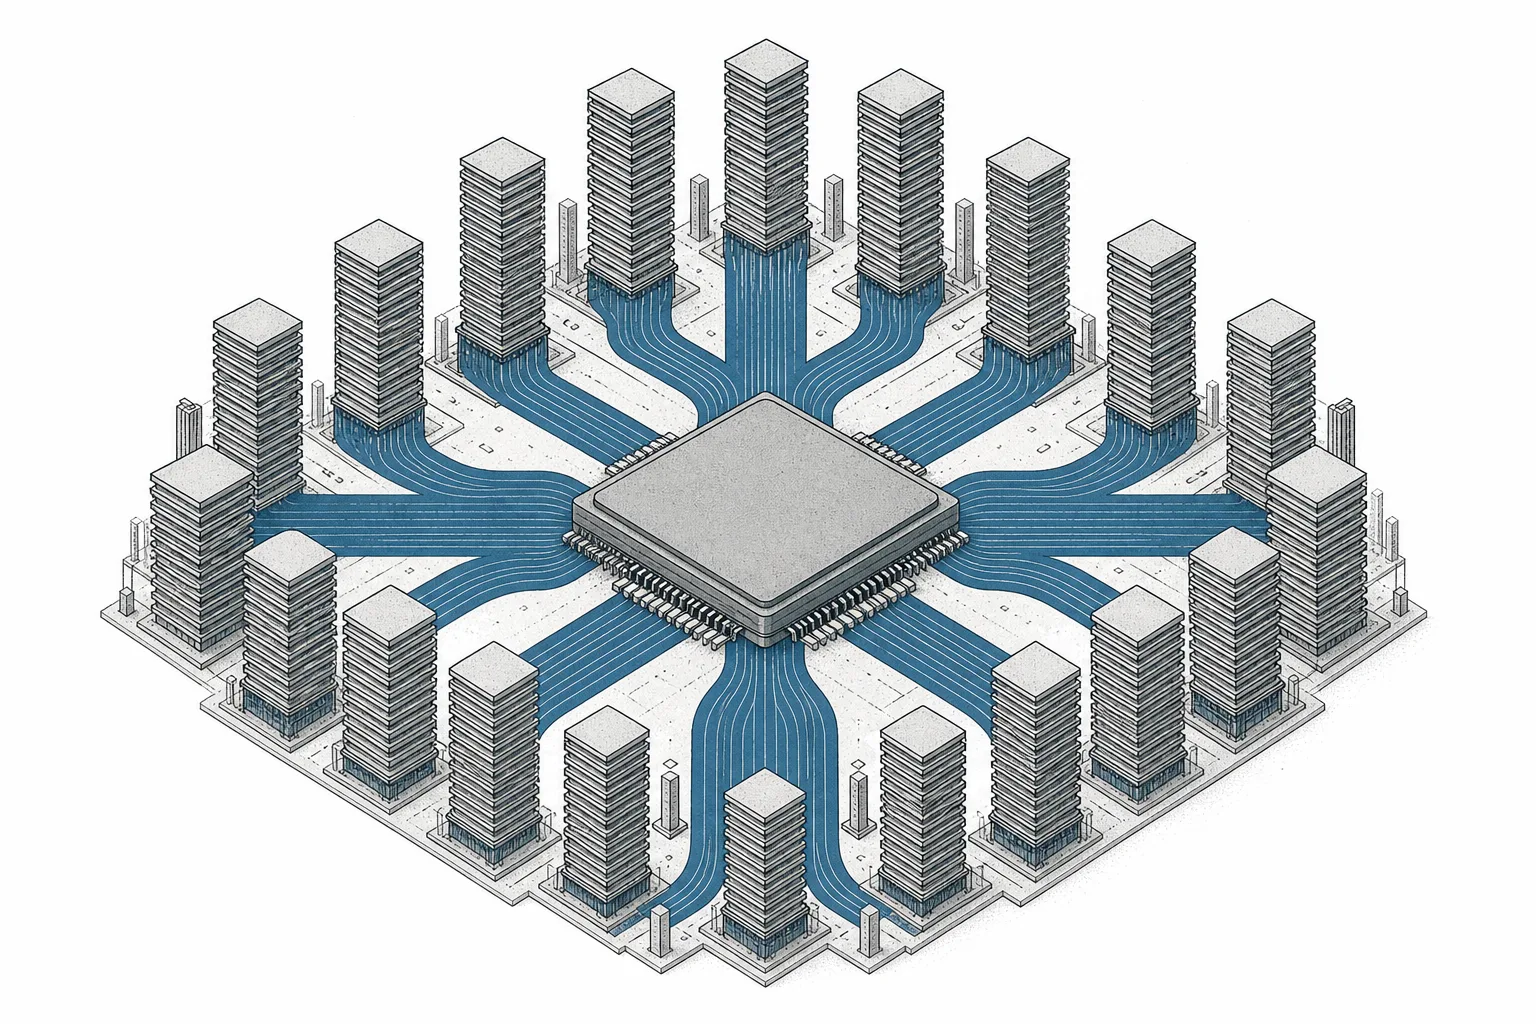
AIのパワーといえば、私たちはたいてい超高速で計算するGPUを思い浮かべます。でもよく考えてみてください——どれだけ速く計算できるチップでも、計算させる「データ」が間に合わなければ意味がない。腕利きのシェフが超速で料理できても、材料を運ぶ人が遅ければ、シェフは立って待つしかないのと同じです。HBM(High-Bandwidth Memory)は、まさにこの問題を直接解くために生まれました——DRAM を何層も積み上げてビルのようにし、GPU のすぐ横に貼りつけた超高速メモリで、材料(データ)を計算コアへできるだけ速く運ぶためのものです。
その核心は、たった二つの言葉に尽きます:「積む」と「広い」。ふつうのパソコンのメモリのように DRAM チップをマザーボードに平らに並べるのではなく、HBM は DRAM を8〜16層ビルのように積み重ね、そこに電気の通り道となる穴を全層まで貫通させます。そしてその柱を GPU のすぐ隣に置き、ものすごく幅広い「高速道路」でつなぐ。結果として、データはふつうのメモリの何十倍も速くチップへ流れ込むのです。
メガトレンドの地図のなかで、この node は大トレンドArtificial Intelligenceの下、AI Compute & Accelerator Siliconに属する枝葉(leaf)です。同じ親をもつ兄弟、たとえばGPU & Merchant Accelerators(考える側)やAdvanced Packaging & Test (OSAT)(GPU と HBM を組み立てる側)と肩を並べています——GPU が脳だとすれば、HBM は脳のすぐそばにある短期記憶。脳が止まって待たずに考え続けられるようにするものなのです。
Bandwidth(バンド幅)=1秒あたりに送れるデータ量——GB/s や TB/s で測ります。多いほどデータを速く運べます · DRAM=動作中のデータを置いておく主記憶チップ(パソコンのメモリもこの DRAM です)· HBM=DRAM を何枚もビルのように積み、特別に広いバスでつないだもの。いちばん小さい面積で最大のバンド幅を得るための設計です——DRAM の一種ではあるけれど、速さのために特別に並べたものなんです。
02なぜ重要か——メモリの壁
チップ業界を何年も悩ませてきた現象があります。「メモリの壁」(the memory wall)と呼ばれるものです。話はこうです——GPU の処理能力が、メモリの速度よりもずっと速いペースで伸びている。よく引かれる数字では、2012〜2022年のあいだに Nvidia の GPU の計算能力(FLOPS)はおよそ80倍に増えたのに、メモリのバンド幅は17倍ほどしか増えませんでした。この差は年々広がり、ついにメモリが「ボトルネック」の筆頭に。カードのなかでいちばん高価な計算コアが、考えるかわりにデータを待っていることが多くなったのです。
この問題は、現代のAIではいっそう深刻になります。とくに大規模言語モデル(LLM)を動かすときです。モデルが質問に答えるたびに、何千億ものパラメータをメモリから読み出さなければなりません。こういう仕事は、計算能力よりもバンド幅を「食う」のです——ChatGPT の返答の速さは、考えるコアの速さよりもメモリの速さで決まる。HBM だけが GPU の飢えに間に合うようデータを送り込めるので、これは追加オプションではなく、欠かせない部品なんです。
市場の大きさが、この重要さをはっきり映しています。かつては数十億ドル規模の特殊メモリにすぎなかった HBM 市場は、2025年に約350億ドルへと急成長し、多くの調査機関は2028年までに1,000億ドルに届くと見ています——年平均およそ40%の伸びで、歴史上もっとも速く成長するチップ市場のひとつです。
03どう動くのか(DRAM をビルのように積む)
HBM の妙手は、「横に並べる」から「縦に積む」へと向きを変えたことです。ふつうのパソコンのメモリはマザーボード上に並べて挿し、細い線(DDR5 は1チャネル64ビット幅)でチップと話します。でも HBM は3つの違うことをやります——DRAM をビルのように積み、全層を貫く穴でつなぎ、その柱を GPU のすぐ隣、同じ土台の上に置く。順を追って見ていきましょう。
秘密は「線ごとの速さ」ではなく「広さ」にあります。1本ずつのデータをめちゃくちゃ速く走らせる(熱くなって電気も食う)のではなく、HBM は走る道をとてつもなく広げるほうを選びました——1本の柱でバス幅1,024ビット(HBM3)から2,048ビット(HBM4)。1チャネル64ビット幅しかない DDR5 と比べると、片側1車線の道を16〜32車線の高速道路に変えたようなもの。1台ずつはほどほどの速さでも、いちどに通れる量が桁違いなんです。結果、HBM3E は1本で1秒あたり約1.2 TBを送れる。ハイエンドのAIカードはたいてい HBM を8本載せるので、合計バンド幅はその何倍にもなります。
TSV(Through-Silicon Via)=DRAM の全層を貫いて開け、金属を詰めた極小の穴。信号が層と層のあいだを直接上下できるようにします——積み重ねても速いままでいられる理由です · Interposer=GPU と HBM の柱がいっしょに乗るシリコンの土台。何千本もの配線を「高速道路」のように敷き、ごく近い距離で両者をつなぎます——この組み立て工程ぜんぶがAdvanced Packaging & Test (OSAT)の仕事です。
04それはAIの生態系のどこにいるのか
HBM は単独では働きません。AIチップのサプライチェーンのなかで、ご近所さんと切り離せないかたちで組み合わさる部品のひとつです。どことどうつながっているのか、見てみましょう。
- つねにGPU & Merchant Acceleratorsとペア: HBM は GPU に供給するために生まれました。Nvidia Blackwell B200 のようなAIカードは HBM3E 192GB を載せ、バンド幅8 TB/s を出します——ひとつのパッケージとして一緒に売られるのです。十分にいい HBM がなければ、いちばん強い GPU も実力を出しきれません
- 組み立てをAdvanced Packaging & Test (OSAT)に頼る: HBM の柱を GPU のとなりに interposer 上で置くには、高度なパッケージ技術(たとえば TSMC の CoWoS)が要ります。これ自体がもう一段のボトルネック——HBM はあっても、組み立てが間に合わないことがあるのです
- Memory(Semiconductors のなか)の一分野: HBM はプレミアムな DRAM の一種。製造各社が生産能力を HBM(GB あたり DDR5 の約3倍の wafer を食う)へ振り向けると、メモリ市場全体の価格に波及します——AI需要が、PC やサーバーのメモリ価格まで押し上げているのです
- Energy Transition & Power Demandの需要を生み、Critical Materials & Supply Chainに頼る: HBM を詰め込んだAIデータセンターは膨大な電力を食い、HBM の製造には専用の材料や装置が大量に要ります
05いま、どこまで来たのか
HBM がいつもニュースになる理由は、何年も先まで完売していること。大げさな言い回しではありません——2025年なかば、SK Hynix の財務責任者ははっきりこう述べました。「2026年の HBM 生産能力はすべて売り切れた」と。Micron も2025年と2026年の生産能力が予約で埋まっていると認めています。これほど希少になれば価格も跳ね上がる——Samsung と SK Hynix は2026年向けの HBM3E を約20%値上げし、ふつうのサーバー用 DRAM の価格もつられて押し上げられました。
でももっと衝撃的なのは集中ぶりです——世界の HBM のほとんどがたった3社から生まれ、そのなかでも1社が市場の大半を握っています。SK Hynix は2025年に HBM の約60%のシェアを握り、Nvidia の HBM4 受注も約70%をさらいました。続くのが Micron と Samsung で、四半期ごとに2番手を入れ替わっています。
なぜ新規参入がこれほど難しいのか? HBM がふつうのメモリよりずっと作りにくいからです。DRAM を12層積むには、1枚1枚を極薄(約10〜20ミクロン)に削り、そこに TSV の穴を、全層でずれず曲がらずに通さなければなりません。これは歩留まり(良品の割合)が低く、失敗しやすい仕事です。HBM は1GB あたり DDR5 の約3倍の wafer を食う——積み上げてきた知識と経験そのものが高い壁になっていて、Samsung でさえ HBM3E の世代で一度つまずき、追い抜かれたほどです。
いちばんの追い風は、止まる気配のないAI需要です。Nvidia、AMD、そして自社でチップを設計する巨大テック(Custom Silicon / ASIC)が、どこも HBM を必要とするので、3社はそろって過去最高の売上と利益を更新し続けています——HBM は「金鉱」になり、価格が乱高下する commodity だったメモリ事業を、顧客が順番待ちするプレミアム品へと変えてしまったのです。
06未来——HBM4 と、より賢くなる土台
まず一つめの方向はHBM4への移行。JEDEC が2025年4月に規格を承認し、2025年末から2026年初めに実際の出荷が始まりました。大きな転換点は、バスが2倍に広がること(1本2,048ビット)。これで1本あたりのバンド幅は約2 TB/sに達し、最大16層(1本48GB)まで積めます。最初の顧客はNvidia Rubinというカードで、HBM4 を8本も載せ、合計メモリ288GB、合計バンド幅は1枚あたり約22 TB/s になります。
二つめの方向のほうが面白い——HBM は commodity をやめ、オーダーメイド(custom HBM)になりつつある。鍵は「柱の土台」(base die)、HBM の柱のいちばん下の層です。もともとは単なるつなぎ役でしたが、HBM4 ではこれがTSMC の先端技術で作る本物のロジックチップ(12nm から3nm まで)に格上げされます。これでチップ設計者は、メモリ制御回路を柱の土台に「埋め込む」ことができる——つまりメモリが、その GPU のためだけに設計される。買ってきて挿す既製品ではなくなるのです。
これはメモリ事業の定義そのものを変えます——同じものを作って価格で競っていたのが、「顧客と一緒に設計する」かたちへ。これで HBM の製造各社は Nvidia のような大口顧客とより強く結びつき、交渉力も1個あたりの利益も高まる——そして新規プレーヤーがますます参入しにくくなるのです。
07課題とリスク
最初のリスクは極端な集中、それも売り手と買い手の両方にあります。売り手はたった3社で、1社が過半を握る。買い手も激しく集中していて——Nvidia 1社が世界の HBM 需要の大半を吸い込んでいます。チェーン全体がわずかな企業に頼っているので、どこか1社がつまずけば(歩留まりの低下、工場のトラブル、あるいは大口顧客が計画を遅らせる)、その揺れはたちまちAI業界全体に広がります。
二つめのリスクはメモリの周期性です。DRAM 事業は、激しい波で上がり下がりすることで知られています。需要が跳ねると価格は急騰し、各社が生産能力を一斉に増やす。でも生産能力がいっぺんに市場へあふれると、今度は価格が急落する。いま HBM は「金鉱」のように何年も先まで完売していますが、もし3社が増産しすぎたり、AI需要が一時的にでも鈍れば、下り坂の周期が戻ってくるかもしれません——今日の過去最高益が、ずっと続く保証はないのです。
三つめのリスクは積み増していく技術的な難しさです。高く積むほど(12層から16層へ)、柱のなかにこもる熱が問題になる。いっぽうで柱の総高さは規格で制限されている(約720〜775ミクロン)ので、1枚をさらに薄く削らなければならない——曲げず、割らずに。新しい世代はどれも物理の限界を押し広げる挑戦です——先に歩留まりを出せた者が大きく有利になり、つまずいた者は大口顧客をその世代まるごと失いかねない。すでに一度起きたとおりです。
ひとことで言えば:HBM は、DRAM をビルのように積んで GPU の横に貼りつけ、「メモリの壁」を打ち破るための部品です——何年も先まで完売し、利益も厚く、参入の壁も高い。でも供給が一握りに集中し、周期に合わせて揺れる。AIが賢くなり、データに飢えるたびに、「脳にデータを運ぶ人」の役割もまた、いっそう重みを増していくのです。