メガトレンド · 半導体
AI時代のボトルネックになった、最後の工程
何十年ものあいだ、「チップの組み立てとテスト」は誰も気に留めない最後の工程でした。裏方で、安くて、誰にでもできる作業。でも、AIが突然それを世界のほんとうのボトルネックに変えてしまったんです。AIチップを1つ作るには、もうチップを小さくするだけでは足りません。複数のチップとHBMメモリを「パッケージング」して1つの塊にまとめる——これが決め手。そして今、NVIDIAはTSMCのこの工程を2027年まで予約で埋めてしまっています。
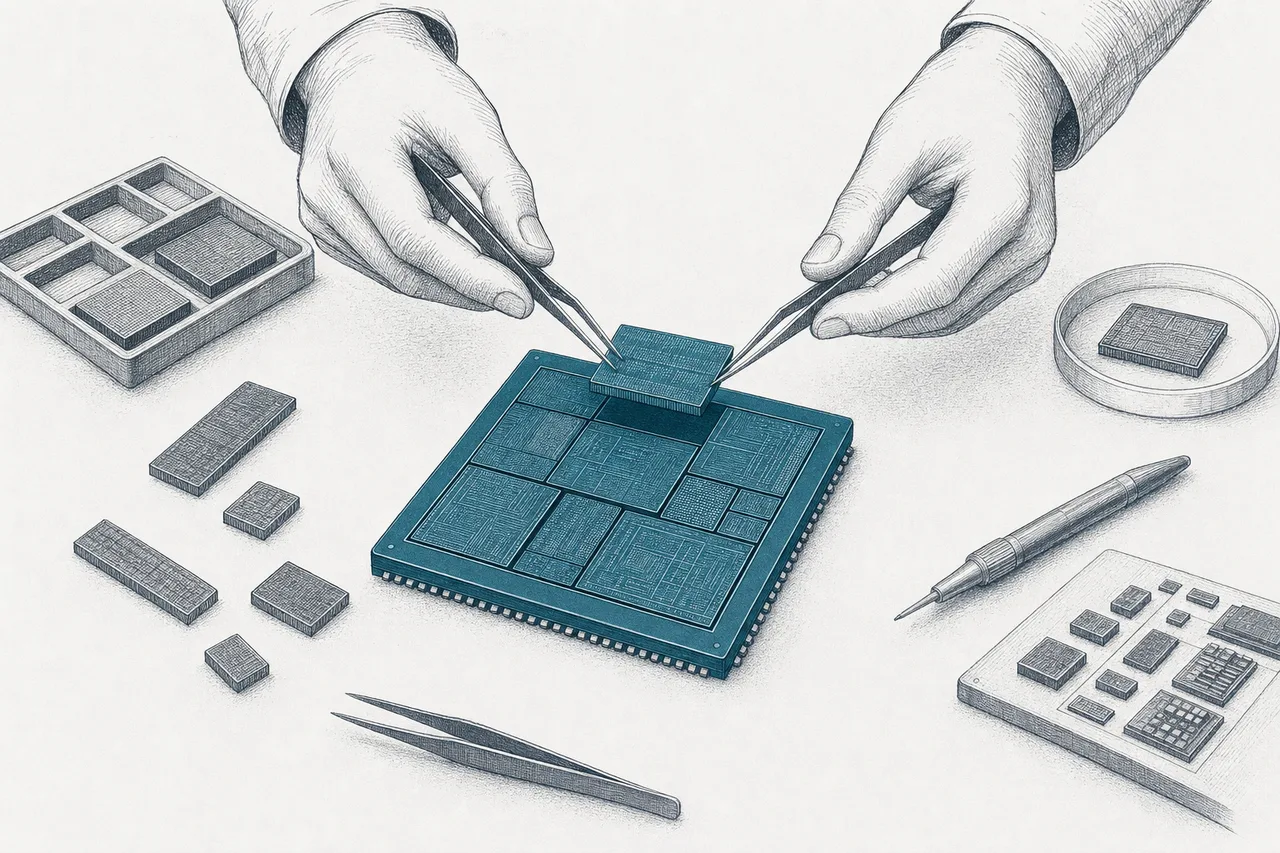
01これは何?(OSATとアドバンスト・パッケージング)
「チップを作る」と聞くと、多くの人はシリコンの板に回路を焼き付ける最先端の工場を思い浮かべます——それがファウンドリの仕事です。でも実は、シリコンの板(ウエハー)が工場から出てきた段階では、まだまったく使えません。生のチップが何百、何千と並んだ、ただの丸い板なんです。そこで誰かが1つずつチップに切り分け、基板に挿せるよう「パッケージ」に収め、どれが良品でどれが不良品かをテストする——この裏方の工程こそ、本記事の主役です。
業界では、この作業を請け負う会社をOSAT(Outsourced Semiconductor Assembly and Test)と呼びます。直訳すると「チップの組み立てとテストの受託」。ファウンドリのモデルとまったく同じで、ただ反対側の終点にあります。チップ設計会社やファウンドリは、組み立て・テスト用の装置に自前で投資したくないので、OSATに任せるんです。台湾のASEや米国のAmkorが、この製造ラインの終盤を担う下請けです。
チップ業界は仕事を2つの側に分けます。Front-end=ウエハーの上にトランジスタを作り込む工程(ファウンドリの仕事。EUV装置を使う、最先端で最も高価な部分)。Back-end=ウエハーを切り出し、パッケージに組み立て、テストする工程(OSATの仕事)。長いあいだback-endは、本番のあとにくっつく「退屈で安い工程」と見られてきました——でも、AIがその常識をひっくり返しつつあります。
でも面白いのは「advanced」パッケージングという言葉です。昔のチップのパッケージングは、1つのチップをプラスチックの箱に入れて足を出すだけ——簡単で利幅も薄い作業でした。でもアドバンスト・パッケージングは、複数のチップを1つのパッケージに組み合わせ、まるで1つのチップのように高速でやり取りさせます。いまの主役がTSMCのCoWoSという技術で、NVIDIAのAIチップとHBMメモリを組み合わせるのに使われています——そして今、世界中が奪い合っているボトルネックがこれなんです。
私たちのメガトレンドの地図では、このノードは半導体の下のサブ分野で、チップが本物のAIサーバーに載る前の「最後の関門」です——しかも突然、製造ライン全体でいちばん狭くなった関門です。
02なぜ最後の工程がボトルネックになったのか
話は物理の問題から始まります——ムーアの法則の減速です。何十年ものあいだ、チップ業界はトランジスタをどんどん小さくし、1つのチップに詰め込むことで進歩してきました。でも今、それ以上小さくするのは難しく、コストも跳ね上がっています。さらに「サイズの壁」(レチクル限界)——回路を焼く装置が一度に作れるチップの最大サイズという物理的な限界もあります。大きな処理能力を必要とするAIチップはこの天井にぶつかり、もう1つの塊では作れなくなりました。
解決策は発想の転換でした。1つのチップを大きく高度にする代わりに、小さなチップ(チップレットと呼びます)を複数つなぎ合わせ、1つのチップのように動かす——この作業はすべてパッケージングの工程で起こります。言い換えると、チップの進歩が「front-end(小さくする)」から「back-end(うまく組み立てる)」へ移ったんです。退屈だった工程が新しい戦場になった理由がこれです。
チップレット=特定の役割(計算用、入出力用など)に設計された小さなチップで、複数を1つのパッケージに組み合わせて強力なシステムにします · 利点は、作りやすい(小さいほど歩留まりが良い)、世代の違う技術を混ぜられる、レチクル限界を超えられること · 最新のAIチップはほぼすべてチップレットです——たとえばNVIDIA Blackwell(B200)は2つのチップをつないだものです。
そしてこれは大きく、速く伸びる市場です。世界のOSAT市場は2025年で約460〜470億ドル、2035年までに約1,000億ドルに達すると見込まれます(年平均約8%成長)。でも本当に熱いエンジンはアドバンスト・パッケージングの部分で、伸びはずっと速い——いちばん熱いチップレット分野は、約520億ドル(2025年)から約1,570億ドル(2030年)へ、年平均なんと約25%で伸びると予測されています。
03CoWoSの仕組み
ChatGPTを動かすAIチップを思い浮かべてください。それは1つの塊ではなく、中央に処理チップ(GPU)があり、その周りを複数のHBMメモリが囲む構造です。すべてを可能な限り密着させ、データを極限まで速くやり取りさせる必要があります。問題は——別々の工場で作られた別々のチップを、ナノメートル単位でぴったり並べて通信させるには、どうすればいいのか?
答えがCoWoS(Chip-on-Wafer-on-Substrate)、TSMCの技術です。その心臓部が真ん中の薄い板、インターポーザー——GPUとすべてのHBMを結ぶ精密な配線が走る「高速の橋」となるシリコンの板です。通常の基板に長い配線を引く(遅い)代わりに、すべてを同じシリコンの橋の上に載せる(はるかに速い)わけです。
では、なぜそれが難しくてボトルネックになるのか? インターポーザー自体がファウンドリ級の工場で作らねばならないシリコン片であり、その上に複数のチップを、何万もある接合点の1つも外さずぴったり載せる作業が、とてつもなく繊細だからです。組み立てを1か所でも失敗すれば、数万ドルのAIチップが丸ごと不良になる——だから生産能力はゆっくりとしか増やせず、コストも高いのです。
2.5D=複数のチップをインターポーザーの上に「横に並べる」(例:CoWoS——GPUとHBMが同じ平面にある) · 3D=チップを垂直に「積み重ね」、TSV(貫通ビア)で縦に貫いて接続する(例:TSMCのSoIC——処理チップを直接積む) · 3Dは密度も速度も高いが、積み重なったチップの放熱が必要なぶん格段に難しい——これが業界の次の方向です。
04エコシステムの中でのつながり
このノードは、AIチップのあらゆる部品が本当に1つの塊へと集まる「合流点」です。だから半導体業界の兄弟分とも、川下のトレンドとも、強く結びついています。
- AIに直接、そして最も激しく供給する: すべてのAIチップはこの工程を通ります——アドバンスト・パッケージングなしに現代のGPUはありません。AIブーム全体がこのボトルネックを通り抜けます。
- メモリ(HBM)との相棒: CoWoSはそもそもGPUとHBMを組み合わせるために存在します。HBMのボトルネックとパッケージングのボトルネックは固く絡み合い、どちらが欠けてももう一方の足を引っ張ります。
- ファウンドリとの境界が曖昧に: 以前はファウンドリがウエハーを作り、OSATがパッケージングしていました。でも今はTSMCがCoWoSを自社内で行い、最も先端の部分(インターポーザー)を抱え込んでいます。その結果、TSMCは最大かつ最も儲かるOSATにもなりました——外部のOSATはTSMCが捌ききれない「あふれた」仕事しか得られません。
- インターコネクト&基板の上に乗る: インターポーザーの下には、かつて品薄だった先端基板(ABF基板)という重要な部品があります。
- クラウド、電気自動車、ロボットへの道を開く: 高性能チップを必要とするあらゆるトレンドが、ますます先端パッケージングに依存しています。
05いま、どこまで来たのか
2025年を通じて話題を独占したのが「CoWoS不足」です。AIチップの需要がパッケージング能力の追いつく速度を超え、TSMCはCoWoSの増産を全力で進めました——2024年末の月産約35,000枚から2025年に約75,000枚、そして2026年末までに月産120,000〜130,000枚を目標に、2年足らずでほぼ4倍。でも驚くのは——これだけ増やしてもまだ足りないことです。
足りない理由はNVIDIAがほぼ買い占めているからです。NVIDIAはTSMCのCoWoS生産能力を2026年分の50%超(2025〜2026年を合わせると60%超という見方も)すでに予約済みと報じられ、2026年だけで約80〜85万枚に相当します。そのためAMDやBroadcomといった競合は残りの能力を奪い合い、CoWoSの待ち時間(リードタイム)は18か月超に延びています。
TSMCが捌ききれないため、あふれた仕事は外部のOSATへ流れ、2025年はこの分野にとっても当たり年になりました。Counterpointの「Foundry 2.0」の枠組みでは、OSAT分野は2025年に約10%成長し、ASEはTSMCに次ぐ第2位の大手に躍り出ました。Amkorも、米国でのパッケージング受注に向け、Arizona工場でTSMCと10年の生産能力契約を結びました(2025年10月)。
競争の全体像も序列は明確です。ASEが外部OSATの圧倒的な首位、続いてAmkor、そして国の後押しで勢いを増す中国勢、という並びです。
06これからの展開
第1の方向ははっきりしています:価値がfront-endからback-endへ移っている。トランジスタの微細化が天井に近づくにつれ、これからのチップの進歩はますます「組み立て方」から生まれます。TSMC、Samsung、Intelはいずれも数百億ドルを投じ、2027年に向けてパッケージング能力を拡大中——「裏方」の工程が主要な投資先になるのは史上初めてのことです。
第2の方向は2.5Dから3Dへの移行です。今日のCoWoSはチップを横に並べる(2.5D)ものですが、次の一歩は処理チップを垂直に「積み重ねる」(3D、たとえばTSMCのSoIC)こと——同じ面積により多くの能力を詰め込みます。積み重なったチップの放熱が必要で格段に難しいものの、これこそNVIDIAとAMDが向かっている方向です。
第3の方向はチップレットの共通規格(UCIe)です。複数の会社のチップレットが1つの規格で通信できれば(チップ版のUSBのように)、市場は大きく開きます。誰もが複数社のチップレットを混ぜて自分のチップを組めるようになり——パッケージング需要はさらに押し上げられ、少数の大手から力が分散するかもしれません。
07課題とリスク
アドバンスト・パッケージングの魅力には、理解しておくべき固有のリスクも伴います。
第1のリスクはAIと少数顧客への極端な依存です。今日のCoWoSの繁栄は、AIチップ需要と、ほぼ1社の顧客(NVIDIAが半分超を予約)に結びついています。AI投資が減速したり、チップの設計が変われば、ほぼ4倍に急拡大した生産能力は一気に余剰になりかねません——これは半導体業界に埋め込まれた循環の性質です。
第2のリスクは価値の大半がTSMCに吸い上げられることです。ノード全体がブームでも、最も儲かる工程(インターポーザー、chip-on-wafer)はTSMCが自社内で抱え、あふれた仕事や利幅の薄い部分(基板組み立て、テスト)だけを外部OSATに回します。だから「OSATブーム」は、すべてのプレーヤーが等しく潤うことを意味しません——誰がチェーンの最先端にいるかを見極めることが肝心です。
第3のリスクは地政学的な集中です。ファウンドリと同じく、上位のパッケージングはほぼすべて台湾にあります。米国へ取り戻す試み(ArizonaのAmkorとTSMC)はまだ始まったばかりで、遅く、高くつきます。一方で中国も自立のため自前のOSAT(JCET、Tongfu)を急いで築いています——かつて「重要でない」と見なされた工程が、もう1つの地政学の戦場になっているのです。
第4のリスクは上がり続けるコストです。2.5Dのアドバンスト・パッケージングは従来型より約20〜30%コストが高く、メーカーは値上げを進めています(ASEは+5〜20%、メモリのパッケージは2026年に最大+30%)。このコストは最終的にAIチップや機器の価格に転嫁され——技術チェーン全体のインフレ圧力になります。
ひとことで言えば、アドバンスト・パッケージングは、技術の世界で最も見過ごされていた工程が、ゲームのルールが変わった瞬間に最も重要な場所になりうるという教訓です。ムーアの法則が減速すると、「組み立て方」は「作り方」と同じくらい重要になります——そして、1つのAIチップがなぜ何年もパッケージングの順番待ちをするのかを理解することは、誰も気に留めなかった裏方の工程が、なぜAI時代全体の速度を決めるボトルネックになったのかを理解することなのです。