Megatrend · Artificial Intelligence
สวิตช์ตัวเดียวที่ตัดสินว่า GPU หมื่นตัว จะ “คิดเป็นเครื่องเดียว” ได้หรือไม่
เวลาเราพูดถึงคลัสเตอร์ AI เรามักนึกถึง GPU แต่จริงๆ แล้วสิ่งที่มัด GPU หลายหมื่นตัวให้กลายเป็นซูเปอร์คอมพิวเตอร์เครื่องเดียว คือ สวิตช์ — กล่องที่เป็นทางแยกจราจรของข้อมูล และหัวใจของมันคือ “ชิปสวิตช์” (switch silicon) ตัวเล็กๆ ที่กำหนดว่าทั้งคลัสเตอร์จะส่งข้อมูลถึงกันได้กว้างและเร็วแค่ไหน บทเรียนนี้เจาะเฉพาะชั้นนี้ — ชิปและระบบสวิตช์ฝั่งไฟฟ้า (Ethernet vs InfiniBand) ที่ Broadcom, Nvidia และ Arista กำลังชนกันด้วยเงินหลายแสนล้านดอลลาร์ (ส่วนฝั่ง “แสง” อยู่ในบทพี่น้อง Optical Interconnect)
01มันคืออะไร
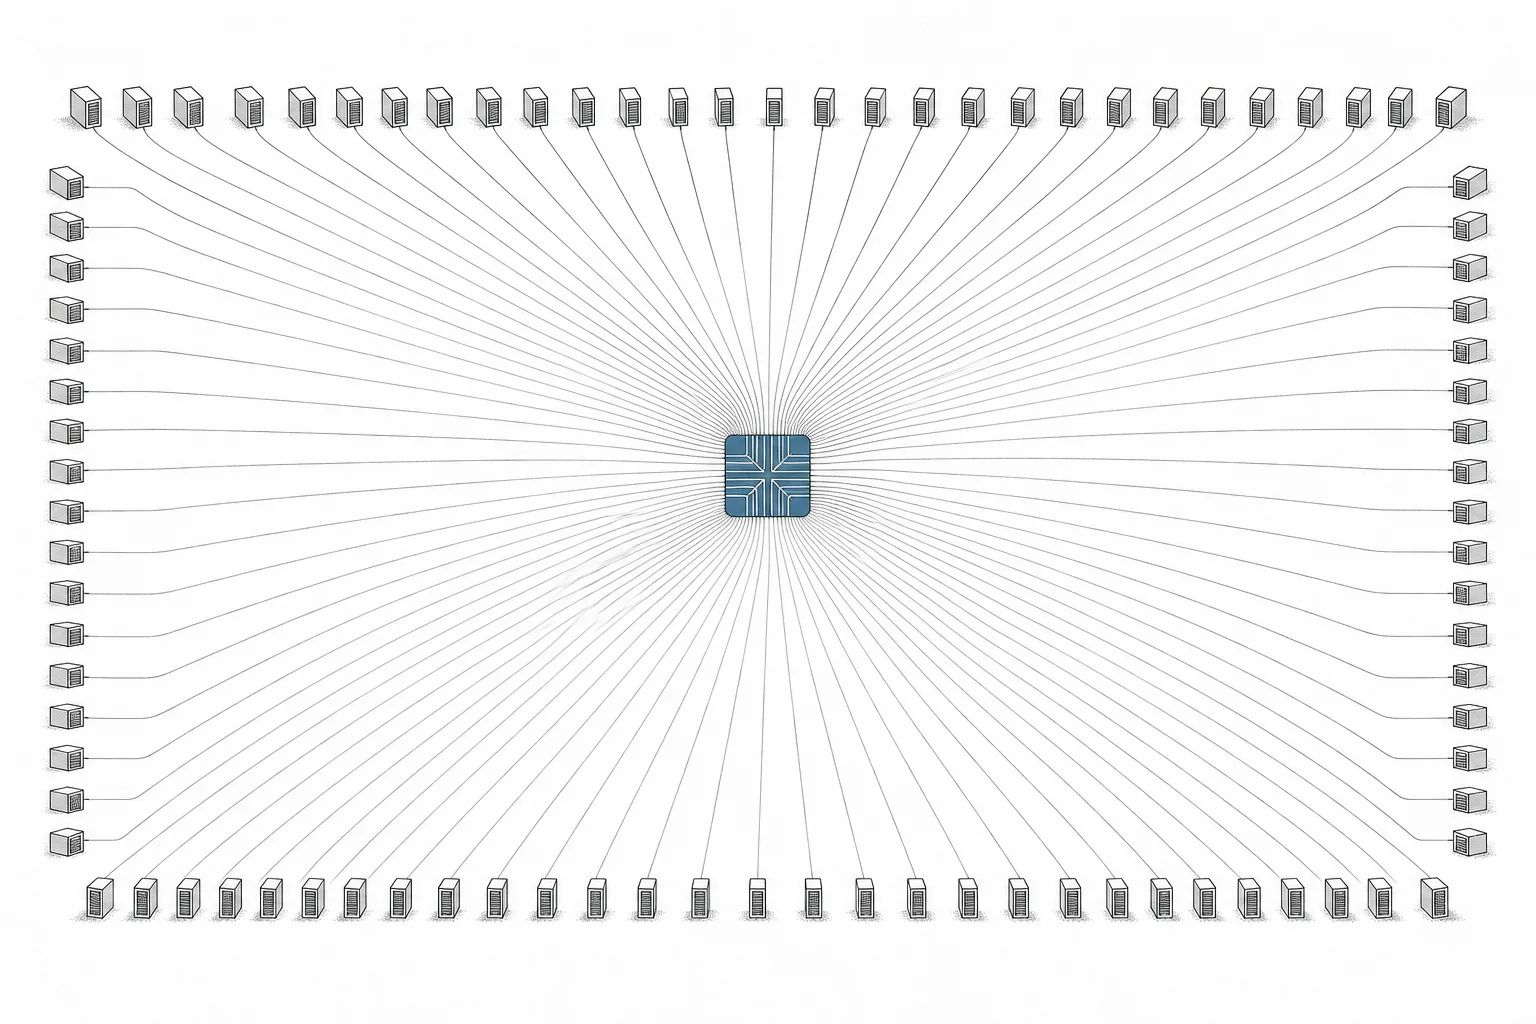
ลองนึกภาพห้องที่มีคนหมื่นคนกำลังทำงานชิ้นเดียวกัน ทุกคนเก่งมาก แต่ทุกๆ ไม่กี่วินาที พวกเขาต้องหันไปบอกผลลัพธ์ของตัวเองให้ ทุกคนที่เหลือ รู้พร้อมกัน — ถ้าไม่มีระบบส่งข่าวที่เร็วและไม่ติดขัด คนทั้งห้องก็ได้แต่นั่งตะโกนทับกันจนงานไม่เดิน สวิตช์เครือข่าย คือระบบส่งข่าวนั้นของคลัสเตอร์ AI และ node นี้คือเรื่องของชิปและกล่องที่ทำหน้าที่นี้
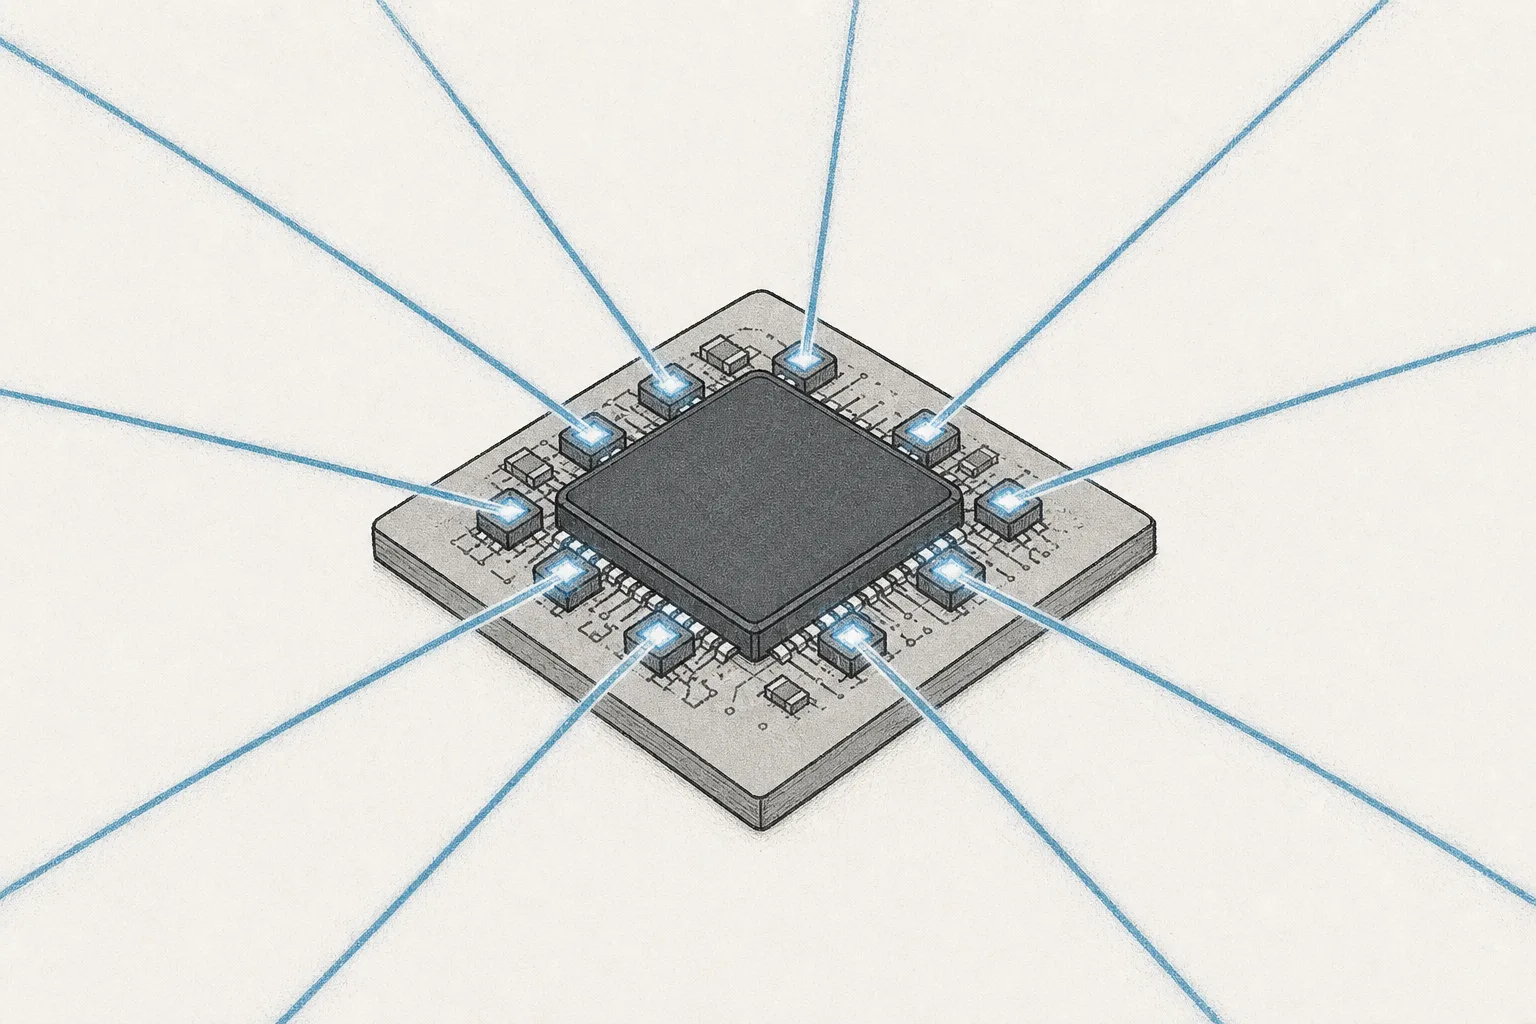
เจาะลงไปอีกชั้น สวิตช์ AI มีสองส่วนที่ต้องแยกให้ออก: (1) ชิปสวิตช์ (switch silicon / switch ASIC) — ชิปตัวเดียวข้างในกล่องที่ทำหน้าที่ตัดสินใจว่าข้อมูลแต่ละก้อนต้องวิ่งออกพอร์ตไหน มันคือ “สมอง” ที่กำหนดเพดานความเร็วของสวิตช์ทั้งตัว · (2) ระบบสวิตช์ (switch system) — ตัวกล่องจริงพร้อมซอฟต์แวร์คุมเครือข่าย ที่เอาชิปนั้นมาประกอบเป็นอุปกรณ์ใช้งานได้ บางบริษัท (Broadcom) ขายแต่ชิป บางบริษัท (Arista) เอาชิปมาทำเป็นระบบขาย และบางบริษัท (Nvidia) ทำเองทั้งสองชั้น
ในแผนผังเมกะเทรนด์ node นี้เป็นใบย่อย (leaf) ภายใต้ AI Networking & Interconnect ในเทรนด์ใหญ่ Artificial Intelligence มันคือ “ชั้นไฟฟ้า” ของโครงข่าย — ส่งข้อมูลด้วยสัญญาณไฟฟ้าผ่านชิปและทองแดง ส่วนพี่น้องข้างกันคือ Optical Interconnect & DCI ที่ดูแล “ชั้นแสง” (แปลงข้อมูลเป็นแสงยิงผ่านเส้นใยแก้วเมื่อต้องส่งไกล) — สวิตช์ตัดสินใจว่าข้อมูลไปทางไหน แสงเป็นคนลำเลียงมันไปจริงเมื่อระยะไกลขึ้น
Switch ASIC = ชิปเฉพาะทางที่เป็นแกนของสวิตช์ · SerDes (Serializer/Deserializer) = วงจรเล็กๆ ที่รับ-ส่งข้อมูลผ่านสายหนึ่งช่อง ยิ่งเร็วต่อช่อง (100G → 200G) ชิปยิ่งแรง · Radix = จำนวนพอร์ตที่สวิตช์ตัวเดียวต่อได้ ยิ่ง radix สูง ยิ่งใช้สวิตช์น้อยตัวก็ร้อย GPU ได้มาก = สายสั้นลง หน่วงน้อยลง ค่าไฟลดลง
02ทำไมถึงสำคัญ — “เครือข่ายคือคอมพิวเตอร์”
มีประโยคหนึ่งที่กลายเป็นความจริงทางวิศวกรรมของยุค AI: “the network is the computer” เหตุผลอยู่ที่วิธีฝึกโมเดล — โมเดลใหญ่ตัวหนึ่งถูกฝึกบน GPU หลายหมื่นตัวพร้อมกัน และในทุกๆ สเตปของการฝึก GPU ทุกตัวต้องเอาผลคำนวณของตัวเองมา “เฉลี่ยรวม” กับเพื่อนทุกตัว (ขั้นตอนที่เรียกว่า all-reduce) ก่อนจะไปสเตปถัดไป แปลว่าถ้าสวิตช์ช้าหรือติดขัดแม้แต่นิดเดียว GPU ราคาตัวละหลายหมื่นดอลลาร์ทั้งคลัสเตอร์ ต้องหยุดรอพร้อมกัน
นี่คือเหตุผลที่คลัสเตอร์ AI ถูกเรียกว่า “network-bound” — เพดานความเร็วไม่ได้อยู่ที่ชิปคำนวณเร็วแค่ไหน แต่อยู่ที่ว่ามันแลกข้อมูลกันได้เร็วแค่ไหน ตัวเลขช่วยให้เห็นภาพ: คลัสเตอร์ GPU แค่ 1,000 ตัว ต้องการโครงข่ายแบบ ไม่มีคอขวด (non-blocking) ที่รองรับการส่งข้อมูลแบบทุกตัวคุยทุกตัว (all-to-all) รวมกันได้เกิน 400 Tbps โดยแทบไม่มีแพ็กเก็ตหล่นหาย และความหน่วงต้องนิ่งระดับไมโครวินาที — งานแบบนี้ไม่เคยมีในเครือข่ายดาต้าเซ็นเตอร์ยุคก่อน AI
ผลทางเศรษฐกิจตามมาทันที เครือข่ายเคยเป็นแค่ “ส่วนเสริมเล็กๆ” ของศูนย์ข้อมูล แต่ในคลัสเตอร์ AI มันกลายเป็นรายจ่ายก้อนใหญ่ที่โตเร็วที่สุดส่วนหนึ่ง Dell'Oro Group ประเมินว่าเม็ดเงินที่ลงไปกับสวิตช์สำหรับ โครงข่ายหลังบ้านของ AI (AI back-end) จะทะลุ $100,000 ล้านต่อปีภายในปี 2030 และเฉพาะตลาด “ชิปสวิตช์” (switch silicon) อย่างเดียว — ก่อนจะประกอบเป็นกล่อง — ก็มีมูลค่าราว $3,800 ล้านในปี 2025 แล้ว
03มันทำงานยังไง (leaf/spine fabric)
หัวใจของการมัด GPU หมื่นตัวให้คุยกันได้ทั่วถึง คือโครงสร้างที่เรียกว่า leaf/spine (หรือ fat-tree) — แทนที่จะลากสายจาก GPU ทุกตัวถึงกันโดยตรง (ซึ่งเป็นไปไม่ได้เมื่อมีหลายหมื่นตัว) เราวางสวิตช์เป็นสองชั้น แล้วให้ข้อมูลวิ่งผ่านชั้นกลาง
ชั้นล่างคือ leaf switch — สวิตช์ที่ GPU เสียบตรงเข้าไป แต่ละ leaf ดูแล GPU กลุ่มหนึ่ง ชั้นบนคือ spine switch — สวิตช์ที่เชื่อม leaf ทุกตัวเข้าด้วยกัน เวลาที่ GPU ตัวหนึ่งจะส่งข้อมูลถึง GPU อีกตัวที่อยู่คนละ leaf ข้อมูลวิ่งแค่ สองช่วง: leaf → spine → leaf เสมอ ไม่ว่า GPU สองตัวนั้นจะอยู่ห่างกันแค่ไหน — นั่นทำให้ความหน่วง “นิ่ง” และคาดเดาได้ ซึ่งสำคัญมากตอน all-reduce
จุดที่ทำให้ชิปสวิตช์ “ยาก” คือคำว่า non-blocking (ไม่มีคอขวด) — โครงข่ายต้องออกแบบให้ทุก GPU ส่งข้อมูลเต็มความเร็วถึง GPU ตัวไหนก็ได้พร้อมกัน โดยชั้น spine ต้องมีแบนด์วิดท์ลงมารองรับเท่ากับที่ leaf รับเข้า (อัตราส่วน 1:1) ยิ่งชิปสวิตช์ตัวเดียวรับส่งได้กว้าง (radix สูง) ยิ่งใช้สวิตช์น้อยตัวก็สร้าง fabric แบบนี้ได้ — แปลว่าสายสั้นลง สวิตช์น้อยลง หน่วงน้อยลง และค่าไฟลดลง นี่คือเหตุผลที่ “ความกว้างของชิปตัวเดียว” กลายเป็นสนามแข่งสำคัญ
มีอีกชั้นที่ต้องไม่สับสน: การเชื่อม GPU ที่อยู่ ในแร็คเดียวกัน ให้เร็วสุดขีด (เรียก scale-up — Nvidia ใช้ NVLink) ต่างจากการเชื่อม ข้ามแร็ค เป็นคลัสเตอร์ใหญ่ (เรียก scale-out — ใช้ InfiniBand/Ethernet) leaf/spine ที่เราเพิ่งดูคือชั้น scale-out — และมันคือสมรภูมิหลักของบทนี้
04มันเชื่อมกับอะไรในระบบนิเวศ
ชั้นสวิตช์ไม่ได้ทำงานเดี่ยวๆ มันคือข้อต่อที่ร้อยหลายเทรนด์เข้าด้วยกัน
- มัด GPU / AI accelerator ให้เป็นเครื่องเดียว: นี่คือความสัมพันธ์ที่ลึกที่สุด GPU จะเก่งแค่ไหนก็ไร้ค่าถ้าคุยกันไม่ได้ — ดีมานด์ของสวิตช์จึงผูกกับยอดขาย GPU โดยตรง ยิ่งซื้อ GPU มาก ยิ่งต้องซื้อสวิตช์ตาม
- คู่กับ Optical Interconnect เสมอ: สวิตช์ตัดสินใจว่าข้อมูลไปทางไหน (ชั้นไฟฟ้า) แต่เมื่อต้องส่งไกลเกินกว่าทองแดงจะไหว ต้องแปลงเป็นแสง (ชั้นแสง) — สองชั้นนี้ต้องเร็วขึ้นพร้อมกัน ไม่งั้นอีกฝั่งกลายเป็นคอขวด และเส้นแบ่งกำลังเลือนลงด้วย co-packaged optics ที่เอาแสงไปติดกับชิปสวิตช์เลย
- เป็นชิ้นส่วนของ เซิร์ฟเวอร์/แร็ค AI: สวิตช์ leaf จำนวนมากถูกติดตั้งระหว่างประกอบแร็คและคลัสเตอร์ — มันคือชิ้นส่วนมาตรฐานที่ขาดไม่ได้ในทุกการสร้างศูนย์ข้อมูล AI
- พึ่ง เซมิคอนดักเตอร์: switch ASIC ก็คือชิปที่ต้องผลิตในโรงหล่อขั้นสูง (TSMC) — ชิปสวิตช์รุ่นบนๆ ใช้เทคโนโลยีระดับเดียวกับ GPU
- กิน พลังงาน มหาศาล: สวิตช์ความเร็วสูงและ SerDes กินไฟมาก — นี่คือเหตุผลที่ radix สูงและ co-packaged optics สำคัญ เพราะช่วยลดพลังงานต่อบิตได้
05ตอนนี้ไปถึงไหนแล้ว (2025–2026)
เรื่องใหญ่ที่สุดของวงการนี้ในปี 2025 คือ Ethernet พลิกแซง InfiniBand ขึ้นเป็นโครงข่าย scale-out หลักของ AI เป็นครั้งแรก ย้อนไปแค่สองปีก่อน InfiniBand เคยครองยอดขายสวิตช์หลังบ้านของ AI ถึงราว 80% เพราะมันเสถียรและหน่วงต่ำ แต่พอถึงไตรมาส 4 ปี 2025 Ethernet กลับกินสัดส่วนไปแล้ว กว่าสองในสาม ของยอดขายสวิตช์ในคลัสเตอร์ AI — Dell'Oro รายงานว่า Ethernet มีขนาดตลาด “มากกว่าสองเท่า” ของ InfiniBand สำหรับงาน scale-out ในปีนั้น
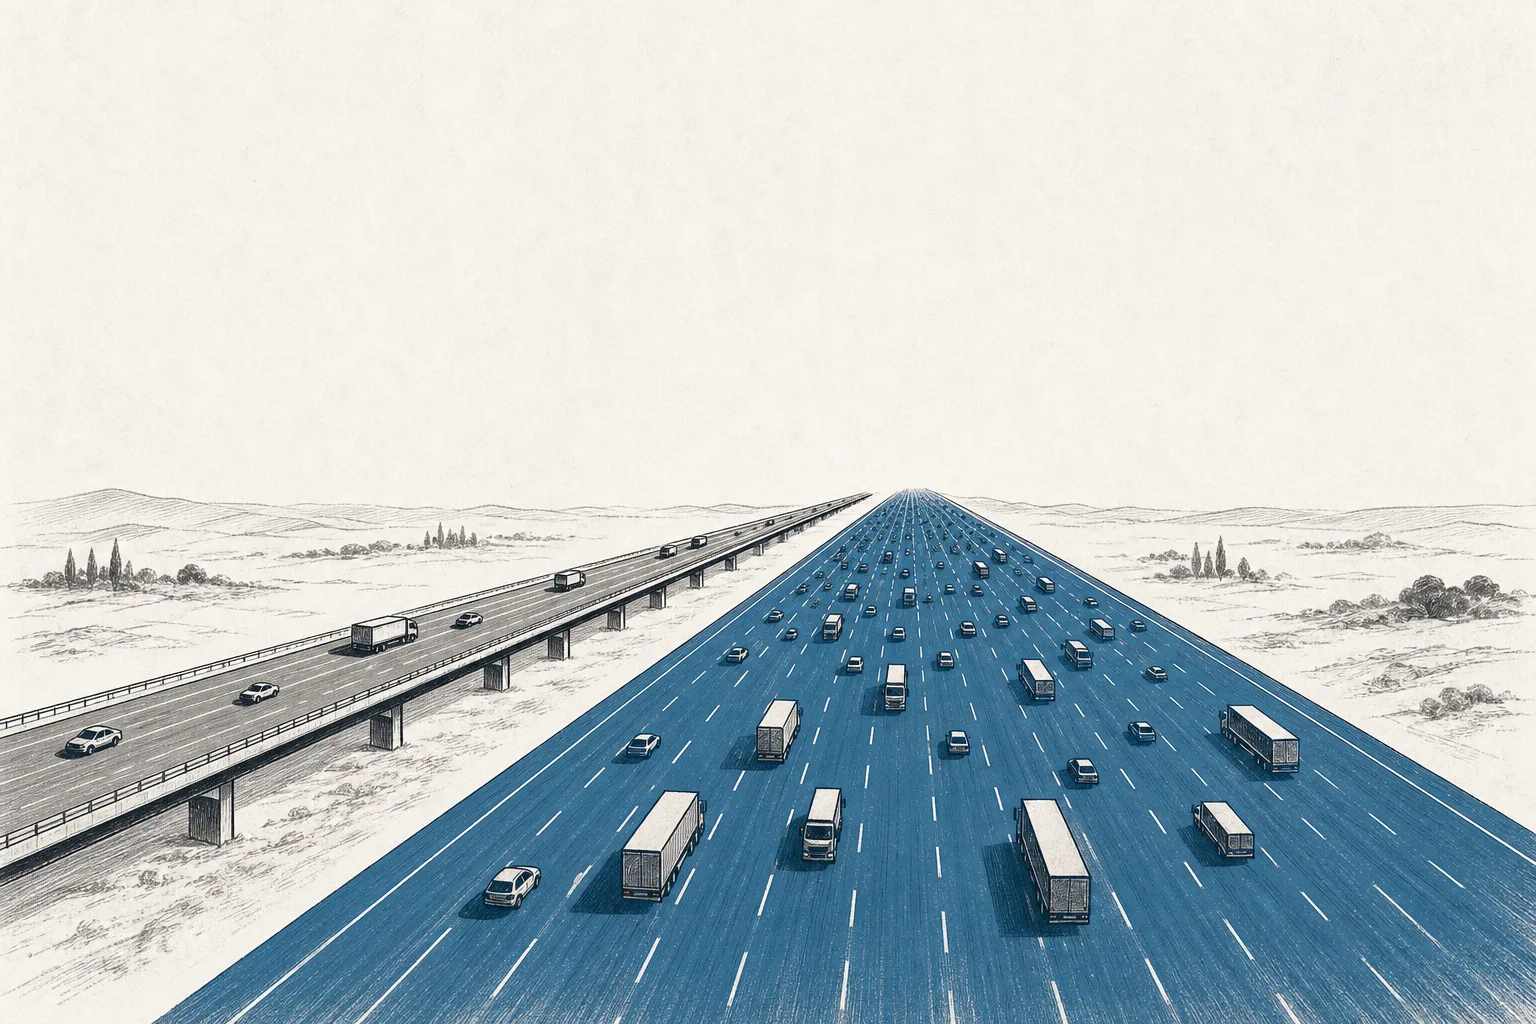
ทำไมถึงพลิก? เพราะ hyperscaler รายใหญ่ไม่อยากผูกกับเจ้าเดียว — Amazon, Microsoft, Meta, Oracle และ xAI ต่างหันมาใช้ Ethernet ที่เป็นมาตรฐานเปิด ถูกกว่า และมีผู้ขายหลายราย คนที่ได้อานิสงส์เต็มๆ คือ Broadcom เจ้าตลาดชิปสวิตช์ ที่กลางปี 2025 เปิดตัวชิป Tomahawk 6 ทำความเร็วได้ถึง 102.4 Tbps ในชิปตัวเดียว (เป็นเท่าตัวของรุ่นก่อน รองรับพอร์ต 1.6T ได้ 64 พอร์ต) และเข้าสู่การผลิตจริงต้นปี 2026 — เป็นชิปสวิตช์ตัวแรกของโลกที่แตะระดับนี้
แต่ Nvidia ไม่ยอมง่ายๆ — มันเลิกขายแค่ GPU แล้วขาย “ทั้งระบบ” รวมโครงข่ายของตัวเองทั้ง InfiniBand (จากการซื้อ Mellanox) และ Ethernet รุ่นใหม่ชื่อ Spectrum-X ที่ออกแบบมาสู้ Ethernet ฝั่ง Broadcom โดยเฉพาะ ในปี 2025 Spectrum-X เพียงรุ่นเดียวทำรายได้ทะลุระดับ run-rate กว่า $10,000 ล้านต่อปี และรายได้ฝั่งเครือข่ายทั้งหมดของ Nvidia แตะระดับ $8,000–11,000 ล้านต่อไตรมาส — โตกว่า 160% เทียบปีก่อน ส่วน Arista ที่เน้นขาย “ระบบสวิตช์” Ethernet ระดับไฮเอนด์ให้ cloud titans ก็ทำรายได้ทั้งปี 2025 ถึง $9,000 ล้าน (+29%) และตั้งเป้ารายได้เฉพาะ AI ปี 2026 ไว้ที่ $2,750 ล้าน
06อนาคตข้างหน้า — 1.6T และมาตรฐานเปิด
ทิศทางแรกคือ การไล่ความเร็วที่ไม่หยุด วันนี้มาตรฐานหลักคือพอร์ต 800G (ซึ่งทะลุ 20 ล้านพอร์ตภายในแค่ 3 ปีหลังเริ่มส่งของ) และรุ่นถัดไป 1.6T กำลังไหลเข้าตลาด ชิปอย่าง Tomahawk 6 ออกแบบมารองรับ 1.6T โดยตรงแล้ว ทุกครั้งที่ความเร็วต่อช่องเพิ่ม ทองแดงยิ่งหมดสภาพเร็วขึ้น (ยิ่งเร็วยิ่งร้อนและส่งได้ใกล้ลง) ทำให้ชั้นสวิตช์กับ ชั้นแสง ยิ่งต้องหลอมรวมกันผ่าน co-packaged optics (CPO) — เอาเลเซอร์ไปติดข้างชิปสวิตช์เลย ปี 2026 ถูกมองว่าเป็นปีแรกที่ CPO เริ่มผลิตจริงทั้งบน Ethernet และ InfiniBand
ทิศทางที่สองคือ มาตรฐานเปิดจะกินส่วนแบ่งต่อ ค่าย Ethernet รวมตัวกันเป็น Ultra Ethernet Consortium และออกสเปก 1.0 กลางปี 2025 เพื่อปรับ Ethernet ให้หน่วงต่ำและไม่ทำแพ็กเก็ตหล่นพอจะสู้ InfiniBand ได้ในงาน AI โดยตรง Dell'Oro คาดว่ารายได้สวิตช์ AI back-end จะทะลุ $100,000 ล้านต่อปีภายในปี 2030 โดยส่วนใหญ่เป็น Ethernet — แต่ InfiniBand จะไม่หายไป มันยังครองงานที่ต้องการความหน่วงต่ำสุดและความแน่นอนสูงสุด (คลัสเตอร์ฝึกระดับ frontier)
ทิศทางที่สามคือ สมรภูมิรอบใหม่ที่ชั้น scale-up วันนี้การเชื่อม GPU ในแร็คเดียว (scale-up) เป็นของ Nvidia เจ้าเดียวผ่าน NVLink แต่กำลังมีความพยายามดัน Ethernet ลงมาเล่นในชั้นนี้ด้วย (เช่นมาตรฐาน scale-up แบบเปิด) ถ้าสำเร็จ มันจะเปิดสนามให้ Broadcom, Marvell และผู้เล่นชิปสวิตช์รายอื่นเข้ามาแข่งในชั้นที่ Nvidia เคยผูกขาด — เป็นชั้นที่มูลค่าต่อพอร์ตสูงที่สุดของทั้งคลัสเตอร์
07ความท้าทายและความเสี่ยง
ความเสี่ยงข้อแรกคือ Nvidia ครองแนวตั้ง เพราะ Nvidia คุมทั้ง GPU และโครงข่าย มันสามารถ “ขายเป็นแพ็กเกจ” แล้วล็อกลูกค้าให้ซื้อสวิตช์ของตัวเองไปพร้อมชิป — ทำให้ผู้เล่นที่ขายแต่สวิตช์ (Broadcom, Arista) ต้องสู้กับแรงดึงให้ลูกค้าอยู่ในระบบปิดของ Nvidia แม้ Ethernet จะแซงในภาพรวม แต่ในคลัสเตอร์ที่ใช้ GPU Nvidia ล้วน การแทรกเข้าไปก็ยากขึ้น
ความเสี่ยงข้อสองคือ สงครามมาตรฐานที่ยังไม่จบ ศึก InfiniBand vs Ethernet, การเปิด scale-up, และการมาของ CPO หมายความว่าผู้นำวันนี้อาจถูกมาตรฐานหรือสถาปัตยกรรมใหม่ดิสรัปต์ได้ การเดิมพันผิดมาตรฐานในธุรกิจที่เปลี่ยนเร็วและลงทุน R&D หนักแบบนี้ มีราคาแพงมาก
ความเสี่ยงข้อสามคือ การผูกกับวงจรลงทุน AI และลูกค้าไม่กี่ราย ดีมานด์ของสวิตช์ผูกกับการสร้างคลัสเตอร์ GPU โดยตรง และลูกค้าก้อนใหญ่ก็มีแค่ไม่กี่ราย (กลุ่ม hyperscaler) ถ้าการลงทุน AI ชะลอลง หรือมีช่วง “ลงทุนเกิน” ออเดอร์สวิตช์ก็สะดุดทันที — เป็นธุรกิจที่โตเร็วมากในขาขึ้น แต่อ่อนไหวต่อจังหวะการใช้จ่ายของลูกค้าหยิบมือ
สรุปสั้นๆ: node นี้คือชั้นที่เคยถูกมองว่าเป็นแค่ “สายกับกล่อง” แต่กลายเป็นหนึ่งในคอขวดและสมรภูมิสำคัญที่สุดของยุค AI — เพราะ GPU ที่แพงที่สุดในโลกจะไร้ค่าทันที ถ้าไม่มีสวิตช์ที่กว้างและเร็วพอจะร้อยมันเข้าด้วยกัน ส่วนการลำเลียงข้อมูลระยะไกลด้วยแสง อ่านต่อได้ที่บทพี่น้อง Optical Interconnect & DCI