Megatrend · Artificial Intelligence
เมื่อสายไฟกับสวิตช์ คือสิ่งที่ทำให้ GPU หมื่นตัวกลายเป็นสมองก้อนเดียว
ทุกคนพูดถึง GPU ราคาแพง แต่ความจริงที่คนมองข้ามคือ — การฝึก AI ตัวหนึ่งต้องใช้ GPU หลายหมื่นตัวทำงานพร้อมกัน และทุกๆ เสี้ยววินาที พวกมันต้อง “คุยกัน” ด้วยข้อมูลมหาศาล ถ้าสายเชื่อมช้าไปนิดเดียว GPU ที่แพงที่สุดในโลกก็ได้แต่นั่งรอ บทเรียนนี้พาไปดูชั้นของสายและสวิตช์ที่มัด GPU ทั้งคลัสเตอร์ให้เป็นเครื่องเดียว — และสมรภูมิเงินแสนล้านดอลลาร์ระหว่าง Nvidia กับ Broadcom ที่กำลังเดือดอยู่บนนั้น
01มันคืออะไร (เครือข่ายคือคอมพิวเตอร์)
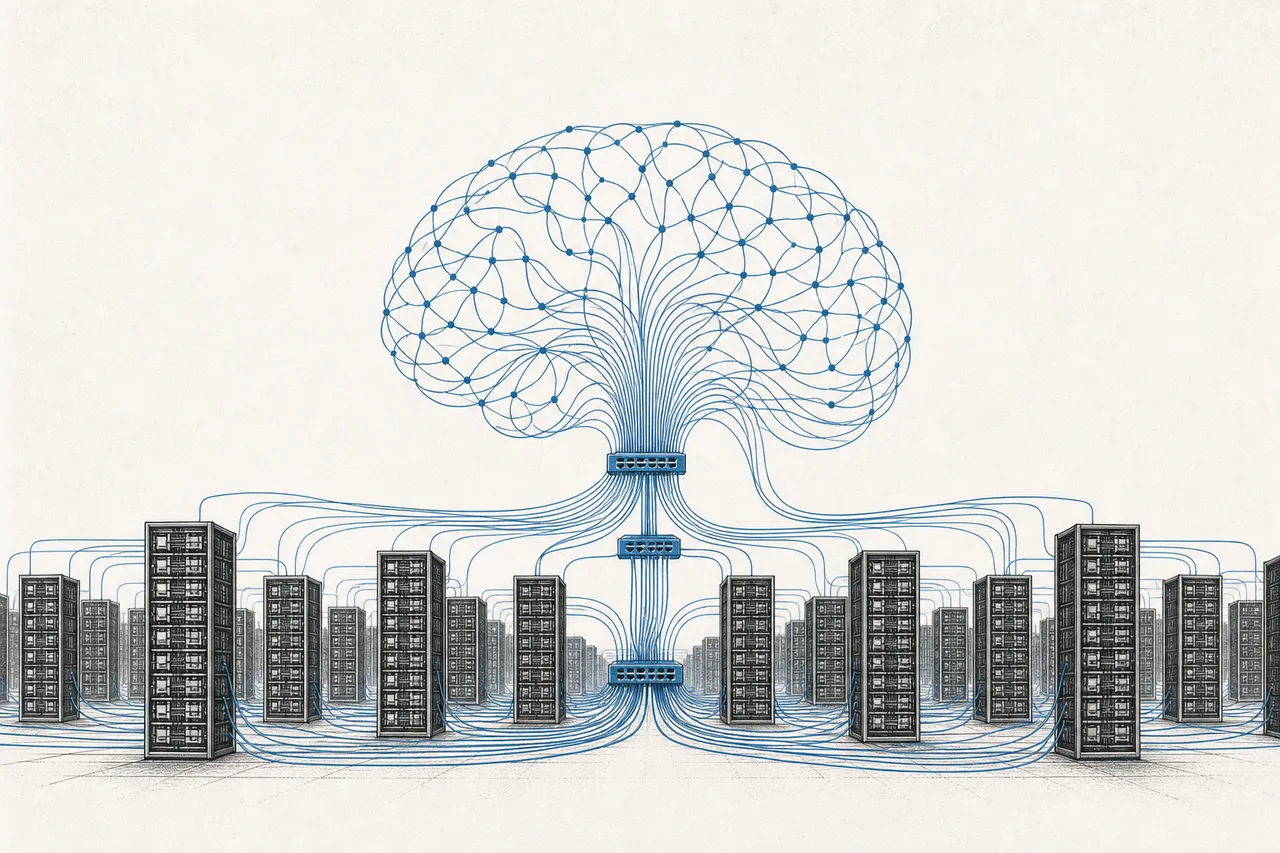
เวลาเราได้ยินคำว่า “ฝึกโมเดล AI” เรามักนึกภาพคอมพิวเตอร์เครื่องเดียวที่ทรงพลังมากๆ ความจริงไม่ใช่เลย — โมเดลใหญ่ๆ อย่าง GPT หรือ Gemini ถูกฝึกบน GPU หลายหมื่นตัวที่ทำงานพร้อมกัน แต่ปัญหาคือ GPU แต่ละตัวเห็นข้อมูลแค่เสี้ยวเดียว มันจึงต้องเอาผลลัพธ์มา “รวมกัน” กับเพื่อนๆ ตลอดเวลา และนี่คือจุดที่ AI Networking & Interconnect เข้ามา
node นี้คือเรื่องของ สายและสวิตช์ที่มัด GPU ทั้งคลัสเตอร์ให้กลายเป็นคอมพิวเตอร์เครื่องเดียว — ทั้งสวิตช์ที่กระจายข้อมูล (switching) และเส้นใยแก้วนำแสงที่ลำเลียงข้อมูลด้วยความเร็วแสง (optical) ในวงการมีประโยคติดปากว่า “the network is the computer” — สำหรับ AI วันนี้มันไม่ใช่คำเปรียบเปรยอีกต่อไป แต่เป็นความจริงทางวิศวกรรม
Interconnect = ระบบเชื่อมต่อที่ทำให้ชิปหลายตัวคุยกันได้ · Fabric (โครงข่าย) = ภาพรวมของสาย + สวิตช์ทั้งหมดที่ถักทอ GPU เข้าด้วยกันเหมือนผืนผ้า ยิ่งโมเดลใหญ่ ผืนผ้านี้ยิ่งต้องกว้างและไร้รอยสะดุด เพราะ GPU ตัวเดียวที่ “รอข้อมูล” ก็ฉุดทั้งคลัสเตอร์ให้ช้าลง
ในแผนผังเมกะเทรนด์ node นี้เป็นสาขาย่อยภายใต้ Artificial Intelligence นั่งเป็น “ชั้นโครงสร้างพื้นฐาน” คู่กับพี่น้องอย่าง ชิปประมวลผล AI และ ไฟและการระบายความร้อน ถ้าชิปคือ “สมอง” เครือข่ายก็คือ “เส้นประสาท” ที่ทำให้สมองหลายก้อนคิดเป็นหนึ่งเดียวได้
02ทำไมเครือข่ายถึงกลายเป็นคอขวด
เพื่อจะเข้าใจว่าทำไมเครือข่ายถึงสำคัญขนาดนี้ ต้องเข้าใจวิธีฝึก AI ก่อน การฝึกโมเดลคือการทำซ้ำ “หนึ่งสเตป” นับล้านครั้ง และในทุกสเตป GPU ทุกตัวต้องคำนวณค่าปรับ (gradient) ของตัวเอง แล้ว เอามาเฉลี่ยรวมกับ GPU ทุกตัวในคลัสเตอร์ ก่อนจะไปสเตปถัดไป ขั้นตอนการรวมนี้เรียกว่า all-reduce และมันเกิดขึ้นทุกสเตป — แปลว่าถ้าเครือข่ายช้า GPU ทั้งหมดก็ต้องหยุดรอพร้อมกัน
นี่คือเหตุผลที่วงการพูดว่าคลัสเตอร์ AI นั้น “network-bound” — เพดานความเร็วไม่ได้อยู่ที่ว่าชิปคำนวณได้เร็วแค่ไหน แต่อยู่ที่ว่ามัน “แลกเปลี่ยนข้อมูล” กันได้เร็วแค่ไหน มีการประเมินว่าในงานฝึกโมเดลขนาดใหญ่ การรอเครือข่ายอาจกินเวลาไปถึง ~40% ของแต่ละสเตป นั่นหมายถึง GPU ที่ราคาตัวละหลายหมื่นดอลลาร์อาจนั่งว่างเกือบครึ่งเวลา ถ้าโครงข่ายไม่ดีพอ
ผลทางเศรษฐกิจตามมาทันที เครือข่ายเคยเป็นแค่ “ส่วนเสริมเล็กๆ” ของศูนย์ข้อมูล แต่ในคลัสเตอร์ AI มันกลายเป็นรายจ่ายก้อนใหญ่ที่ประเมินกันว่าราว 10–20% ของต้นทุนคลัสเตอร์ทั้งหมด — และเป็นส่วนที่โตเร็วที่สุดส่วนหนึ่ง ในนิยามแคบ (เฉพาะ “ตัวระบบสวิตช์ศูนย์ข้อมูล AI” ตามประมาณการของ ResearchAndMarkets) ตลาดนี้ถูกประเมินว่าจะโตจาก $4,000 ล้านในปี 2024 เป็น $19,000 ล้านในปี 2030 (โตเฉลี่ย ~30% ต่อปี) — แต่ถ้านับ การใช้จ่ายด้านสวิตช์ back-end ของ AI ทั้งหมด ตัวเลขจะใหญ่กว่านี้มาก โดยอาจแตะราว $100,000 ล้านภายในปี 2030 (Dell'Oro — ดู ชั้นสวิตช์) และนี่ยังไม่รวมฝั่งแสงและสายอีก
03มันทำงานยังไง — scale-up กับ scale-out
โครงข่าย AI ไม่ได้มีชั้นเดียว แต่มีสองชั้นที่ทำงานคนละหน้าที่ — และเข้าใจความต่างของสองชั้นนี้ คือเข้าใจทั้งเทรนด์
ชั้นแรกเรียกว่า scale-up คือการเชื่อม GPU ที่อยู่ “ในแร็คเดียวกัน” ให้เร็วสุดขีดเหมือนเป็นชิปเดียว เทคโนโลยีพระเอกคือ NVLink ของ Nvidia — GPU Blackwell หนึ่งตัวมีสาย NVLink ถึง 18 เส้น รวมแบนด์วิดท์ 1.8 TB/s (เร็วกว่าช่อง PCIe ทั่วไปราว 14 เท่า) ระบบรุ่นใหม่อย่าง GB200 NVL72 มัด GPU 72 ตัวในแร็คเดียวให้เป็น “โดเมนเดียว” ที่มีแบนด์วิดท์รวม 130 TB/s — เหมือนยัด GPU 72 ตัวให้กลายเป็นชิปยักษ์ตัวเดียว
ชั้นที่สองเรียกว่า scale-out คือการเชื่อม “ข้ามแร็ค” เพื่อมัดหลายร้อยหลายพันแร็คเข้าด้วยกันเป็นคลัสเตอร์ขนาดหมื่นตัว ชั้นนี้ใช้เทคโนโลยีคนละแบบ — InfiniBand หรือ Ethernet — และมันคือสมรภูมิที่ดุเดือดที่สุดของเทรนด์นี้ (เดี๋ยวเราจะกลับมาที่ศึกนี้)
ทำไมต้องแยกสองชั้น? เพราะ scale-up เร็วกว่ามาก — NVLink ภายในแร็คเร็วกว่าโครงข่าย scale-out ข้ามแร็คราว 18 เท่า ดังนั้นวิศวกรจึงพยายาม “ยัด” GPU ให้อยู่ในโดเมน scale-up เดียวกันให้มากที่สุด (จาก 8 ตัวต่อโหนด สู่ 72 ตัวต่อแร็ค และกำลังไปถึง 576 ตัว) เพราะทุกครั้งที่ข้อมูลต้องวิ่งออกไปชั้น scale-out มันคือการ “เสียเวลา” แบบหนึ่ง
คือการ “รวมแล้วเฉลี่ย” ค่าจาก GPU ทุกตัว แล้วส่งผลลัพธ์กลับให้ทุกตัวเท่ากัน — เกิดทุกสเตปของการฝึก ยิ่ง GPU เยอะ การ all-reduce ยิ่งหนัก นี่คือเหตุผลที่ “แบนด์วิดท์” (ส่งได้กว้างแค่ไหน) และ “latency” (หน่วงแค่ไหน) ของเครือข่าย กลายเป็นตัวกำหนดความเร็วในการฝึก AI โดยตรง
04สองชั้นของเทรนด์นี้ (สวิตช์ + แสง)
ถ้ามองเป็นธุรกิจ เทรนด์นี้แตกเป็นสองก้อนที่พึ่งพากัน — และทั้งคู่กำลังเฟื่องฟูพร้อมกัน
ก้อนแรกคือ สวิตช์และชิปสวิตช์ (Switching & Networking Silicon/Systems) — นี่คือ “ทางแยกจราจร” ของข้อมูล สวิตช์รับข้อมูลจากสายนับร้อยเส้นแล้วส่งต่อไปถูกทิศทาง หัวใจอยู่ที่ ชิปสวิตช์ (switch ASIC) ที่กำหนดว่าสวิตช์หนึ่งตัวจะรับส่งข้อมูลได้กว้างแค่ไหน ชิปสวิตช์รุ่นล่าสุดเร็วขึ้นเท่าตัวทุกรุ่น นี่คือสนามที่ Broadcom และ Arista กำลังชนกัน (เจาะลึกผู้เล่นและสเปกที่ → ชั้นสวิตช์)
ก้อนที่สองคือ การเชื่อมต่อด้วยแสง (Optical Interconnect & DCI) — เมื่อต้องส่งข้อมูลไกลขึ้นและเร็วขึ้น ทองแดง (สายไฟ) เริ่มไม่ไหว เพราะยิ่งเร็วยิ่งร้อนและส่งได้ไม่ไกล โลกจึงเปลี่ยนไปใช้ แสง — แปลงข้อมูลเป็นสัญญาณแสงยิงผ่านเส้นใยแก้ว ตัวแปลงนี้เรียกว่า optical transceiver และดีมานด์มันระเบิดมาก ตลาด transceiver ทั้งหมดแตะกว่า $23,000 ล้านในปี 2025 (โต ~50% ในปีเดียว) หัวใจคือกำแพงฟิสิกส์ — ที่ 200G ต่อเลน ทองแดงส่งได้ไม่ถึง 1 เมตร แสงจึงเป็นทางเดียวที่สเกลต่อได้ และมูลค่ากระจุกที่ “เลเซอร์ต้นน้ำ” ฝั่งตะวันตกมากกว่าตัวโมดูลที่จีนตีตลาด (ดู → ชั้นแสง)
node นี้จึงเป็น “เรื่องเดียวกันสองด้าน” — สวิตช์คือสมองที่ตัดสินใจว่าข้อมูลไปทางไหน ส่วนแสงคือเส้นเลือดที่ลำเลียงมันไปจริงๆ ทั้งคู่ต้องวิ่งเร็วขึ้นพร้อมกัน ไม่งั้นอีกฝั่งก็กลายเป็นคอขวด
05มันเชื่อมกับอะไร
AI Networking ไม่ได้ลอยอยู่เดี่ยวๆ มันคือชั้นที่ “ร้อย” เทรนด์อื่นเข้าด้วยกัน:
- มัด ชิปประมวลผล AI ให้เป็นเครื่องเดียว: นี่คือความสัมพันธ์ที่ลึกที่สุด GPU ที่เก่งแค่ไหนก็ไร้ความหมายถ้ามันคุยกันไม่ได้ ดีมานด์ของ node นี้จึงผูกกับยอดขาย GPU โดยตรง — ยิ่งซื้อ GPU มาก ยิ่งต้องซื้อสายและสวิตช์มากตาม
- เป็นส่วนหนึ่งของ การสร้างศูนย์ข้อมูล AI: สวิตช์ สาย และ transceiver คือชิ้นส่วนที่ถูกติดตั้งระหว่างการสร้างคลัสเตอร์ขนาดยักษ์
- ดูด ไฟฟ้า มหาศาล: โครงข่ายความเร็วสูงกินไฟมาก — นี่คือเหตุผลที่ co-packaged optics (เอาแสงไปไว้ติดชิปเลย) สำคัญ เพราะช่วยลดพลังงานได้หลายสิบเมกะวัตต์ต่อคลัสเตอร์
- พึ่ง เซมิคอนดักเตอร์ และ Interconnect & passive: ชิปสวิตช์ก็คือชิปที่ต้องผลิตในโรงหล่อ ส่วนสาย คอนเนกเตอร์ และซับสเตรตขั้นสูง คือชิ้นส่วนทางกายภาพที่ต้องมาประกอบกัน
- พึ่ง วัตถุดิบสำคัญ: ตั้งแต่ทองแดงคุณภาพสูงไปจนถึงวัสดุทำเส้นใยแก้วและเลเซอร์ในตัว transceiver
06สมรภูมิตอนนี้ (2025–2026)
นี่คือส่วนที่ดราม่าที่สุด — สงครามชิงโครงข่าย AI ระหว่างสองค่ายใหญ่ที่เดิมพันกันเป็นเงินแสนล้านดอลลาร์
ฝั่งหนึ่งคือ Nvidia ที่ไม่ได้ขายแค่ GPU แต่ขาย “ทั้งระบบ” — รวมถึงโครงข่ายของตัวเองทั้ง InfiniBand (จากการซื้อ Mellanox) และ NVLink สำหรับ scale-up InfiniBand เคยครอง back-end ของคลัสเตอร์ AI ถึงราว 80% เพราะมันเสถียรและหน่วงต่ำ Nvidia จึงพยายาม “ล็อก” ลูกค้าให้ซื้อทั้งชิปและเครือข่ายเป็นแพ็กเกจเดียว
อีกฝั่งคือพันธมิตร Ethernet นำโดย Broadcom (ชิปสวิตช์) และ Arista (ระบบสวิตช์) ที่ผลักดันมาตรฐานเปิดชื่อ Ultra Ethernet (สเปก 1.0 ออกกลางปี 2025) เพื่อทำให้ Ethernet ซึ่งเป็นเทคโนโลยีมาตรฐานเปิด เร็วและเสถียรพอจะสู้ InfiniBand ได้ — จุดขายคือ “ไม่ต้องผูกกับเจ้าเดียว และถูกกว่า”
และในปี 2025 กระแสก็พลิก — Ethernet แซง InfiniBand ขึ้นเป็นโครงข่าย scale-out หลักของ AI เป็นครั้งแรก โดยมีรายงานว่า Ethernet มีขนาดตลาดเป็นกว่า 2 เท่าของ InfiniBand สำหรับงาน scale-out ในปีนั้น — พลิกจากที่ InfiniBand เคยครอง ~80%
ตัวเลขของผู้เล่นเล่าเรื่องได้ชัด Broadcom กลายเป็นผู้ชนะเงียบๆ ของยุคนี้ — ในไตรมาส 4 ปีงบ 2025 รายได้ชิป AI โต 74% แตะระดับ record และฝั่งเครือข่ายโตถึง 170% จนคิดเป็นราว 40% ของรายได้ AI ทั้งหมด ส่วน Arista ก็ยกเป้ารายได้ AI ปี 2026 ขึ้นเป็น $2,750 ล้าน (จากเป้า $1,500 ล้านในปี 2025) พร้อม backlog ที่รอส่งมอบกว่า $6,800 ล้าน
ฝั่งแสงก็เดือดไม่แพ้กัน ดีมานด์ 800G ดันให้ผู้ผลิตจีนอย่าง Innolight และ Eoptolink คว้าออเดอร์เพิ่มของ Nvidia ไปรวมกันราว 60% ขณะที่ฝั่งตะวันตกอย่าง Coherent และ Lumentum ครองส่วนเลเซอร์และชิ้นส่วนต้นน้ำ และ Nvidia เองก็กระโดดลงสนามแสงด้วยสวิตช์ co-packaged optics รุ่น Quantum-X (ปลายปี 2025) และ Spectrum-X (ปี 2026)
07อนาคตข้างหน้า
ทิศทางแรกคือ “super-cycle ทองแดงสู่แสง” ยิ่งความเร็วต่อช่องสูงขึ้น (800G → 1.6T → 3.2T) ทองแดงยิ่งหมดสภาพ ทำให้แสงเข้ามาแทนในระยะที่สั้นลงเรื่อยๆ ปลายทางคือ co-packaged optics (CPO) — เอาเลเซอร์ไปไว้ติดกับชิปสวิตช์เลย เพื่อลดพลังงานและเพิ่มความเร็ว ปี 2026 ถูกมองว่าเป็นปีแรกของ CPO ระดับการผลิตจริง โดยมี Google, Meta, Amazon และ Nvidia นำร่อง — transceiver แบบเสียบ (pluggable) ยังไม่หายไป แต่เส้นทางชัดเจนว่ามุ่งสู่แสงมากขึ้นเรื่อยๆ
ทิศทางที่สองคือ Ethernet จะกินส่วนแบ่งต่อ ด้วยมาตรฐาน Ultra Ethernet ที่สุกงอมขึ้นและระบบนิเวศที่กว้างกว่า รายได้ Ethernet สำหรับ scale-out ของ AI ถูกคาดว่าจะทะลุ $100,000 ล้านต่อปีภายในปี 2030 แต่ InfiniBand จะไม่หายไป — มันยังครองงานที่ต้องการความหน่วงต่ำสุดและความแน่นอนสูงสุด (คลัสเตอร์ฝึกระดับ frontier, งานวิจัยแห่งชาติ)
ทิศทางที่สามคือ scale-up จะเปิดกว้างขึ้น วันนี้ NVLink เป็นของ Nvidia เจ้าเดียว แต่กำลังมีความพยายามสร้างมาตรฐาน scale-up แบบเปิด (เช่น การดัน Ethernet ลงมาเล่นในชั้น scale-up ด้วย) ถ้าสำเร็จ มันจะเปิดสนามให้ผู้เล่นอื่นเข้ามาแข่งในชั้นที่ Nvidia เคยผูกขาด — เป็นสมรภูมิรอบใหม่ที่กำลังก่อตัว
08ความท้าทายและความเสี่ยง
โครงข่าย AI เป็นเทรนด์ที่ร้อนแรง แต่มาพร้อมความเสี่ยงที่ต้องมองให้ขาด
ความเสี่ยงข้อแรกคือ การผูกกับวงจรลงทุน AI ดีมานด์ของ node นี้ผูกกับการสร้างคลัสเตอร์ GPU โดยตรง ถ้าการลงทุน AI ของกลุ่ม hyperscaler ชะลอลง (หรือถ้ามีช่วง “ลงทุนเกิน”) ออเดอร์สวิตช์และ transceiver ก็จะสะดุดตามทันที — นี่เป็นธุรกิจที่เติบโตเร็วมากในขาขึ้น แต่ก็อ่อนไหวต่อจังหวะการใช้จ่ายของลูกค้าไม่กี่ราย
ความเสี่ยงข้อสองคือ การแข่งขันด้านมาตรฐานที่ยังไม่จบ ศึก InfiniBand vs Ethernet และการเปิด scale-up หมายความว่าผู้นำวันนี้อาจถูกเทคโนโลยีหรือมาตรฐานใหม่ดิสรัปต์ได้ การเดิมพันผิดมาตรฐานในธุรกิจที่เปลี่ยนเร็วแบบนี้ มีราคาแพง
ความเสี่ยงข้อสามคือ ภูมิรัฐศาสตร์และซัพพลายเชนแสง โมดูลแสงราคาคุ้มส่วนใหญ่ผลิตในจีน (Innolight, Eoptolink) ขณะที่ลูกค้าหลักและชิปต้นน้ำอยู่ฝั่งสหรัฐฯ ความตึงเครียดทางการค้าหรือมาตรการควบคุมการส่งออก อาจกระทบทั้งราคาและการส่งมอบของชั้นที่กำลังขาดตลาดอยู่แล้ว
สรุปสั้นๆ: AI Networking คือชั้นที่เคยถูกมองข้ามว่าเป็นแค่ “สายไฟ” แต่จู่ๆ ก็กลายเป็นหนึ่งในคอขวดและสมรภูมิสำคัญที่สุดของยุค AI — เพราะ GPU ที่แพงที่สุดในโลกจะไร้ค่าทันที ถ้าไม่มีโครงข่ายที่เร็วพอจะร้อยมันเข้าด้วยกัน เข้าใจว่า “เครือข่ายคือคอมพิวเตอร์” คือเข้าใจว่าทำไมเงินแสนล้านดอลลาร์ถึงไหลเข้าสู่สายและสวิตช์ที่เราไม่เคยมองเห็น