Megatrend · Artificial Intelligence
เมื่อทองแดงพาข้อมูลไปไม่ถึง คลัสเตอร์ AI ก็เปลี่ยนมาคุยกันด้วย “แสง”
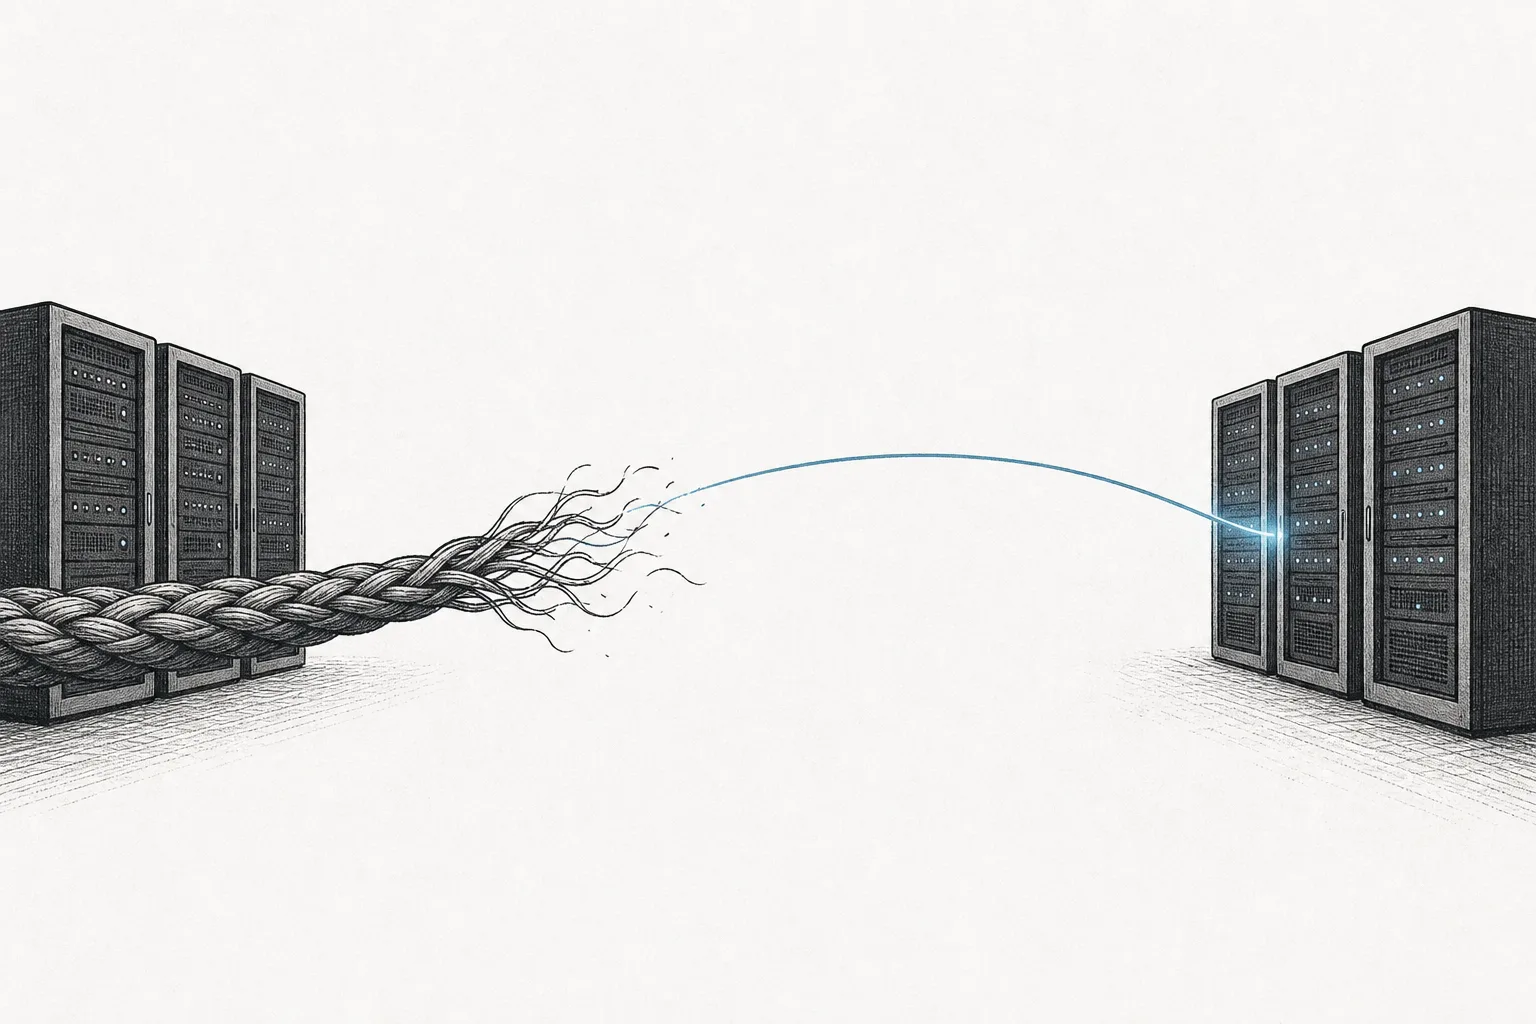
ที่ความเร็วระดับ 200 กิกะบิตต่อช่อง สายทองแดงส่งข้อมูลได้ไม่ถึงหนึ่งเมตรก็หมดแรง — สัญญาณจางหายและร้อนเกินไป แต่ GPU ในคลัสเตอร์ AI อยู่ห่างกันเป็นสิบเมตร คนละแร็ค คนละตึก กระทั่งคนละเมือง ทางออกเดียวที่สเกลต่อได้คือ เปลี่ยนอิเล็กตรอนให้กลายเป็นแสง ยิงผ่านเส้นใยแก้วแล้วแปลงกลับอีกฝั่ง ตัวแปลงนี้คือ optical transceiver — ชิ้นส่วนเล็กๆ ที่ตลาดพุ่งทะลุ $23,000 ล้านในปีเดียว และกำลังกลายเป็นคอขวดและขุมทรัพย์ใหม่ของยุค AI
01มันคืออะไร (เชื่อมต่อด้วยแสง)
ในคลัสเตอร์ AI ขนาดยักษ์ GPU หลายหมื่นตัวต้องคุยกันตลอดเวลา และพวกมันไม่ได้อยู่ติดกัน — ตัวที่อยู่คนละแร็คห่างกันหลายเมตร คนละแถวห่างกันหลายสิบเมตร คนละอาคารห่างกันเป็นกิโลเมตร คำถามคือ จะลำเลียงข้อมูลมหาศาลข้ามระยะพวกนี้ให้เร็วและประหยัดไฟได้ยังไง คำตอบคือ เลิกส่งด้วยกระแสไฟฟ้าในทองแดง แล้วเปลี่ยนไปส่งด้วยแสงในเส้นใยแก้ว
node นี้คือชั้นที่ทำหน้าที่นั้น — กลุ่มอุปกรณ์ที่ แปลงข้อมูลดิจิทัล (อิเล็กตรอน) ให้เป็นสัญญาณแสง (โฟตอน) ยิงผ่านไฟเบอร์ แล้วแปลงกลับเป็นไฟฟ้าที่ปลายทาง มีสามองค์ประกอบหลักที่ต้องรู้จัก: (1) Optical transceiver — โมดูลเสียบที่ทำหน้าที่แปลงไป-กลับ (มีเลเซอร์อยู่ข้างใน) · (2) Co-packaged optics (CPO) — รุ่นใหม่ที่ย้ายชุดแปลงแสงไปติดบน “แพ็กเกจ” เดียวกับชิปสวิตช์เลย เพื่อลดระยะทางที่ไฟฟ้าต้องวิ่ง · (3) Data-center interconnect (DCI) — การเชื่อมศูนย์ข้อมูลข้ามตึกหรือข้ามเมืองด้วยแสงระยะไกล
ในแผนผังเมกะเทรนด์ node นี้เป็นใบย่อยภายใต้ AI Networking & Interconnect ในเทรนด์ใหญ่ Artificial Intelligence มันยืนคู่กับพี่น้องอีกใบคือ Switching & Networking Silicon (ชิปสวิตช์ที่ตัดสินใจว่าข้อมูลไปทางไหน) — ถ้าสวิตช์คือ “สมองที่สั่งทิศ” node นี้ก็คือ “เส้นเลือดที่ลำเลียงเลือดไปจริงๆ ด้วยความเร็วแสง”
Transceiver = ตัวรับ-ส่ง (transmitter + receiver) ที่แปลงไฟฟ้า↔แสง ในตัวเดียว · CPO (co-packaged optics) = ย้ายชุดแปลงแสงเข้าไปอยู่ติดกับชิปสวิตช์บนแพ็กเกจเดียวกัน แทนที่จะเสียบเป็นโมดูลแยกที่หน้าเครื่อง · DCI (data-center interconnect) = การเชื่อมศูนย์ข้อมูลคนละตึก/คนละเมืองด้วยแสงระยะไกล (สิบ–พันกิโลเมตร) ใช้เทคนิคชื่อ coherent optics
02ทำไมสำคัญ — ทองแดงไปไม่ถึง
เรื่องนี้เริ่มจากกำแพงทางฟิสิกส์ที่หลีกเลี่ยงไม่ได้ ทองแดงส่งข้อมูลได้ดีในระยะสั้น แต่พอความเร็วต่อช่องสัญญาณไต่ขึ้นไปถึง 200 กิกะบิตต่อวินาทีต่อเลน (200G/lane) สัญญาณไฟฟ้าในทองแดงจะจางหายอย่างรวดเร็ว — ที่ความเร็วระดับนี้ สายทองแดงส่งข้อมูลได้ ไม่ถึงหนึ่งเมตร ก็แทบหมดสภาพ ยิ่งดันให้เร็วและไกลขึ้น ยิ่งร้อนและกินไฟมากขึ้นจนไม่คุ้ม
แต่ GPU ในคลัสเตอร์ AI ไม่ได้อยู่ห่างกันแค่เมตรเดียว — มันต้องคุยข้ามแร็ค ข้ามแถว ข้ามตึก ดังนั้นทุกครั้งที่ระยะหรือความเร็วเกินจุดที่ทองแดงไหว แสงคือทางเดียวที่สเกลต่อได้ เพราะแสงในเส้นใยแก้วเดินทางได้ไกลกว่ามาก เสียพลังงานน้อยกว่า และไม่ถูกรบกวนง่ายเหมือนสัญญาณไฟฟ้า นี่คือเหตุผลที่วงการเรียกช่วงนี้ว่า “การย้ายจากทองแดงสู่แสง” (copper-to-optical transition)
ผลทางเศรษฐกิจระเบิดทันที ตลาด optical transceiver ทั้งหมดแตะกว่า $23,000 ล้านในปี 2025 โต ~50% ในปีเดียว โดยมีดีมานด์ AI เป็นแรงขับหลัก เฉพาะฝั่งดาต้าคอม (ในศูนย์ข้อมูล) ทะลุ $16,000 ล้าน (+60%) และคาดว่าจะไต่ไปแตะราว $29,000 ล้านภายในปี 2029
ที่สำคัญกว่าขนาดคือ ความซ้ำ ของดีมานด์ — GPU หนึ่งตัวต้องการ transceiver หลายชิ้นเพื่อเชื่อมออกทุกทิศ ยิ่งคลัสเตอร์ใหญ่ขึ้นและความเร็วต่อช่องสูงขึ้น จำนวนชิ้นต่อ GPU ก็เพิ่ม ทำให้ดีมานด์ของ node นี้โตเร็วกว่ายอดขาย GPU เสียอีก สะท้อนชัดในจำนวนหน่วย: transceiver รุ่นเร็วกว่า 800G ส่งมอบราว 24 ล้านชิ้นในปี 2025 และคาดพุ่งเป็นเกือบ 63 ล้านชิ้นในปี 2026 — มากกว่าเดิม 2.6 เท่าในปีเดียว
03มันทำงานยังไง (อิเล็กตรอน → แสง)
หัวใจของ node นี้คือการ “แปลงร่าง” ข้อมูลสองครั้งในการเดินทางหนึ่งเที่ยว — จากไฟฟ้าเป็นแสงตอนออก และจากแสงกลับเป็นไฟฟ้าตอนถึง ลองไล่ดูทีละก้าวว่าข้อมูลหนึ่งก้อนเดินทางจาก GPU ฝั่งหนึ่งไปถึงอีกฝั่งได้ยังไง
จุดที่ทำให้ของพวกนี้ “ยาก” อยู่ที่หัวใจของทรานสซีฟเวอร์ คือ เลเซอร์แปลงสัญญาณ ที่เรียกว่า EML (externally modulated laser) เลเซอร์ตัวนี้ต้องกะพริบเปิด-ปิดได้เร็วระดับ 100 พันล้านครั้งต่อวินาที เพื่อเข้ารหัสข้อมูล 200G ลงในลำแสงเดียว มันผลิตจากวัสดุพิเศษชื่อ อินเดียมฟอสไฟด์ (Indium Phosphide) ที่ต้องใช้ความแม่นยำสูงมาก — ทั้งโลกมีบริษัทที่ทำเลเซอร์คุณภาพและปริมาณระดับนี้ได้แค่ไม่กี่ราย นี่คือ “คอขวดภายในคอขวด” ที่ทำให้ผู้ผลิตเลเซอร์ต้นน้ำมีอำนาจต่อรองสูงเป็นพิเศษ
EML = เลเซอร์ที่มีตัวปรับสัญญาณแยกในตัว ใช้เข้ารหัสข้อมูลความเร็วสูงลงในแสง (200G ต่อเลนคือมาตรฐานยุคนี้) · Silicon photonics = เทคนิคที่สร้าง “วงจรแสง” ลงบนชิปซิลิคอนเหมือนวงจรอิเล็กทรอนิกส์ ทำให้รวมหลายความยาวคลื่นลงในไฟเบอร์เส้นเดียวได้ และย่อขนาดชุดแปลงแสงให้เล็กลง — เป็นเทคโนโลยีหลักที่เปิดทางสู่ CPO
04มันอยู่ตรงไหนในวงการ
optical interconnect ไม่ได้ทำงานลำพัง มันคือชั้นที่ประกบกับชั้นอื่นในโครงข่าย AI อย่างแยกกันไม่ออก
- คู่กับ ชิปสวิตช์ (Switching Silicon) เสมอ: สวิตช์ตัดสินใจว่าข้อมูลไปทางไหน ส่วน optical ลำเลียงมันไปจริง — ทุกพอร์ตของสวิตช์ความเร็วสูงต้องมี transceiver เสียบอยู่ ยิ่งชิปสวิตช์เร็วขึ้น (เช่นระดับ 102.4 Tbps) ก็ยิ่งต้องการ transceiver มากและเร็วขึ้นตาม สองชั้นนี้วิ่งไปด้วยกัน ถ้าฝั่งใดช้า อีกฝั่งก็กลายเป็นคอขวด
- เชื่อมพอดและตึกใน การสร้างศูนย์ข้อมูล AI: สาย ไฟเบอร์ และ transceiver คือสิ่งที่ถูกติดตั้งระหว่างสร้างคลัสเตอร์ และเมื่อคลัสเตอร์ใหญ่เกินไฟที่ตึกเดียวรับไหว ก็ต้องใช้ DCI เชื่อมหลายตึกหลายเมือง — node นี้คือเส้นเลือดที่ร้อยทุกอย่างเข้าด้วยกัน
- พึ่ง Interconnect & Passive (เซมิคอนดักเตอร์): เลเซอร์ EML, ชิป silicon photonics, คอนเนกเตอร์แสง และซับสเตรตขั้นสูง ล้วนเป็นชิ้นส่วนทางกายภาพที่ต้องผลิตและประกอบอย่างแม่นยำระดับไมครอน
- ช่วยลดภาระ ไฟฟ้า: เพราะแสงส่งไกลด้วยพลังงานน้อยกว่าทองแดงมาก และ CPO ยังลดไฟต่อลิงก์ลงได้อีกหลายเท่า ในยุคที่ศูนย์ข้อมูลแย่งไฟกัน เรื่อง “วัตต์ต่อบิต” กลายเป็นตัวตัดสินสำคัญ
05ตอนนี้ไปถึงไหนแล้ว (2025–2026)
ภาพรวมตอนนี้คือ ทุกฝั่งของห่วงโซ่กำลังเฟื่องฟูพร้อมกัน แต่เงินไหลไปไม่เท่ากัน — ฝั่งที่ทำ “เลเซอร์และชิ้นส่วนต้นน้ำ” กับฝั่งที่ “ประกอบโมดูลปริมาณมาก” แยกกันชัด
ฝั่ง ต้นน้ำ (เลเซอร์/ชิ้นส่วน) ตะวันตกครองอยู่ Coherent และ Lumentum คือสองเจ้าใหญ่ที่ทำเลเซอร์ EML — หัวใจของทรานสซีฟเวอร์ที่คนอื่นต้องซื้อไปใช้ Lumentum ระบุว่ารายได้จาก AI และคลาวด์ตอนนี้คิดเป็น กว่า 60% ของรายได้ และเป็นรายเดียวที่ส่งมอบเลเซอร์ระดับ 200G ต่อเลนได้ในปริมาณมาก ไตรมาสล่าสุด (Q2 FY2026) รายได้แตะ $665 ล้าน พร้อมไกด์การเติบโตกว่า 85% เทียบปีก่อน
ฝั่ง โมดูลปริมาณมาก กลับเป็นจีนที่ครองตลาด — InnoLight และ Eoptolink รวมกันคว้าออเดอร์ 800G เพิ่มของ Nvidia ไปราว 60% และผู้ผลิตจีนสามรายใหญ่รวมกันมีส่วนแบ่งโลกเกิน 55% ปี 2025 InnoLight ทำรายได้ราว ¥38,000 ล้าน (+60%) ส่วน Eoptolink โตแรงถึง +187% ตรงนี้คือจุดที่ภูมิรัฐศาสตร์เริ่มร้อน เพราะลูกค้าและชิปต้นน้ำอยู่ฝั่งสหรัฐฯ แต่โรงงานประกอบโมดูลราคาคุ้มอยู่ในจีน
อีกชื่อที่ห้ามลืมคือ Fabrinet — โรงงานรับจ้างผลิต (contract manufacturer) ที่ประกอบโมดูลแสงให้ทั้ง Coherent, Lumentum และเจ้าอื่นๆ เป็น “มือที่มองไม่เห็น” ที่อยู่เบื้องหลังการผลิตจริง ส่วนฝั่งชิป DSP ที่ทำหน้าที่ประมวลผลสัญญาณในโมดูลมี Marvell และ Broadcom เป็นเจ้าใหญ่ และยังมี Credo ที่เด่นด้านสายทองแดงอัจฉริยะ (AEC) ซึ่งช่วยยืดอายุทองแดงในระยะสั้นๆ ก่อนถึงจุดที่ต้องเปลี่ยนเป็นแสง
ส่วน DCI (เชื่อมข้ามตึก/ข้ามเมือง) กำลังกลายเป็นคลื่นลูกใหม่ เพราะคลัสเตอร์ฝึก AI ใหญ่จนไฟที่ตึกเดียวไม่พอ — งานฝึกระดับใหญ่ตอนนี้กินไฟเกิน 100 เมกะวัตต์ และคาดพุ่งถึงระดับกิกะวัตต์ภายในปี 2030 บีบให้ต้องกระจายการฝึกข้ามหลายศูนย์ข้อมูล ทำให้ความต้องการ coherent optics ระยะไกล (เช่นโมดูล 800G ZR ที่ส่งได้ไกลถึง 2,000 กม.) โตตาม
06อนาคตข้างหน้า — 1.6T, CPO, LPO
ทิศทางแรกคือ การไต่ความเร็วต่อเนื่อง 800G → 1.6T → 3.2T ทุกครั้งที่ความเร็วเพิ่ม ทองแดงยิ่งหมดสภาพในระยะที่สั้นลง ทำให้แสงเข้ามาแทนใกล้ตัว GPU ขึ้นเรื่อยๆ รุ่น 1.6T กำลังเร่งเข้าสู่การผลิตจริง โดยคาดว่าจะมีดีมานด์ราว 7 ล้านชิ้นในปี 2026 และโมดูลเร็วกว่า 800G โดยรวมจะพุ่งจาก ~24 ล้านเป็นเกือบ 63 ล้านชิ้นในปีเดียว
ทิศทางที่สองคือ co-packaged optics (CPO) — แทนที่จะเสียบ transceiver เป็นโมดูลแยกที่หน้าเครื่อง ก็ย้ายชุดแปลงแสงไปติดบนแพ็กเกจเดียวกับชิปสวิตช์เลย ลดระยะที่ไฟฟ้าต้องวิ่งจนเกือบเป็นศูนย์ ผลคือประหยัดไฟมหาศาล: ในตัวเลขของ Nvidia สำหรับลิงก์ 1.6T การสูญเสียสัญญาณลดจากราว 22 dB เหลือ ~4 dB และพลังงานต่อลิงก์ลดจาก ~30 วัตต์เหลือ ~9 วัตต์ ส่วนสวิตช์ CPO ของ Broadcom ประหยัดไฟราว 65% เทียบโมดูลเสียบ ปี 2026 ถูกมองเป็นปีแรกที่ CPO ระดับการผลิตจริงเริ่มส่งมอบ นำโดย Broadcom (ตระกูล Tomahawk) และ Nvidia (Quantum-X / Spectrum-X)
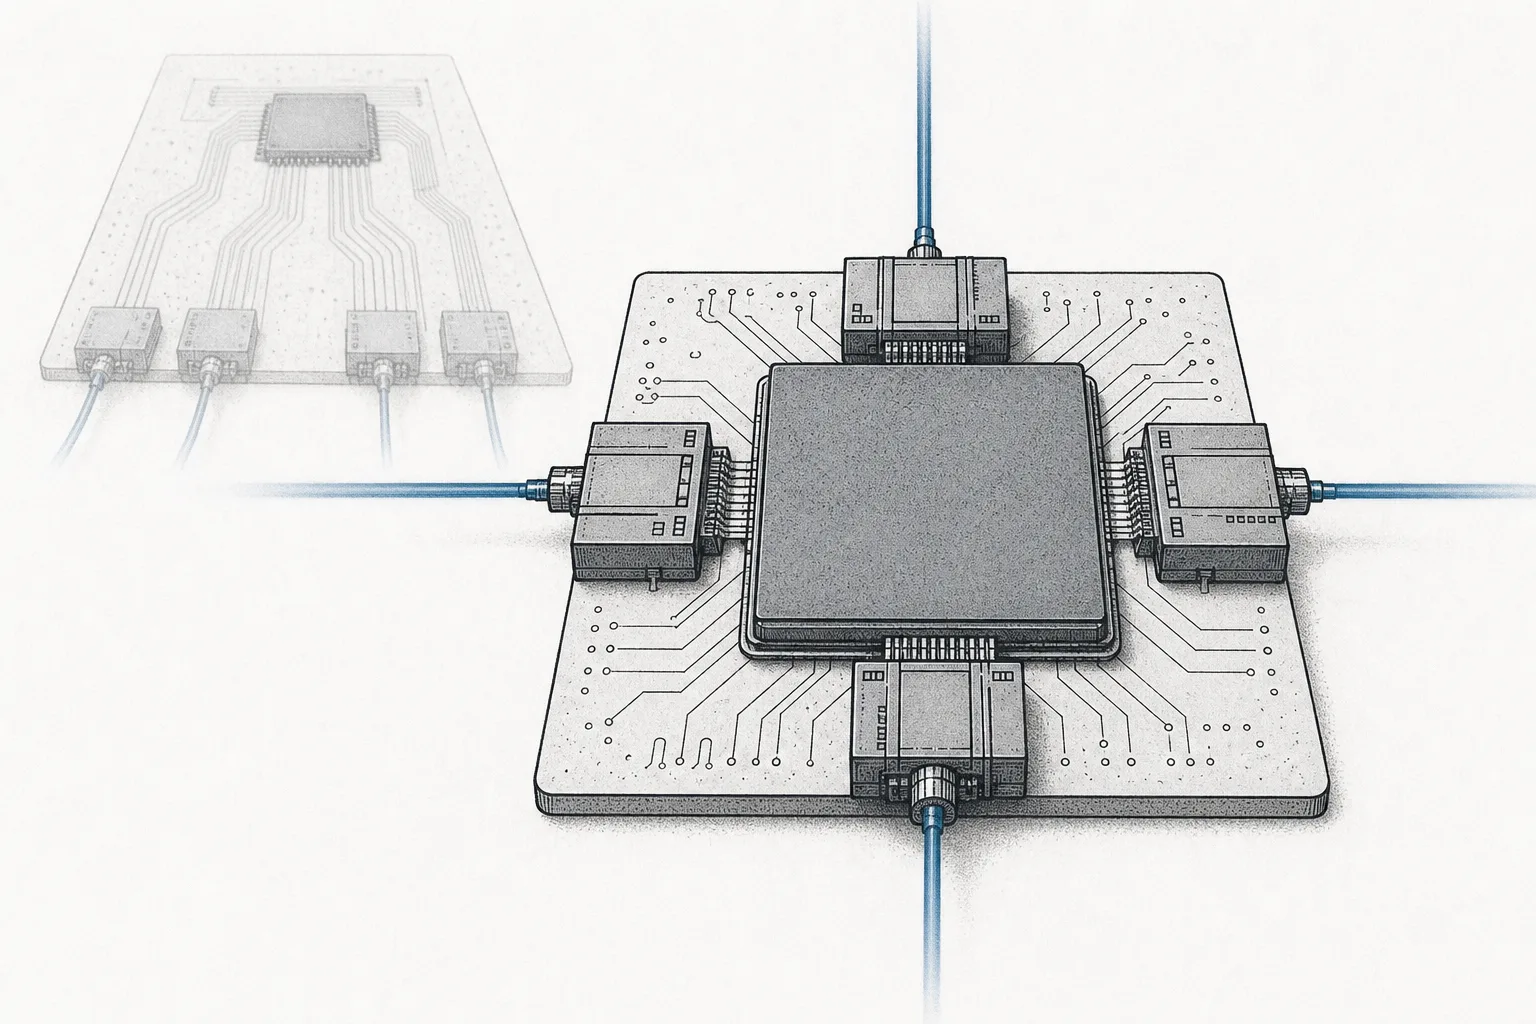
ทิศทางที่สามคือ LPO (linear-drive optics) — แนวทาง “สายกลาง” ที่ถอดชิป DSP กินไฟออกจากโมดูล แล้วใช้การขับสัญญาณแบบเชิงเส้นแทน เพื่อลดทั้งไฟและต้นทุนโดยยังเสียบใช้แบบเดิมได้ เป็นทางเลือกที่ถกเถียงกันว่าจะอยู่ระหว่างทางสู่ CPO นานแค่ไหน ภาพรวมคือทั้งวงการกำลังวิ่งไปทาง “แสงมากขึ้น ไฟน้อยลงต่อบิต” — ใครคุมเทคโนโลยีที่ประหยัดไฟที่สุดได้ก่อน คือคนที่ได้เปรียบ
07ความท้าทายและความเสี่ยง
ความเสี่ยงข้อแรกคือ การแข่งขันจากผู้ผลิตจีนที่ตีตลาดด้วยปริมาณ โมดูลแสงราคาคุ้มส่วนใหญ่ผลิตในจีน (InnoLight, Eoptolink) ที่โตเร็วมากและกินส่วนแบ่งโลกเกินครึ่ง สำหรับผู้ผลิตฝั่งตะวันตก นี่หมายถึงแรงกดดันด้านราคาในส่วนโมดูลปลายน้ำ — มูลค่าจึงไหลไปกระจุกที่ “ต้นน้ำ” (เลเซอร์/ชิป) ที่ลอกเลียนยากกว่า มากกว่าที่ตัวโมดูลเอง
ความเสี่ยงข้อสองคือ การเปลี่ยนเทคโนโลยีเร็วและเดิมพันผิดทาง เส้นทางจากโมดูลเสียบ → LPO → CPO ยังไม่ชัดว่าจะเร็วแค่ไหนและใครชนะ ผู้ที่ลงทุนหนักกับเทคโนโลยีรุ่นหนึ่งอาจถูกอีกรุ่นแซง การไต่ความเร็ว 800G → 1.6T → 3.2T ก็บีบให้ต้องพัฒนาใหม่ตลอด — ของที่ขายดีวันนี้อาจล้าสมัยในสองปี
ความเสี่ยงข้อสามคือ การผูกกับวงจรลงทุน AI และลูกค้าไม่กี่ราย ดีมานด์เกือบทั้งหมดมาจากการสร้างคลัสเตอร์ของกลุ่ม hyperscaler หยิบมือ ถ้าการลงทุน AI ชะลอหรือมีช่วง “ลงทุนเกิน” ออเดอร์ transceiver จะสะดุดทันที — เป็นธุรกิจที่โตแรงในขาขึ้น แต่อ่อนไหวต่อจังหวะการใช้จ่ายของลูกค้ารายใหญ่
สรุปสั้นๆ: node นี้คือจุดที่คลัสเตอร์ AI “เปลี่ยนภาษา” จากไฟฟ้าเป็นแสง เพราะทองแดงพาข้อมูลไปไม่ถึงทั้งในแง่ระยะและความเร็ว ทุกครั้งที่ AI ดันเพดานความเร็วขึ้น เส้นแบ่งของแสงก็ขยับเข้ามาใกล้ตัวชิปมากขึ้น — ทำให้ optical interconnect เป็นหนึ่งในคอขวดที่ทรงพลังและโตเร็วที่สุดของยุค AI