メガトレンド · 人工知能
銅が情報を運びきれなくなると、AIクラスターは「光」で会話を始める
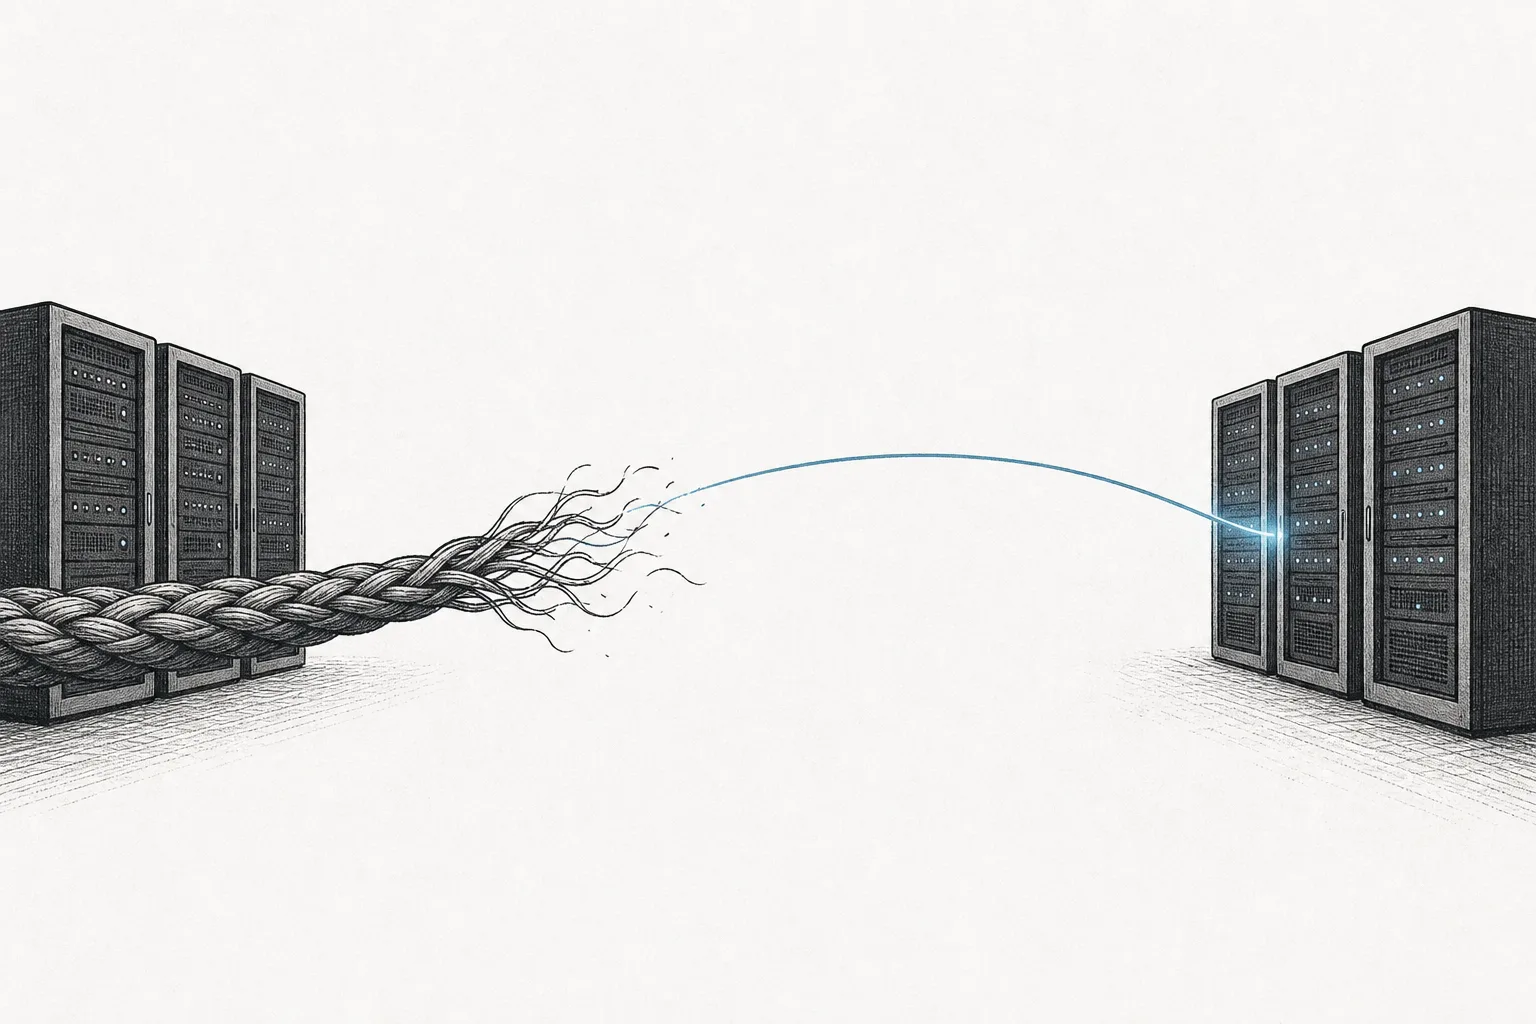
1チャンネルあたり200ギガビットという速さになると、銅のケーブルは1メートルも届かないうちに息切れします——信号が弱り、熱を持ちすぎるからです。でもAIクラスターのGPUは何十メートルも離れていて、別のラック、別の建物、ときには別の都市にある。そこでスケールし続ける唯一の道が、電子を光に変えてガラスの繊維で飛ばし、反対側でまた電気に戻すこと。この変換役が optical transceiver——わずか1年で市場が$230億を突破した小さな部品で、いまやAI時代の新たなボトルネックであり、宝の山にもなりつつあるんです。
01これは何?(光でつなぐ)
巨大なAIクラスターでは、何万個ものGPUが絶え間なく会話し続けます。しかも、それらはぴったり隣り合ってはいません——別のラックなら数メートル、別の列なら数十メートル、別の建物なら数キロメートル離れている。問題は、この距離をまたいで膨大なデータを、速く、しかも省エネで運ぶにはどうするか。答えは、銅を流れる電流で送るのをやめ、ガラス繊維を通る光で送ることに切り替える——これに尽きます。
この node は、まさにその役目を担う層です——デジタルデータ(電子)を光の信号(光子)に変えてファイバーに飛ばし、反対側でまた電気に戻す装置群のこと。知っておきたい主役は3つあります:(1) Optical transceiver——変換を行き来させる差し込み式モジュール(中にレーザーが入っている)· (2) Co-packaged optics(CPO)——光変換のセットをスイッチチップと同じ「パッケージ」に載せてしまう新世代で、電気が走る距離を縮めるのが狙い · (3) Data-center interconnect(DCI)——建物や都市をまたいでデータセンターを長距離の光で結ぶこと。
メガトレンドの地図の上では、この node は大きなトレンド 人工知能 の中の AIネットワーキング&インターコネクト の下にある一枚の葉です。もう一枚の兄弟である スイッチング&ネットワーキングシリコン(データの行き先を決めるスイッチチップ)と並び立ちます——スイッチが「方向を指示する頭脳」なら、この node は「光の速さで実際に血を運ぶ血管」というわけです。
Transceiver = 電気↔光を1つで変換する送受信機(transmitter + receiver)· CPO(co-packaged optics) = 光変換のセットを、別の差し込みモジュールにせず、スイッチチップと同じパッケージのすぐ隣に移したもの · DCI(data-center interconnect) = 別の建物・別の都市のデータセンターを長距離の光(十〜千キロメートル)で結ぶこと。coherent optics という技術を使う。
02なぜ重要か——銅が届かない
この話は、避けられない物理の壁から始まります。銅は短い距離なら上手にデータを運びます。でもチャンネルあたりの速度が 200ギガビット毎秒/レーン(200G/lane) まで上がると、銅の中の電気信号は一気に弱っていく——この速さだと、銅のケーブルは 1メートルも届かないうちにほぼ使い物にならなくなります。もっと速く、もっと遠くへ押し込むほど、熱を持ち、電気を食って割に合わなくなる。
ところがAIクラスターのGPUは、たった1メートルしか離れていないわけではありません——ラックをまたぎ、列をまたぎ、建物をまたいで会話する必要がある。だから距離や速度が銅の耐えられる一線を越えるたびに、スケールし続けられる道は光しかありません。ガラス繊維を通る光ははるかに遠くまで届き、失うエネルギーも少なく、電気信号のようには簡単に乱されないからです。業界がいまの局面を「銅から光への移行(copper-to-optical transition)」と呼ぶのは、こういうわけです。
経済的なインパクトはすぐに爆発しました。optical transceiver 市場の全体は 2025年に$230億超に達し、1年で約50%伸びました。主な原動力はAI需要です。データコム(データセンター内)だけでも$160億を突破(+60%)し、2029年までには$290億ほどに届くと見込まれています。
規模よりも大事なのが、需要の 繰り返しの多さ です——GPU1個があらゆる方向につながるには、何個もの transceiver が要ります。クラスターが大きくなり、チャンネルあたりの速度が上がるほど、GPU1個あたりの個数も増える。だから、この node の需要はGPUの販売台数よりもさらに速く伸びるんです。台数にもはっきり表れています:800Gより速い transceiver は2025年に約 2,400万個 出荷され、2026年にはおよそ 6,300万個 へと跳ね上がる見込み——1年で2.6倍です。
03どう動くのか(電子 → 光)
この node の核心は、1回の旅でデータを2度「変身」させること——出るときに電気から光へ、着くときに光から電気へ。データのひと塊が、片側のGPUからもう一方のGPUへどうやってたどり着くのか、一歩ずつ追ってみましょう。
これらが「難しい」とされる理由は、トランシーバーの心臓部にあります——信号を変換するレーザー、EML(externally modulated laser)と呼ばれるものです。このレーザーは、200Gのデータを1本の光に符号化するために、毎秒1,000億回という速さで点滅(オン・オフ)できなければなりません。素材には インジウムリン(Indium Phosphide) という特殊な物質を使い、きわめて高い精度が要る——この品質と量のレーザーを作れる会社は、世界にほんの数社しかありません。これが「ボトルネックの中のボトルネック」で、上流のレーザーメーカーがとりわけ強い交渉力を持つ理由です。
EML = 変調器を内蔵したレーザーで、高速のデータを光に符号化するのに使う(200G/レーンがいまの世代の標準)· Silicon photonics = 電子回路のように「光の回路」をシリコンチップ上に作る技術。1本のファイバーに複数の波長をまとめられ、光変換のセットを小さくできる——CPOへの道を開く中心技術です。
04どこに位置するのか
optical interconnect は単独では働きません。AIネットワークの中で、ほかの層と切り離せないほどぴったり組み合わさる層なんです。
- つねに スイッチチップ(Switching Silicon) とセット: スイッチがデータの行き先を決め、optical がそれを実際に運ぶ——高速スイッチのどのポートにも transceiver が差さっている。スイッチチップが速くなる(たとえば102.4Tbps級)ほど、より多く速い transceiver が要る。この2つの層は一緒に走り、片方が遅れればもう片方がボトルネックになる
- AIデータセンターの構築でポッドと建物を結ぶ: ケーブル、ファイバー、transceiver は、クラスターを建てるときに設置されるもの。そしてクラスターが大きくなりすぎて1つの建物の電力では足りなくなると、DCIで複数の建物・複数の都市を結ぶことになる——この node は、すべてをつなぎ合わせる血管です
- インターコネクト&パッシブ(半導体)に依存: EMLレーザー、silicon photonics チップ、光コネクタ、先進的な基板——どれもミクロン単位の精度で製造・組み立てが必要な物理的な部品
- 電力の負担を減らす: 光は銅よりはるかに少ないエネルギーで遠くまで送れるし、CPOならリンクあたりの電力をさらに何倍も下げられる。データセンターが電力を奪い合う時代には、「ビットあたりのワット」が重要な決め手になる
05いま、どこまで来たのか
いまの全体像はこうです——バリューチェーンのどの側も同時に活況。でもお金の流れは均等ではない——「レーザーや上流の部品」を作る側と、「モジュールを大量に組み立てる」側とがはっきり分かれています。
上流(レーザー/部品) は西側が握っています。Coherent と Lumentum が、トランシーバーの心臓であるEMLレーザーを作る2大メーカー——ほかの会社はこれを買って使うしかありません。Lumentum は、AIとクラウドからの売上がいまや 売上の60%超 を占め、200G/レーン級のレーザーを量産で供給できる唯一の会社だと述べています。直近の四半期(Q2 FY2026)は売上が $665百万 に達し、前年比85%超の成長見通しを示しました。
大量生産のモジュール の側は、逆に中国が市場を握っています——InnoLight と Eoptolink が、Nvidia の800G追加発注の約 60% をさらっていき、中国の大手3社を合わせると2025年の世界シェアは55%超。InnoLight は売上が約¥380億(+60%)、Eoptolink は +187% という勢いで伸びました。ここが地政学の熱を帯び始める点です——顧客と上流のチップは米国側にあるのに、コスパのいいモジュール組み立て工場は中国にあるからです。
忘れてはいけないもう一つの名前が Fabrinet です——Coherent、Lumentum、その他の会社の光モジュールを組み立てる受託製造(contract manufacturer)で、実際の製造の裏にいる「見えない手」。そして、モジュール内で信号を処理するDSPチップの側には Marvell と Broadcom が2大手として控え、さらに賢い銅ケーブル(AEC)で目立つ Credo もいます。AECは、光に切り替える地点の手前で、短い距離の銅の寿命を延ばす役目です。
DCI(建物・都市をまたいで結ぶ)の側は、新しい波になりつつあります。AIの学習クラスターが大きくなりすぎて1つの建物の電力では足りなくなったからです——いまの大規模学習は100メガワットを超える電力を食い、2030年までにはギガワット級に達すると見られ、学習を複数のデータセンターに分散せざるをえなくなる。だから長距離の coherent optics(たとえば2,000kmまで届く800G ZRモジュール)の需要も一緒に伸びます。
06これからの未来——1.6T、CPO、LPO
第一の方向は、速度を上げ続けること 800G → 1.6T → 3.2T です。速度が上がるたびに、銅はより短い距離で使えなくなり、光がGPUの近くへとどんどん入り込んでくる。1.6T世代は本格的な量産へと加速していて、2026年には約 700万個 の需要が見込まれ、800Gより速いモジュール全体は1年で〜2,400万個から6,300万個近くへと跳ね上がります。
第二の方向は co-packaged optics(CPO) です——transceiver を別モジュールとして装置の前面に差すかわりに、光変換のセットをスイッチチップと同じパッケージに載せてしまい、電気が走る距離をほぼゼロまで縮める。結果は莫大な省電力です:Nvidia の数字では、1.6Tリンクの信号の損失が約22dBから〜4dBへ、リンクあたりの電力が〜30ワットから〜9ワットへ下がります。Broadcom のCPOスイッチは、差し込みモジュールに比べて電力を約 65% 節約します。2026年は、量産レベルのCPOが出荷され始める最初の年と見られ、Broadcom(Tomahawk系)と Nvidia(Quantum-X/Spectrum-X)が先頭を走ります。
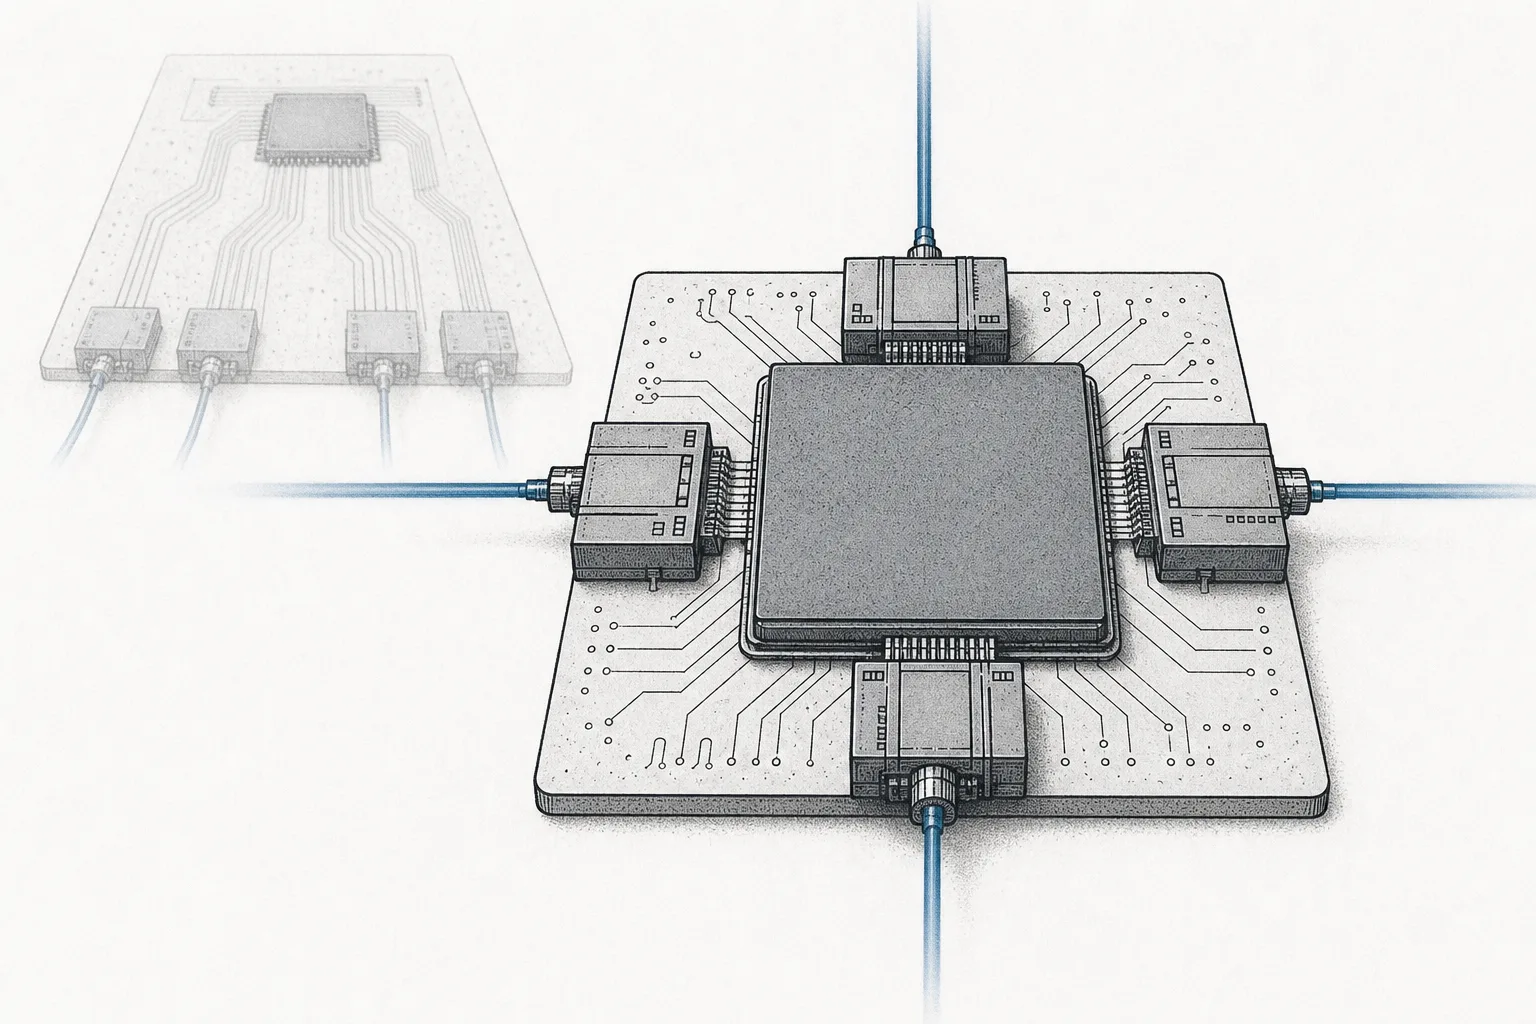
第三の方向は LPO(linear-drive optics) です——電力を食うDSPチップをモジュールから外し、かわりに信号を線形に駆動する「中間策」。差し込んで使う形のまま、電力もコストも下げるのが狙いです。CPOへ至る途中にどれだけ長くとどまるか、議論のある選択肢でもある。全体として業界は「光をもっと、ビットあたりの電力をもっと少なく」へと走っています——いちばん省電力な技術を先に握った者が、有利になります。
07課題とリスク
第一のリスクは 量で攻める中国メーカーとの競争 です。コスパのいい光モジュールの多くは中国(InnoLight、Eoptolink)で作られ、その勢いは非常に速く、世界シェアの半分超を奪っています。西側のメーカーにとっては、これは下流モジュールでの価格圧力を意味します——だから価値は、モジュールそのものよりも、真似しにくい「上流」(レーザー/チップ)へと集まっていくんです。
第二のリスクは 技術の移り変わりが速く、賭けを間違えること です。差し込みモジュール → LPO → CPO という道筋は、どれだけ速く進み、誰が勝つのかまだはっきりしません。ある世代の技術に重く投資した者が、別の世代に追い抜かれることもある。800G → 1.6T → 3.2T と速度を上げ続けることも、つねに新しい開発を迫る——今日よく売れているものが、2年で時代遅れになりかねません。
第三のリスクは AI投資サイクルと、ごく一部の顧客への結びつき です。需要のほぼすべては、ひと握りの hyperscaler のクラスター構築から来ています。もしAI投資が鈍ったり、「投資しすぎ」の局面が来れば、transceiver の発注はたちまち詰まる——上り局面では激しく伸びるが、大口顧客の支出のタイミングに弱いビジネスなんです。
ひとことでまとめると:この node は、AIクラスターが電気から光へと「言葉を切り替える」地点です。銅は距離でも速度でもデータを運びきれないから。AIが速度の天井を押し上げるたびに、光の境界線はチップの近くへとにじり寄ってくる——だから optical interconnect は、AI時代でもっとも強力で、もっとも速く伸びるボトルネックの一つなんです。