メガトレンド · Artificial Intelligence
ケーブルとスイッチが、何万台ものGPUを「ひとつの頭脳」に変える
みんなが高価なGPUの話ばかりします。でも見落とされている本当のポイントは——AIを1つ訓練するのに何万台ものGPUが同時に動き、コンマ何秒ごとに膨大なデータで「会話」し続けている、ということ。つなぐ線が少しでも遅いと、世界で最も高価なGPUがただ待ちぼうけを食う。この記事では、クラスター中のGPUを束ねて1台のマシンにするケーブルとスイッチの層を見ていきます——そして、その上でいま熱を帯びる、NvidiaとBroadcomの数千億ドル規模の主導権争いも。
01これは何?(ネットワークがコンピューター)
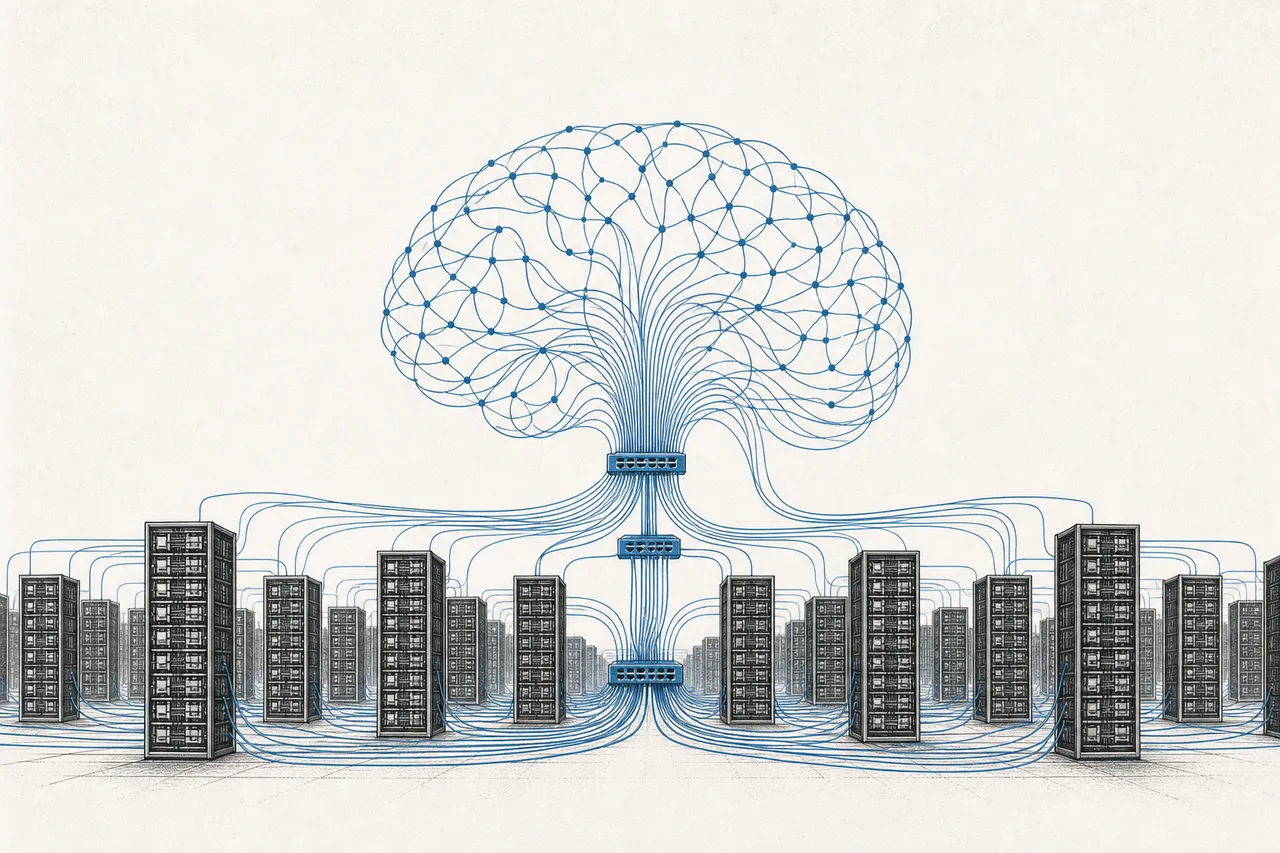
「AIモデルを訓練する」と聞くと、私たちはつい「ものすごく高性能な1台のコンピューター」を思い浮かべます。でも現実はまったく違う——GPTやGeminiのような大型モデルは、何万台ものGPUが同時に動いて訓練されています。問題は、GPU1台が見られるのはデータのほんの一部だけ。だから常に、その計算結果を仲間たちと「持ち寄って」まとめ続ける必要がある。ここで登場するのがAI Networking & Interconnectです。
このノードのテーマは、クラスター中のGPUを束ねて1台のコンピューターに変える、ケーブルとスイッチ。データを振り分けるスイッチ(switching)と、光の速さでデータを運ぶ光ファイバー(optical)の両方を指します。業界には「the network is the computer」という決まり文句がありますが——いまのAIにとって、それはもう比喩ではなく、エンジニアリング上の事実なんです。
Interconnect = 複数のチップが互いに会話できるようにする接続のしくみ · Fabric(ファブリック/ネットワーク) = GPUを一枚の布のように織り合わせる、ケーブル+スイッチ全体の総称。モデルが大きいほど、この布は広く、つなぎ目なく仕上げる必要があります。たった1台のGPUが「データ待ち」になるだけで、クラスター全体が引きずられて遅くなるからです。
メガトレンドの地図では、このノードはArtificial Intelligenceの下のサブテーマで、AI処理チップや電力と冷却といった兄弟分とともに「インフラ層」に位置します。チップが「脳」なら、ネットワークは複数の脳をひとつとして考えさせる「神経」です。
02なぜネットワークがボトルネックになるのか
なぜネットワークがこれほど重要なのかは、まずAIの訓練のしくみを知ると見えてきます。モデルの訓練とは、「1ステップ」を数百万回くり返すこと。そのどのステップでも、すべてのGPUが自分の補正値(gradient)を計算し、クラスター内の全GPUと平均して持ち寄ってから、次のステップへ進みます。この持ち寄りの工程をall-reduceと呼び、それが毎ステップ起きる——つまりネットワークが遅ければ、全GPUがいっせいに止まって待つことになる。
これが、業界がAIクラスターを「network-bound」と呼ぶ理由です。速度の上限は「チップがどれだけ速く計算できるか」ではなく、「どれだけ速くデータをやりとりできるか」で決まる。大型モデルの訓練では、ネットワーク待ちが1ステップの約40%を食うという試算もあります。つまりネットワークが十分でなければ、1台数万ドルのGPUが、ほぼ半分の時間を遊んで過ごしかねない。
経済的な影響もすぐに表れます。ネットワークはかつてデータセンターの「ちょっとした付け足し」でした。でもAIクラスターでは、全体コストの10〜20%を占めると見られる大きな出費になり、しかも最も伸びの速い部分のひとつです。狭い定義(ResearchAndMarketsの「AIデータセンター・スイッチ機器」だけ)でも、この市場は2024年の40億ドルから2030年に190億ドルへ拡大すると見られています(年平均約30%成長)。でもAIのback-endスイッチ向け支出すべてで数えれば、数字はもっと大きく、2030年までに約1,000億ドルに届きうる(Dell'Oro——スイッチ層を参照)。しかもこれは光とケーブル側をまだ含んでいません。
03仕組み — scale-up と scale-out
AIのネットワークは1層ではなく、役割の違う2つの層でできています——この2層の違いがわかれば、トレンド全体がわかります。
1つめの層がscale-up。「同じラックの中」にあるGPUを、まるで1つのチップのように極限まで速くつなぐ層です。主役の技術はNvidiaのNVLink——GPU Blackwell 1台にはNVLinkが18本あり、合計帯域は1.8 TB/s(一般的なPCIeの約14倍)。新型のGB200 NVL72は、1ラックの中で72台のGPUを「ひとつのドメイン」に束ね、合計130 TB/sの帯域を実現します——72台のGPUを、まるで1つの巨大チップに詰め込むように。
2つめの層がscale-out。「ラックをまたいで」数百〜数千のラックをつなぎ、何万台規模のクラスターに束ねる層です。ここは別の技術を使う——InfiniBandかEthernet——そして、ここがこのトレンドで最も激しい主戦場です(この争いには後で戻ってきます)。
なぜ2層に分けるのか? scale-upのほうがはるかに速いからです——ラック内のNVLinkは、ラックをまたぐscale-outのネットワークより約18倍速い。だからエンジニアは、できるだけ多くのGPUを同じscale-upドメインに「詰め込もう」とします(ノードあたり8台から、ラックあたり72台へ、そして576台へ向かいつつある)。データがscale-out層へ出ていくたびに、それは一種の「時間のロス」だからです。
GPU全台の値を「まとめて平均し」、その結果を全台に等しく送り返すこと——訓練の毎ステップで起きます。GPUが多いほどall-reduceは重くなる。これが、ネットワークの「帯域」(どれだけ広く送れるか)と「latency」(どれだけ遅延するか)が、AI訓練の速さを直接決める理由です。
04このトレンドの2つの層(スイッチ + 光)
ビジネスとして見ると、このトレンドは互いに支え合う2つの塊に分かれます——そして両方が同時に沸騰しています。
1つめの塊がスイッチとスイッチチップ(Switching & Networking Silicon/Systems)——データの「交差点」です。スイッチは数百本のケーブルからデータを受け取り、正しい方向へ送り出す。その心臓部がスイッチチップ(switch ASIC)で、1台のスイッチがどれだけ広くデータを捌けるかを決めます。最新のスイッチチップは世代ごとに速度が倍になっている。ここがBroadcomとAristaがぶつかり合う土俵です(プレーヤーとスペックの詳細は → スイッチ層)。
2つめの塊が光による接続(Optical Interconnect & DCI)——データをより遠く、より速く送ろうとすると、銅(ケーブル)が限界に近づきます。速くするほど熱くなり、遠くまで届かないからです。そこで世界は光へ切り替えた——データを光信号に変えてガラス繊維に飛ばす。この変換器をoptical transceiverと呼び、その需要が爆発しています。transceiver市場全体は2025年に230億ドル超に達した(1年で約50%成長)。核心は物理の壁です——1レーン200Gでは銅は1メートルも届かず、光だけがこの先もスケールできる唯一の道。そして価値は、中国が攻める モジュール本体よりも、西側が握る「上流のレーザー」に集中しています(→ 光層を参照)。
だからこのノードは「同じ話の表と裏」なんです——スイッチはデータの行き先を決める脳、光はそれを実際に運ぶ血管。両方が同時に速くならなければ、片方がボトルネックになってしまう。
05エコシステムの中でのつながり
AI Networkingは単独で浮いているわけではありません。他のトレンドを「束ねる」層です:
- AI処理チップを1台に束ねる: これが最も深いつながり。GPUがどれだけ優秀でも、互いに会話できなければ意味がない。だからこのノードの需要はGPUの販売に直結します——GPUを多く買うほど、ケーブルとスイッチも多く買うことになる
- AIデータセンターの建設の一部: スイッチ、ケーブル、transceiverは、巨大クラスターを建てるときに据え付けられる部品
- 膨大な電力を吸い上げる: 高速ネットワークは電気を大量に食う——だからco-packaged optics(光をチップに直付けする)が重要で、クラスターあたり数十メガワットの電力を削れる
- 半導体とInterconnect & passiveに依存: スイッチチップもファウンドリで作るチップだし、ケーブル・コネクタ・先端基板は、組み合わせる物理的な部品
- 重要な原材料に依存: 高品質の銅から、ガラス繊維の素材、transceiver内のレーザーまで
06いまの主戦場(2025〜2026)
ここが最もドラマチックな部分です——数千億ドルを賭けた、2大陣営によるAIネットワークの覇権争い。
一方の陣営はNvidia。GPUだけでなく「システム丸ごと」を売ります——scale-up向けのNVLinkに加え、自前のネットワークであるInfiniBand(Mellanoxの買収で手に入れた)も含めて。InfiniBandは安定して遅延が低いため、AIクラスターのback-endの約80%をかつて握っていました。だからNvidiaは、チップとネットワークを1つのパッケージで買わせ、顧客を「ロックイン」しようとします。
もう一方の陣営がEthernet勢。Broadcom(スイッチチップ)とArista(スイッチシステム)が率い、Ultra Ethernetというオープン標準を推進しています(仕様1.0は2025年半ばに登場)。オープン標準であるEthernetを、InfiniBandと戦えるほど速く安定させるのが狙い——売りは「1社に縛られない、しかも安い」。
そして2025年、流れが変わった——EthernetがInfiniBandを逆転し、AIのscale-outの主役ネットワークに初めて躍り出ました。その年のscale-out向けでは、Ethernetの市場規模がInfiniBandの2倍超に達したという報告も——かつてInfiniBandが約80%を握っていたところからの逆転です。
プレーヤーの数字が物語を雄弁に語ります。Broadcomはこの時代の「静かな勝者」になりました——2025会計年度第4四半期、AIチップの売上は74%伸びてrecord水準に達し、ネットワーク側は170%も伸びて、AI売上全体の約40%を占めるまでに。一方Aristaも2026年のAI売上目標を27.5億ドルへ引き上げ(2025年の目標15億ドルから)、納品待ちのbacklogは68億ドル超。
光の側も負けず劣らず沸騰しています。800Gの需要が、中国メーカーのInnolightとEoptolinkにNvidiaの追加発注の合計約60%を取らせた一方、西側のCoherentとLumentumはレーザーと上流部品を握ります。そしてNvidia自身も、co-packaged optics採用のスイッチQuantum-X(2025年末)とSpectrum-X(2026年)で光の土俵に飛び込んできました。
07これからの展開
第1の方向は「銅から光へのスーパーサイクル」。1チャネルあたりの速度が上がるほど(800G → 1.6T → 3.2T)銅は使い物にならなくなり、より短い距離でも光が置き換わっていきます。行き着く先はco-packaged optics(CPO)——レーザーをスイッチチップに直付けして、電力を抑えつつ速度を上げる技術です。2026年はCPOが本格量産に入る最初の年と見られ、Google、Meta、Amazon、Nvidiaが先陣を切る——挿し込み式(pluggable)のtransceiverがなくなるわけではありませんが、道筋は明確に「より光へ」と向かっています。
第2の方向はEthernetがさらにシェアを取ること。成熟していくUltra Ethernet標準と、より広いエコシステムを武器に。AIのscale-out向けEthernet売上は、2030年までに年1,000億ドルを超えると予想されています。とはいえInfiniBandも消えはしない——最も低い遅延と最も高い確実性を求める用途(frontier級の訓練クラスター、国家研究)では、なお主役であり続けます。
第3の方向はscale-upがよりオープンになること。いまNVLinkはNvidiaの独占ですが、オープンなscale-up標準を作る動きが出ています(たとえばEthernetをscale-up層にも降ろしてくる試み)。これが成功すれば、Nvidiaが独占してきた層に他のプレーヤーが参入できる——新しいラウンドの主戦場が、いま形を取りつつあります。
08課題とリスク
AIネットワークは熱いトレンドですが、見極めるべきリスクも伴います。
1つめのリスクはAI投資サイクルへの連動。このノードの需要はGPUクラスターの建設に直結します。hyperscalerのAI投資が鈍れば(あるいは「投資し過ぎ」の局面があれば)、スイッチやtransceiverの発注もすぐに息切れする——上り坂ではとても速く伸びる事業ですが、少数の顧客の支出ペースに左右されやすいのです。
2つめのリスクはまだ決着していない標準争い。InfiniBand対Ethernetの戦いや、scale-upの開放は、今日のリーダーが新しい技術や標準に破壊されうることを意味します。これほど速く変わる事業で標準を賭け間違えると、高くつく。
3つめのリスクは地政学と光のサプライチェーン。コスパの良い光モジュールの多くは中国で作られ(Innolight、Eoptolink)、一方で主要顧客と上流チップは米国側にあります。貿易の緊張や輸出規制は、すでに品薄のこの層の、価格と納品の両方を揺さぶりかねません。
ひとことで言えば、AI Networkingは、ただの「配線」と見過ごされてきた層が、突然AI時代で最も重要なボトルネックの一つ、そして主戦場の一つになった物語です。世界で最も高価なGPUも、束ねるのに十分速いネットワークがなければ、その瞬間に無価値になる。「ネットワークがコンピューター」だと理解することは、なぜ数千億ドルが、私たちの目に見えないケーブルとスイッチへ流れ込むのかを理解することなんです。