メガトレンド · 人工知能
GPU 1万台を「1台の頭脳」にできるか——それを決めるのは、たった1個のスイッチ
AIクラスターというと、私たちはつい GPU を思い浮かべます。でも、GPU を何万台も束ねて1台のスーパーコンピュータに変えているのは、実は スイッチ——データの交差点になる箱なんです。その心臓部にあるのが「スイッチシリコン(switch silicon)」という小さなチップで、クラスター全体がどれだけ広く速くデータをやり取りできるかは、ここで決まります。このレッスンが扱うのはこの一層だけ——電気側のスイッチチップとシステム(Ethernet vs InfiniBand)で、Broadcom・Nvidia・Arista が何十兆円という規模でぶつかっている領域です(「光」側は姉妹レッスンの Optical Interconnect にあります)。
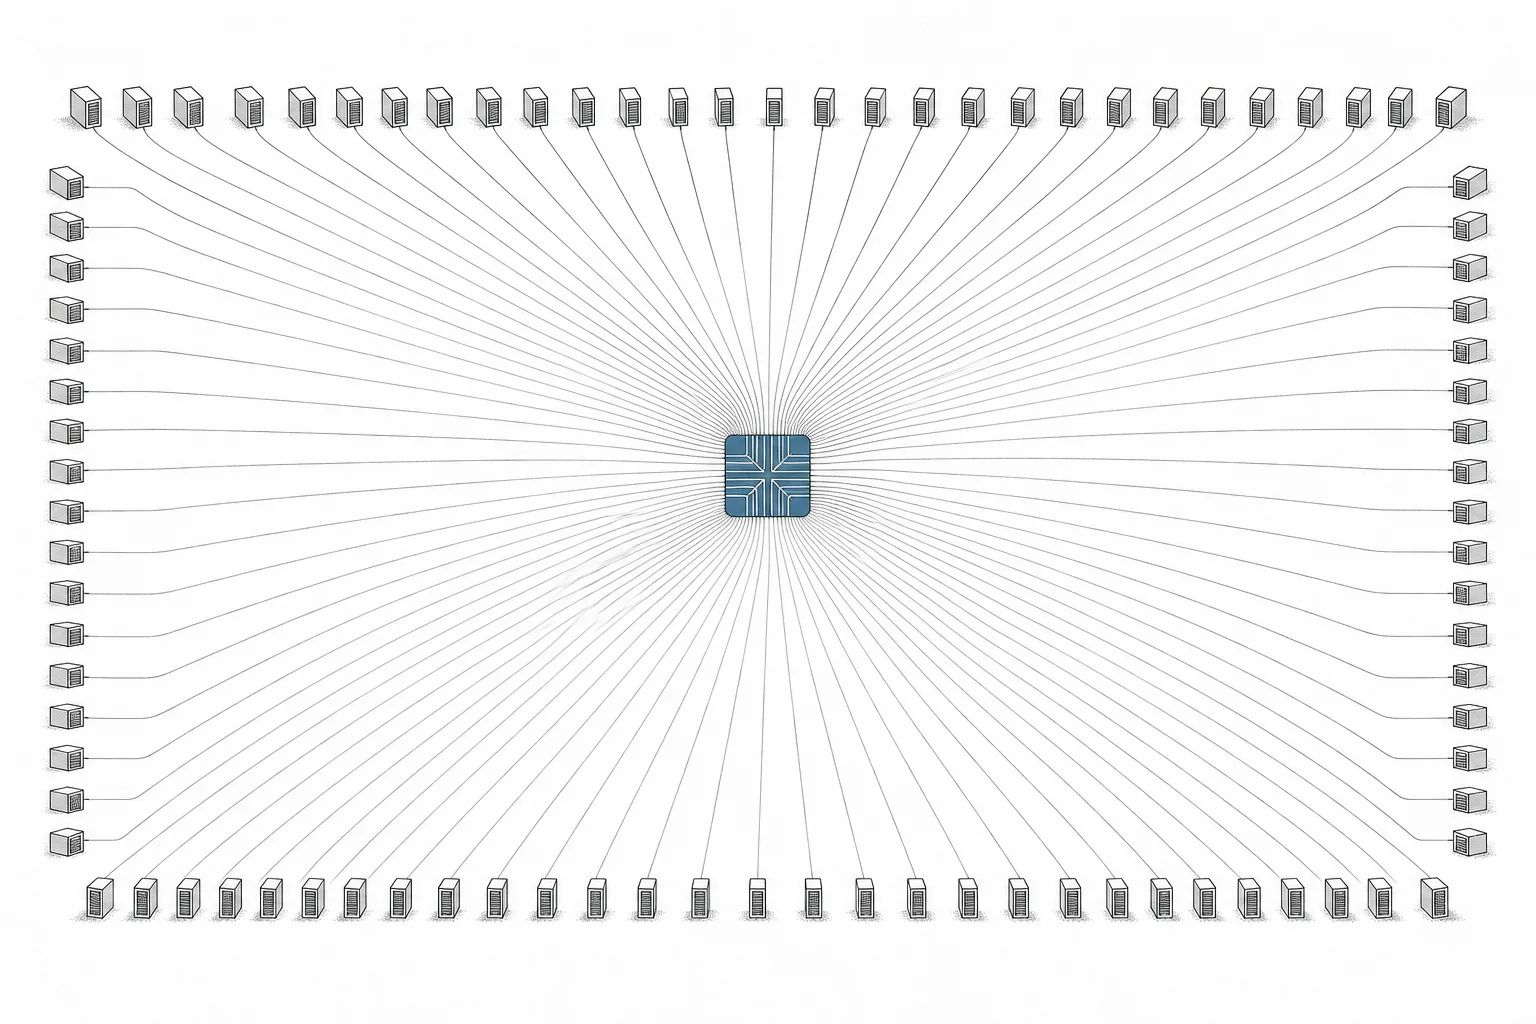
01これは何?
1万人が同じ1つの仕事をしている部屋を想像してください。全員すごく優秀。でも数秒おきに、自分の出した結果を 残り全員 に一斉に伝えなければいけません。速くて詰まらない伝達の仕組みがなければ、部屋じゅうが声を張り上げて重なり合い、仕事は前に進みません。ネットワークスイッチは、AIクラスターにとってのこの「伝達の仕組み」です。そしてこの node は、その役目を担うチップと箱の話です。
もう一段だけ掘ると、AIスイッチには分けて見るべき2つの部分があります:(1) スイッチチップ(switch silicon / switch ASIC)——箱の中にある1個のチップで、どのデータをどのポートへ流すかを決める役目。スイッチ全体の速度の上限を握る「頭脳」です · (2) スイッチシステム(switch system)——そのチップを組み込んで、ネットワーク制御のソフトとともに実際に使える機器に仕立てた箱本体。チップだけを売る会社(Broadcom)もあれば、チップをシステムにして売る会社(Arista)もあり、両方を自前でやる会社(Nvidia)もあります。
メガトレンドの地図のうえでは、この node は大トレンド Artificial Intelligence の中の AI Networking & Interconnect の下にある leaf(末端)です。これはネットワークの「電気の層」——電気信号でチップと銅線を通してデータを送ります。隣に並ぶ姉妹が Optical Interconnect & DCI で、こちらは「光の層」を担当します(遠くへ送るときにデータを光に変えて光ファイバーで飛ばす)。スイッチがデータの行き先を決め、距離が伸びると光がそれを実際に運ぶ、という関係です。
Switch ASIC = スイッチの核になる専用チップ · SerDes(Serializer/Deserializer)= 1本のレーンでデータを送受信する小さな回路。1レーンあたりが速いほど(100G → 200G)チップは強くなる · Radix = 1個のスイッチがつなげるポート数。radix が高いほど、少ないスイッチで多くの GPU を束ねられる = 配線が短くなり、遅延が減り、消費電力も下がる。
02なぜ重要か——「ネットワークがコンピュータだ」
AIの時代に、ある一文が工学的な真実になりました:“the network is the computer”。理由はモデルの学習のしかたにあります——大きなモデルは何万台もの GPU で同時に学習され、学習のステップごとに、すべての GPU が自分の計算結果を仲間全員と「平均してまとめる」必要があります(all-reduce と呼ばれる工程)。それが終わらないと次のステップへ進めません。つまりスイッチがほんの少しでも遅かったり詰まったりすると、1台あたり数百万円の GPU がクラスター丸ごと、いっせいに待ちぼうけになるのです。
これが、AIクラスターが「network-bound」と呼ばれる理由です——速度の上限は計算チップがどれだけ速いかではなく、互いにどれだけ速くデータを交換できるかで決まる。数字にすると分かりやすい:GPU が1,000台あるだけのクラスターでも、全台が全台と通信する(all-to-all)のを合わせて 400 Tbps 超でさばける 詰まりのない(non-blocking) ネットワークが要ります。しかもパケットをほとんど落とさず、遅延はマイクロ秒の精度で安定していなければいけない——こんな仕事は、AI以前のデータセンターのネットワークには存在しませんでした。
経済的な影響はすぐ表れます。ネットワークはかつて、データセンターの「小さな付け足し」にすぎませんでした。でもAIクラスターでは、最も速く伸びる大きな出費の1つになっています。Dell'Oro Group は、AIの裏方ネットワーク(AI back-end) 向けのスイッチに投じられる金額が 2030年までに年間1,000億ドルを突破する と見ています。そして箱に組み上がる前の「スイッチチップ(switch silicon)」だけの市場でも、2025年で約38億ドル の規模になっています。
03これはどう動くのか(leaf/spine fabric)
GPU 1万台をくまなく通信させて束ねる仕組みの核が、leaf/spine(または fat-tree)と呼ばれる構造です——すべての GPU を直接つなぐ(何万台もあると不可能)かわりに、スイッチを2層に並べて、データを中間の層を通して流します。
下の層が leaf switch——GPU が直接ささるスイッチで、各 leaf が GPU を1グループずつ受け持ちます。上の層が spine switch——すべての leaf をつなぐスイッチです。ある GPU が別の leaf にある GPU へデータを送るときも、データは必ず 2区間だけ:leaf → spine → leaf を通ります。2台がどれだけ離れていても同じ——だから遅延が「ぶれず」、予測できる。これが all-reduce のときにとても効いてきます。
スイッチチップが「難しい」ゆえんが、non-blocking(詰まりがない) という言葉です——ネットワークは、どの GPU からどの GPU へもフルスピードで同時に送れるように作らなければいけません。そのために spine 側は、leaf が受ける分と同じだけの帯域を下ろして受け止める必要があります(1:1の比率)。1個のスイッチチップが広く送受信できるほど(radix が高いほど)、少ないスイッチでこの fabric を組める——つまり配線が短くなり、スイッチが減り、遅延が減り、消費電力も下がる。「チップ1個の広さ」が重要な競争の舞台になったのは、これが理由です。
もう一段、混同してはいけない区別があります:同じラック内 の GPU をとことん速くつなぐこと(scale-up と呼ぶ——Nvidia は NVLink を使う)と、ラックをまたいで 大きなクラスターにつなぐこと(scale-out と呼ぶ——InfiniBand/Ethernet を使う)は別物です。いま見た leaf/spine は scale-out の層——そしてここが、このレッスンの主戦場です。
04エコシステムの中でのつながり
スイッチの層は単独で働いているわけではありません。複数のトレンドを束ねる結節点です。
- GPU / AI accelerator を1台にまとめる: これが最も深い関係です。GPU がどれだけ優秀でも、互いに通信できなければ無価値——だからスイッチの需要は GPU の販売に直結します。GPU を多く買うほど、スイッチもそれだけ買うことになる
- つねに Optical Interconnect とペア: スイッチがデータの行き先を決め(電気の層)、銅線では届かない距離になると光に変える(光の層)——この2層は同時に速くならないと、片方がボトルネックになる。しかも co-packaged optics で光をスイッチチップに直付けする流れが進み、その境界線も薄れつつある
- AIサーバー/ラック の部品: ラックやクラスターを組み立てるとき、leaf スイッチが大量に取り付けられる——AIデータセンターを作るうえで欠かせない標準部品です
- 半導体 に依存: switch ASIC は、結局は先端のファウンドリ(TSMC)で作るチップ——上位のスイッチチップは GPU と同じ世代の技術を使う
- 電力 を大量に食う: 高速スイッチと SerDes は電力を多く消費する——radix を高め、co-packaged optics を使うことが重要なのは、ビットあたりの消費電力を下げられるからです
05いま、どこまで来たのか
2025年、この業界でいちばん大きな出来事が Ethernet が InfiniBand を逆転 し、AIの scale-out ネットワークの主役に初めて立ったことです。ほんの2年前まで、InfiniBand はAIの裏方スイッチの売上を 80% ほど握っていました。安定していて遅延が低いからです。ところが2025年第4四半期には、Ethernet がAIクラスターのスイッチ売上の 3分の2超 を取り——Dell'Oro は、その年の scale-out 向けでは Ethernet が InfiniBand の「2倍超」の市場規模になったと報告しています。
なぜ逆転したのか?それは 大手 hyperscaler が1社に縛られたくない からです——Amazon、Microsoft、Meta、Oracle、xAI はどこも、オープン標準で安く、売り手が複数いる Ethernet へと向かいました。これでまるごと恩恵を受けたのが、スイッチチップの王者 Broadcom。2025年なかばにチップ Tomahawk 6 を発表し、1個のチップで102.4 Tbps(前世代の2倍、1.6Tポートを64個収容)を叩き出して、2026年初めに量産入りしました——この水準に届いた世界初のスイッチチップです。
でも Nvidia は簡単には譲りません——GPU だけを売るのをやめ、「システムまるごと」を売るようになりました。自前のネットワークとして InfiniBand(Mellanox の買収から)と、Ethernet の新型 Spectrum-X の両方を抱えていて、Spectrum-X は Broadcom 陣営の Ethernet と真っ向から戦うために設計されています。2025年、Spectrum-X はこの1製品だけで 年間100億ドル超の run-rate に乗り、Nvidia のネットワーク部門の売上全体は 四半期80〜110億ドル——前年比160%超の伸びに達しました。いっぽう、ハイエンドの Ethernet「スイッチシステム」を cloud titans に売る Arista も、2025年通期で 90億ドル(+29%) の売上を上げ、2026年のAI向け売上だけで 27.5億ドル を見込んでいます。
06これからの話——1.6T とオープン標準
1つめの方向は 止まらない速度の追い上げ です。今の主流は800Gポート(出荷開始からわずか3年で2,000万ポートを突破)で、次の 1.6T が市場へ流れ込んでいます。Tomahawk 6 のようなチップは、もう直接 1.6T に対応するよう設計されています。1レーンあたりの速度が上がるたび、銅線はますます早く限界に達し(速いほど熱くなり、届く距離が短くなる)、スイッチの層と 光の層 は co-packaged optics(CPO) でいっそう融合せざるをえなくなります——レーザーをスイッチチップのすぐ横に付けるわけです。2026年は、Ethernet と InfiniBand の両方で CPO が初めて量産入りする年と見られています。
2つめの方向は オープン標準がさらにシェアを取る こと。Ethernet 陣営は Ultra Ethernet Consortium として結集し、2025年なかばに仕様1.0を出しました。Ethernet を、AIの仕事で InfiniBand と真っ向勝負できるくらい低遅延でパケットを落とさないものに作り変えるためです。Dell'Oro は、AI back-end のスイッチ売上が 2030年までに年間1,000億ドルを突破する と見ていて、その大半は Ethernet です——とはいえ InfiniBand が消えるわけではありません。最も低い遅延と最も高い確実性が要る仕事(frontier 級の学習クラスター)では、いまも InfiniBand が主役です。
3つめの方向は scale-up の層での新しい戦い です。今は同じラック内の GPU をつなぐ(scale-up)のは、NVLink を通じて Nvidia の独壇場。でも Ethernet をこの層にも下ろそうという動きが出ています(たとえばオープンな scale-up 標準)。もし成功すれば、Nvidia がこれまで独占してきたこの層に、Broadcom、Marvell、ほかのスイッチチップ勢が参入してくる——クラスター全体のなかで、ポートあたりの価値が最も高い層です。
07課題とリスク
1つめのリスクは Nvidia の垂直統合 です。Nvidia は GPU とネットワークの両方を握っているので、「パッケージで売って」チップと一緒に自社スイッチを買わせ、顧客を囲い込めます——スイッチだけを売る勢(Broadcom、Arista)は、顧客を Nvidia の閉じたシステムに留めようとする引力と戦わなければいけません。全体では Ethernet が逆転していても、Nvidia の GPU だけで組まれたクラスターには、割って入るのがいっそう難しくなります。
2つめのリスクは まだ終わらない標準戦争 です。InfiniBand vs Ethernet の争い、scale-up の開放、CPO の到来——どれも、今日の勝者が新しい標準やアーキテクチャに足をすくわれうることを意味します。変化が速くR&Dに重く投資するこの種のビジネスで、標準を読み違える賭けは、とても高くつきます。
3つめのリスクは AI投資サイクルと、少数の顧客への依存 です。スイッチの需要は GPU クラスターの建設に直結し、その大口顧客はほんの数社(hyperscaler 勢)しかいません。もしAI投資が減速したり、「過剰投資」の局面が来れば、スイッチの発注もたちまち止まります——上り坂では猛烈に伸びるけれど、ひと握りの顧客の支出のリズムに弱いビジネスなのです。
ひとことで言えば:この node は、かつて「ただの配線と箱」と見られていた層が、AIの時代で最も重要なボトルネックであり主戦場の1つに変わった、という話です——世界で最も高価な GPU も、それを束ねられるだけ広くて速いスイッチがなければ、たちまち無価値になるからです。データを光で遠くまで運ぶ話は、姉妹レッスンの Optical Interconnect & DCI で読めます。