メガトレンド · Artificial Intelligence
モデルは「学習」されるのは一度きり、でも「実行」は何十億回——これは、その何十億回のために設計されたチップの話です
世界がよく知るAIチップ(NVIDIAのGPU)は、モデルを「学習(training)」させるのが得意なように作られています。でも学習が起きるのはほんの数回。いっぽうモデルを「実行」して実際に質問に答えさせる(inference=推論)のは、毎秒のように何百万、何十億回も起きます。実行の量が学習を何倍も上回るようになると、答え1つあたりのコスト(cost per token)と速さ(tokens/秒)が新しい主戦場になる——そして、GPU全般より速く安く「実行だけ」をこなす新種のチップに道が開けるんです。このレッスンでは Groq、Cerebras、d-Matrix、そして本当の主役の多くがいまも非公開企業である理由を見ていきます。
01これは何?——「学習」ではなく「実行」のためのチップ
ある辞書を一冊つくる場面を思い浮かべてください。辞書を書いて編集するのには何年もかかり、膨大なチームが要ります——でもそれは一度きり。そのあと毎日起きるのは、人が言葉を引くこと、何百万回も。AIの世界もまったく同じです。モデルを「学習(training)」させるのが辞書を書くこと、モデルを「実行(inference)」するのが言葉を引くこと——そしてこのnodeは、その「言葉を引く」ためだけに設計されたチップの話なんです。書くためではなく。
メガトレンドの地図で見ると、このnodeは大きなトレンドArtificial Intelligenceの中のAI Compute & Accelerator Siliconの下にある枝葉(leaf)です。定義はシンプル:「低遅延(low-latency)で速く流れる(high-throughput)モデル実行のために設計されたアーキテクチャ」。人の言葉にすると——AIが速く、しかも正しく答えることを、答え1つあたり最も安いコストで実現するチップです。
なぜこの仕事に専用チップが要るのか?それは「実行」と「学習」がまったく別の仕事だから。学習は逆向きの計算で重みを何兆回も調整する必要があり、柔軟性と莫大な生のパワーを求めます。いっぽう実行は前向き一方向の計算で、同じことを繰り返す、予測のつく仕事——こういう「何をするか前もってわかっている」仕事は、専用チップを設計すれば汎用チップよりずっと速く、消費電力も抑えてこなせます。これが、GroqのLPUやCerebrasのウエハー規模のマシンといった新種のチップが生まれた理由なんです。
Training(学習)=膨大なデータでモデルを教えること。一度きり/ごくたまにしか起きない · Inference(実行・推論)=学習し終えたモデルを使って実際に質問へ答えること。ずっと起き続ける · Token=モデルが一つずつ生み出す小さなテキストの単位(だいたい単語や単語のかけら)。1段落の答えは数百tokenになることも · Latency(遅延)=答えが返ってくるまでの待ち時間——低いほど「サクサク」感じます
02なぜ重要か——「実行」が「学習」を上回るとき
すべてを変えたのはコンピュートの配分が逆転しつつあることです。2023年にはモデルの学習がコンピュートの約3分の2を、実行は3分の1だけを使っていました。でもAIが実験室を出て、何百万人もの現実の利用へと広がると、すべてがひっくり返ります——2025年には実行が約半分まで上がり、2026年にはAIコンピュート全体の3分の2を占めると見られています。多くの調査機関は、2028〜2030年までに実行が70〜80%を食うと見ています。
実行が大きな塊になると、その仕事をこなすチップの市場も一気に膨らみます。多くの調査機関は inference チップ市場を、どこまでを数えるかで違う見方をしていますが、向きは一致しています:Deloitte は inference 向けに設計されたチップだけで2026年に500億ドルを超えると見ています。広く取った inference チップ市場全体は2025年に約1,050億ドルで、多くの調査機関は2030年代前半に年率25〜28%で3,000〜5,700億ドルまで伸びると見ています。
大きさ以上に重要なのが、そのエコノミクスが学習とはまるで違うことです。学習では、良いモデルを手に入れるために高い費用を一度だけ払います。でも実行では、誰かが質問するたびに繰り返し払うことになる。だから答え1つあたりのコストをほんの少しでも下げられれば、それを何十億回も掛け算すると莫大なお金になります——これこそ、このチップ群が存在する理由のすべてです:何でも器用にこなすためではなく、たった一つの仕事をtoken あたり最も速く、最も安くこなすために。
03どう動くのか——一度学習して、あとは果てしなく実行する
このnodeの核心は、学習と実行のあいだの非対称性にあります。1つのモデルの一生をたどって、なぜ「実行」がすべてを左右する大きなコストの塊になるのかを見ていきましょう。
では inference チップはどうやって速くするのか?鍵はメモリにあります。モデルを実行するとき、ボトルネックは掛け算をする計算器ではありません——モデルの重みをメモリから運んでチップに送る、その部分が遅いんです。一般的なGPUは重みを「チップの外」にある HBM メモリに置き、毎秒およそ8 TB/sでデータを送ります。いっぽうGroqは重みをチップ上の SRAM にそのまま置く設計を選びました。これは80 TB/s以上という速さ——10倍以上です。結果、チップはデータを待たずに済み、token をはるかに勢いよく吐き出せます。
HBM=チップの隣に置く高帯域メモリ。容量は大きいがアクセスは遅め(HBM & AI Memoryを参照)· SRAM=チップ上にそのまま埋め込まれたメモリ。とても速いが容量は小さい。inference チップの一部は速さのために容量を割り切る · Deterministic execution=コンパイル時にすべての処理をクロック単位で前もってスケジュールしておくこと。これで「ランダムなつまずき」がなくなる——Groqはこの方法で速さと安定性を最大まで引き出しています
04GPUやASICとどう違うのか——そして何とつながるのか
このnodeには、同じ一族の中に区別すべききょうだいがいます。どれもモデルを「実行」できる点は同じですが、思想が違うんです:
- GPU & Merchant Acceleratorsとの違い: GPUは学習も実行もできる汎用チップ。強みは柔軟性と、世界中の開発者が慣れ親しんだソフトウェア(CUDA)。でもその柔軟性は、実行のときには要らない余分を抱え込みます——専用の inference チップはその余分を切り落とし、実行だけの仕事での token あたりの速さ/価格の良さと引き換えにするんです
- Custom Silicon / ASICとの違い: 境界線はとても薄い——専用の inference チップ自体が ASIC の一種です。違いは「誰が、何のために作るか」。node 10010200 はテックの巨人が自分のクラウドで使うために自前で作る ASIC(GoogleのTPUなど)が中心。いっぽうこのnodeは、独立系のチップ会社が誰にでも売る/提供する inference チップ(Groq、Cerebras、d-Matrix)が中心です
- HBM & AI MemoryとFoundry & Contract Fabricationに頼る: SRAMを選ぼうとHBMを選ぼうと、これらのチップもまた、他のAIチップと同じく最先端の製造プロセスと高度なパッケージングで作られる必要があります
チップ一族の外に目を向けると、このnodeは他のトレンドに火をつける「エンジン」です:
- Agentic AIに直接パワーを供給する: 段階を踏んで働くAIエージェント(agent)は、1つの仕事のあいだにモデルを何度も呼び出します——その1回ごとが新しい実行。agent が広まるほど inference の需要は何倍にもなる。これは速さと低コストを誰よりも渇望する顧客です
- Semiconductors (Logic)の相棒: inference チップは、AIの仕事のために設計されたロジックチップそのもの——このnodeを「AI需要のレンズ」で見るのに対し、Logicは業界全体のチップ製造技術のレンズで見る。同じものの二つの見方です
- Energy Transition & Power Demandから電力を吸い、Cloud & Digital Infrastructureに頼る: 毎秒のように起きる実行は電力を消費し続けます(回ごとに終わる学習とは違って)。だからワットあたりの効率が、このチップ群の主な売りになる。そしてこのnodeは、AIに速く答えてほしいRoboticsやBiotechの両方も「enables」します
05いま、どこまで来たのか
この戦場はいま熱く、しかも驚きが二層あります。一層目はグラフを突き破る速さの数字。専用チップは LLM を、単体のGPUより文字どおり桁違いに速く実行します——Groqは毎秒およそ300〜750 token、一般的なGPUの約100に対して。そしてCerebrasはウエハー規模のマシンで、大型のLlamaモデルにおいてユーザー1人あたり毎秒2,500 token超を叩き出します。d-Matrixも、自社プラットフォームはGPUシステムより速く、コストが低く、消費電力も何倍も少ないと主張しています。
二層目は本当の主役の多くがいまも非公開企業であること——Groq、SambaNova、d-Matrix はまだ株式市場に上場しておらず、個人投資家が直接買うことはできません。d-Matrix は2025年末にシリーズCで2億7,500万ドルを、企業価値20億ドルで調達したばかり。いっぽうウエハー規模チップの先駆者 Cerebras は、この群でいち早く株式市場へ踏み出した1社で、2025年の売上は約5億1,000万ドル(76%増)、OpenAIからの200億ドル超のコンピュート購入契約が後押ししています。
もう一方では、NVIDIAやAMDといった王者も黙って見ているわけではありません。両社とも inference 向けにチューンしたチップ/モデルを出しています——NVIDIAは長大なコンテキストの実行向けに設計した Rubin CPX を発表(2026年末投入予定)、AMDは Instinct ファミリー(MI350/MI400)を演算あたりのコストで勝負する選択肢として押し出し、OpenAI を戦略パートナーに迎えました。だから inference の戦場は「スタートアップ vs 巨人」だけではなく、誰もが入ってくる速さ・コスト・柔軟性という軸での競争なんです。
06未来——モデルが「たくさん考える」時代
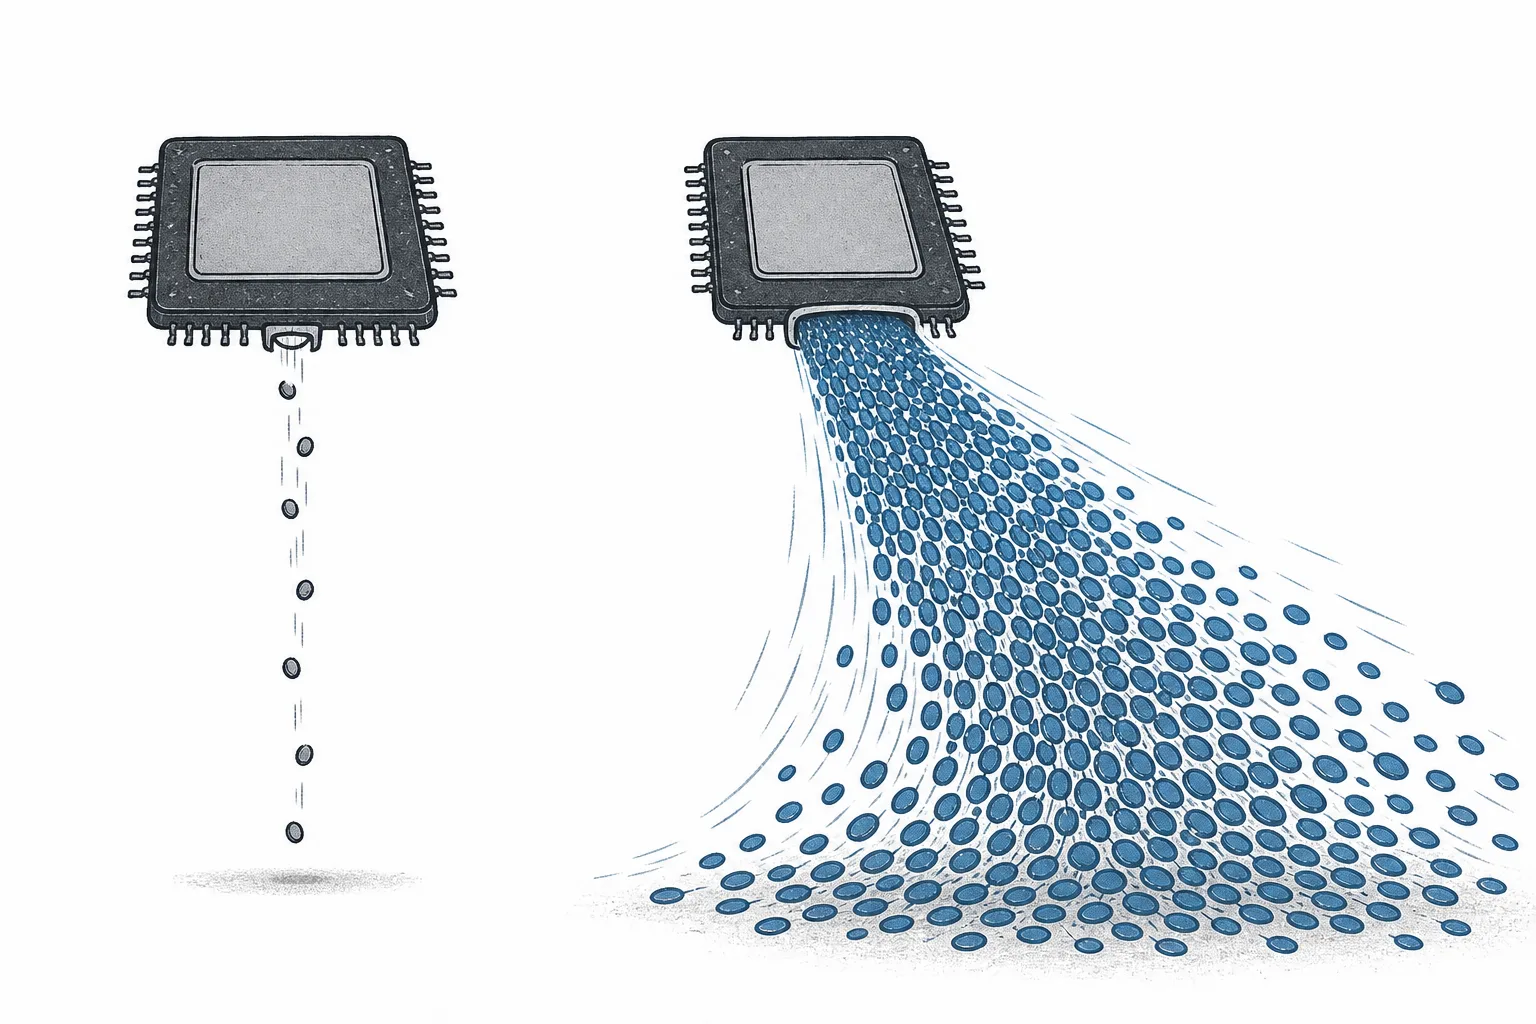
このnodeにとって最大の追い風は推論型モデル(reasoning models)です。新しい世代のモデルはすぐには答えず、答える前に段階を踏んで「頭の中で考え」ます——その頭の中の思考とは、ユーザーには見えない膨大な token を生み出すこと。結果、1つの質問が実行段階で前の世代のモデルより5〜10倍のコンピュートを食うこともあります(重い仕事ではエネルギー換算で70〜100倍に達することも)。だから inference の需要は、利用者数だけでなく「質問あたりの token 数」の急増に沿っても伸びていくんです。
一見矛盾しているようで実は補い合っているのが、token あたりの価格がとても速く下がっていることです。GPT-3.5級のモデルを実行するコストは、2022年末から2024年末にかけて280倍以上も下がりました——でも安くなるほど人はもっと使い、モデルはもっと考えるので、総利用量が価格の低下より速く伸びる。これが「AIコストのパラドックス」で、単価が下がってもAI企業のコンピュート請求書がふくらみ続ける理由——そして、誰もが最も安く実行できるチップを探し回る理由です。
二つ目の方向は実行が分散していくことです。すべての仕事が巨大なデータセンターで動く必要はありません——inference の一部は、低遅延とプライバシーのために利用者の近くへ移り始めています(Edge & On-device AI Siliconを参照)。これが、大きなGPUの届かない場所で、特に低消費電力なアーキテクチャが活躍する余地を開きます。
07課題とリスク
一つ目のリスクは王者も実行の戦場に降りてきていることです。多くの人は inference を NVIDIA の「弱点」だと思っていますが、実際には NVIDIA はすでに inference の仕事の大半を握っており、自分の陣地を守るためにチューン専用チップ(Rubin CPX など)まで出しています。いっぽうAMDも魅力的な総コストで追い上げてくる——だから inference スタートアップは、慣れ親しんだ「ソフトウェアのエコシステムから出る」ことに見合うだけ、十分に速く安くなければなりません。これはスライド上の速さの数字より越えるのが難しい壁です。
二つ目のリスクは目立つ主役の多くがいまも非公開企業であることです。Groq、SambaNova、d-Matrix はまだ株式市場におらず、一般の投資家が直接アクセスするのは難しい。そして顧客基盤をつくるためにまだ資金を燃やしている若い会社として、利益への道はこれから証明していく段階です——買収される会社もあれば、生き残れない会社もあるでしょう。「技術がすごい」ことが「事業が生き残る」ことを保証しない戦場です。
三つ目のリスクは少数の顧客への依存と、サイクルへの問いです。inference チップの大きな需要は、同時に巨額を投じる少数のAI企業とクラウドの巨人から来ています(Cerebras と OpenAI のあいだの巨大契約など)。もしAIからのリターンが想定より遅れたり、投資が鈍ったりすれば、尽きないように見えた需要も急速にしぼみかねません。そして顧客が少数に集中しているがゆえに、大型のディール1つを失うだけで会社全体が揺らぐこともあります。
ひとことで言えば:このnodeは、AIが最も頻繁にやる仕事——モデルを「実行」して実際の質問に何十億回も答えること——のために生まれたチップです。実行が大きくなり続け、モデルがますますたくさん考えるようになるほど、token あたり最も速く安く実行できる者が、AI経済全体を動かす大事な鍵の一つを握ることになります。